MiniCPM-V 4.7发布主视觉
一部手机、3GB内存、每秒13个以上token的解码速度——把这三个数字连在一起的,不是云端机房里的庞然大物,而是跑在iPhone 17 Pro Max本地的一份开源权重。它还顶着另一个身份:业界第一个跑进端侧、不损能力也不卡速度的开源MoE。
10月13日,面壁智能发布新一代端侧多模态模型MiniCPM-V 4.7,一次摆出35B-A3B和1B双规格,一高一低,正好把旗舰体验与入门设备两头都接住。随模型一起到位的还有两样东西——一套推理加速技术、一套开源微调方案,端侧落地的拼图这次基本凑齐。
发布要点汇总图
1.双规格分工:35B-A3B扛起旗舰大旗,是这个家族诞生的第一位MoE成员;1B继续压榨轻量极限,照顾低算力设备。
2.端侧成绩:iPhone 17 Pro Max上只占3GB内存,解码速度就有13+ token/s,数据全程不出本地。
3.生态与开发:iOS、安卓、鸿蒙三大系统,外加Intel、AMD和Arm,瑞芯微、后摩也在兼容名单,SRFT微调方案同步开源,端侧二次开发的工具链一次备齐。

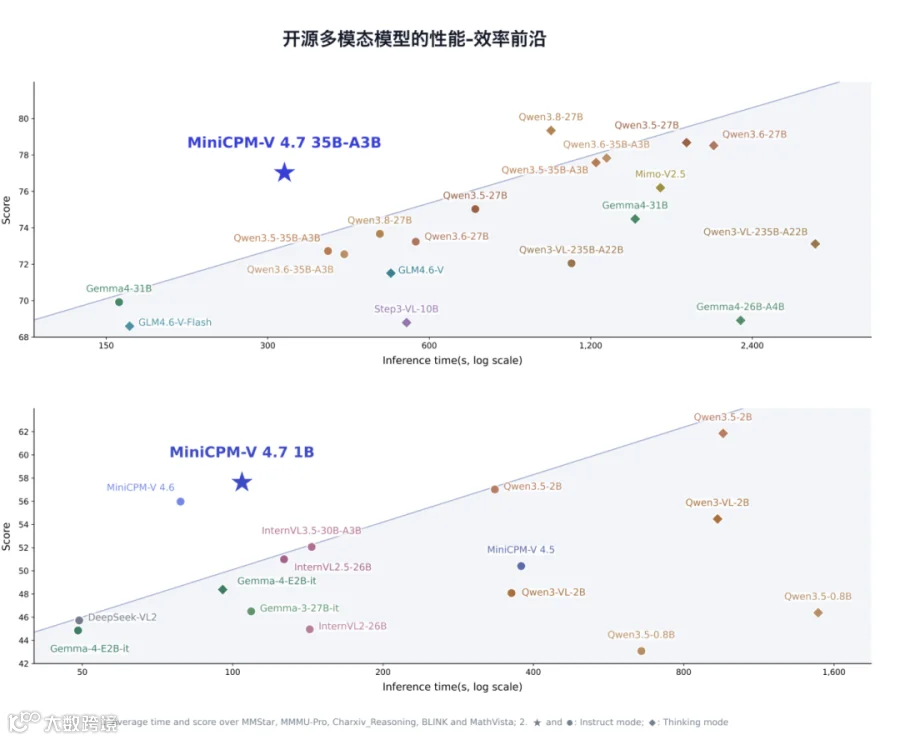
性能效率帕累托前沿图
先说难在哪。MoE(混合专家)的思路是养一支庞大的专家队伍,每位专家各管一摊,每次推理只点名其中一小部分上场——参数大的模型未必更慢,关键就看单步激活多少。代价同样明显:所有专家的权重都得常驻内存待命。以35B-A3B为例,总参数在350亿一级,名字里的A3B已在提示单步真正激活的量级约30亿;队伍很大,内存却要养着整支,手机端自然装不下,MoE此前基本被摁在云端机房里。
LES(前瞻专家调度)就是来拆这个僵局的。从名字能读出思路:不等当前这步算完才去取下一位专家,而是提前预判、提前调度,把等待权重的空转尽量藏进计算里。端侧设备的内存带宽本就金贵,每一次空等都是浪费;调度越前瞻,本地应答越接近速度上限。这步棋补上,350亿级的专家团才第一次在手机上跑顺,而且不牺牲精度。
3GB和13+ token/s合起来才是完整答案:前者解决装得下,后者解决跑得顺。顺带的收益也不止写在明面上——数据不出本地,隐私压力骤减;推理不绕云端,延迟不看网络脸色;再进一步,断网也能照常用。

35B-A3B综合性能评测对比
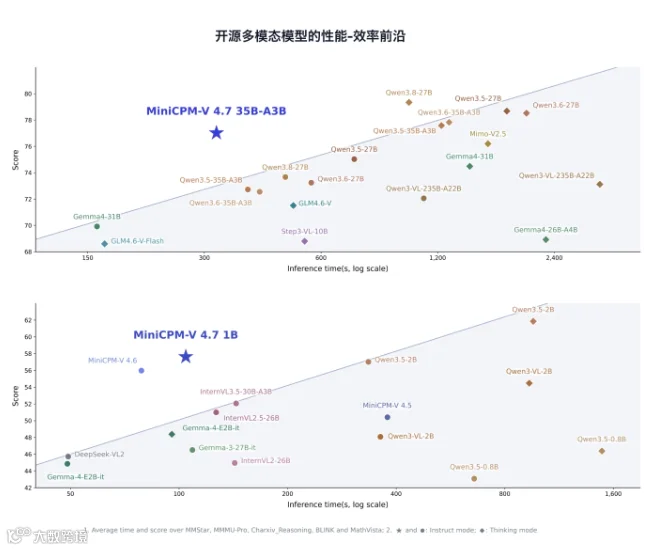
旗舰档的比拼很直接,而且这是同规格对位——同为35B-A3B量级,比的就是谁的效率曲线更陡:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
跑分高不算稀奇,耗时还更短,才是效率叙事真正的分量——同档对手还在慢工出细活,它已经先交卷,分还更高。
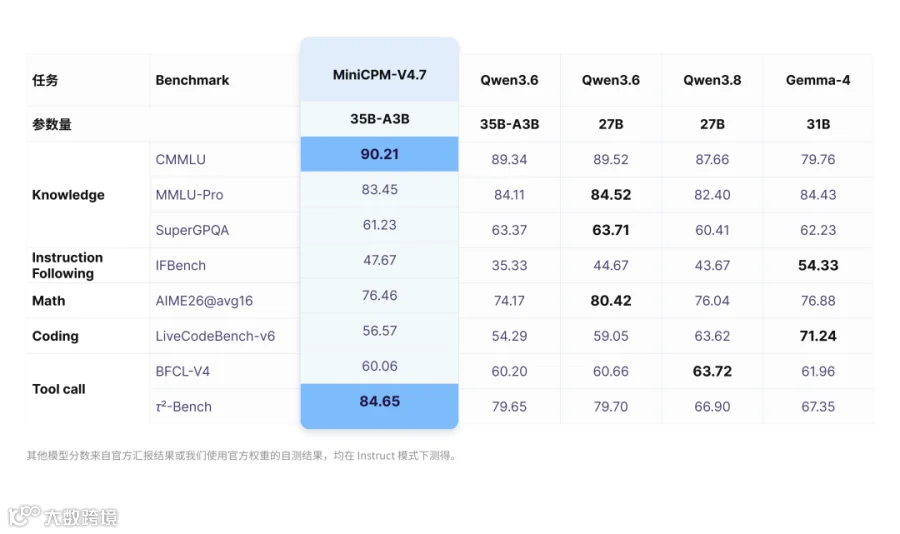
语言能力评测对比图
多模态成绩之外,语言能力的评测对比也随发布一并公开。底座稳,是端侧部署的前提——模型再轻,答非所问也白搭;语言这条线,没有被端侧化拖累。
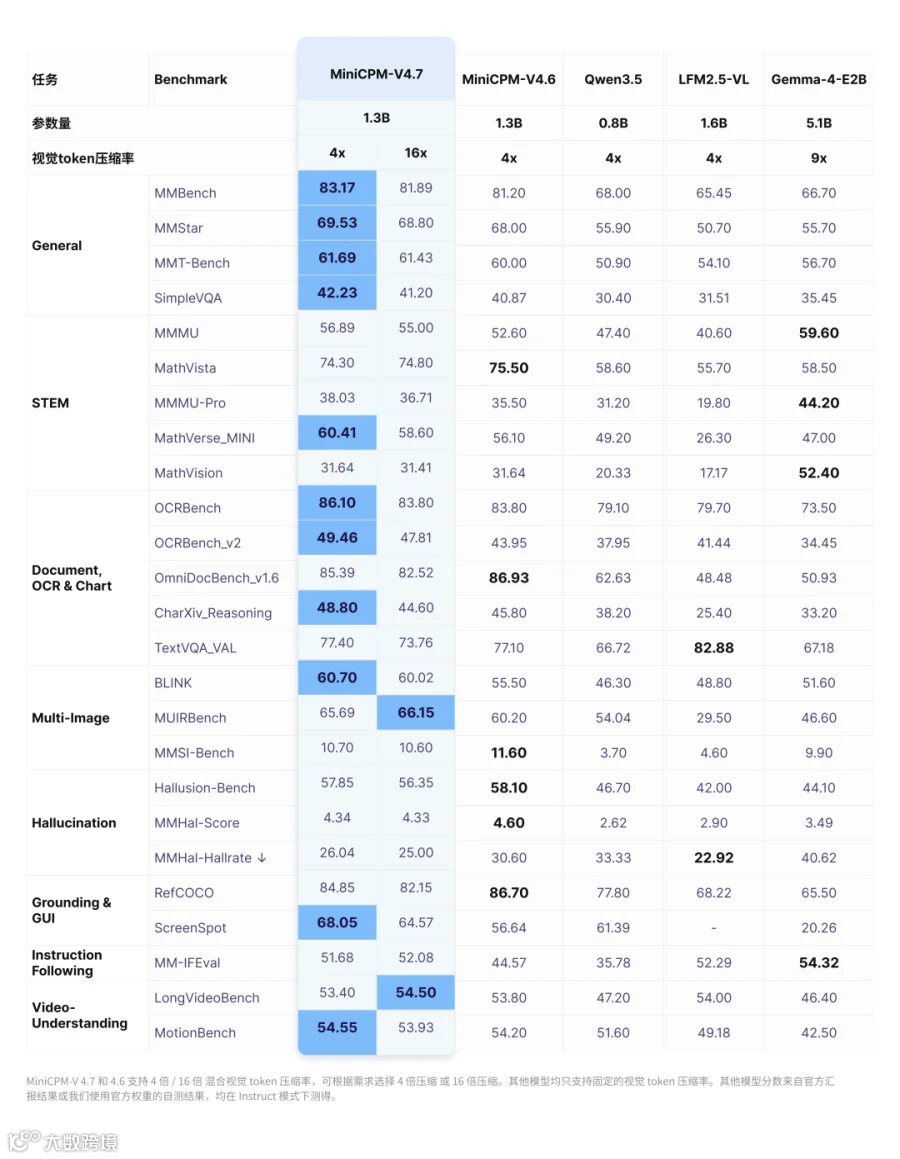
1B版本综合性能评测对比
轻量档的战况同样清晰:自家上代4.6的基础能力被继续拉开身位;对上Qwen3.5 0.8B,综合分与推理效率双双占优。小钢炮的迭代逻辑,依旧是寸土必争。当然,榜单只是参考——端侧的真实体验还要看具体机型的散热与功耗调度,数字之外,实机感受才算数。

AMD芯片平台Day 0端侧适配
系统一侧,iOS、安卓、鸿蒙三大移动生态全覆盖;芯片一侧,Intel、AMD和Arm之外,瑞芯微、后摩等国产平台也在兼容名单里。对用户,这意味着不必绑定某一部旗舰;对做硬件的厂商,多了一个现成的模型选择;对产业,端侧AI的落地不再押注单一硬件路线——换机时,也不用先问一句「这功能吃云还是吃本地」。
开发者这边还有一份同步开源的见面礼:SRFT微调方案(Self-Replay Fine-Tuning),主打两件事——用更低的成本扩展新能力,同时抑制旧能力的遗忘。对想做垂直场景应用的团队,省下的是实打实的算力账单;端侧个性化改造的门槛,又低了一截。
端侧模型的竞赛,正在从「谁更小」转向「谁又小又能打」。大模型MoE化、手机本地跑,这两件事组队的门槛又被垫低了一级,多模态从旗舰机的专属演示走向日常标配,中间大概只隔着几代迭代。模型与微调方案均已开源,感兴趣的话,不妨自己上手跑一跑。