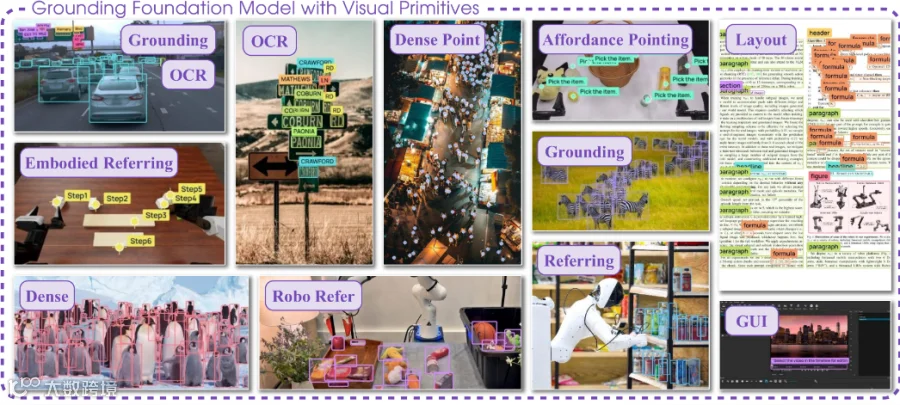
输入一张图加一句话,输出目标在哪——点和框。以前VLA和世界动作模型都拿通用VLM、视频生成骨干当眼睛,现在有人专门为"看得准"训了一个基座。
机器人抓不准杯子、自动驾驶认不清路牌,问题往往不在动作模块,而在感知:VLA(vision-language-action)和WAM(world-action model)普遍拿通用视觉语言模型或视频生成骨干当视觉来源,这些骨干从头到尾没为"精确定位"优化过。密集场景和小目标上,Qwen3.5系列会挣扎,连GPT-6 Astra也有明显余量;更麻烦的是,稀缺的机器人动作数据得同时负责学感知和学控制。
小鹏汽车(XPeng Inc.)联合北京大学、香港大学、清华大学、UC Berkeley、普林斯顿、NUS、港科大(广州)推出GroundingPI,一个4B的定位基座模型。架构是MoonViT-V2(Kimi K3)视觉编码器加Qwen3-4B语言解码器,把点和框量化成0–999的1000个坐标token塞进共享词表,检测、指代、指向、OCR、GUI、文档版面、视觉提示七类任务全部统一成语言条件下的结构化生成。预训练吃掉221B tokens,再过一遍SFT和GRPO。
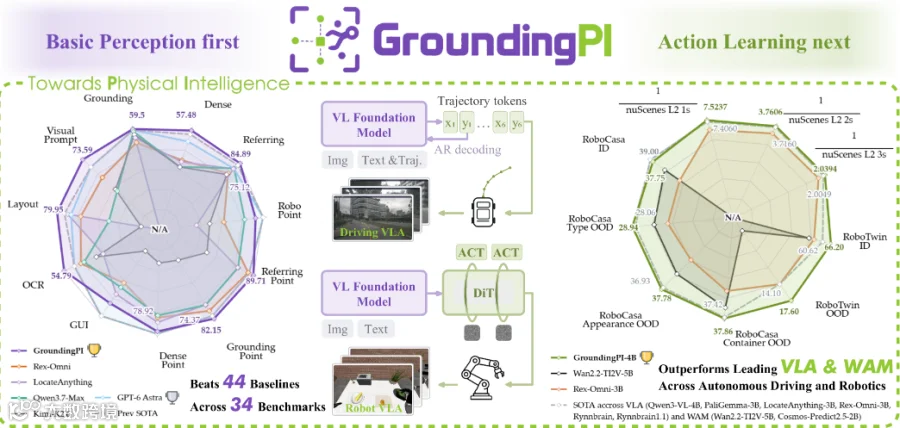
在34个基准、11项感知能力、44个基线的对比里,GroundingPI平均73.68%,高于更大的GPT-6 Astra(71.54%)。更重要的是迁移:把动作专家、动作数据、训练预算全部固定,只换视觉骨干,GroundingPI在RoboTwin 2.0 Full拿到66.20%成功率,四个分布外设定全部第一,最高相对提升24.8%;在RoboCasa-GR1上用50%的演示量超过所有基线用75%的效果;nuScenes开环L2误差0.296米。代码和权重已开源,权重9.81GB,单张24GB卡放得下。
相关链接
-
论文:https://arxiv.org/abs/2609.39601 -
代码:https://github.com/groundingpi/GroundingPI -
主页:https://groundingpi.github.io/ -
模型权重:https://huggingface.co/GroundingPI/GroundingPI
内容介绍
GroundingPI是一个4B的定位基础模型:给一张图和一个语言查询,输出目标类别加坐标,查不到就输出None。
与Rex-Omni、LocateAnything这类定位专家模型不同,它的目标不是把某一个定位任务刷到极致,而是把"精确定位"做成一个可迁移的感知底座,供下游的机器人操作和自动驾驶直接换装。核心卖点有三个:
-
一套词表打全部任务:1000个量化坐标token与语义标签共享输出头,检测、指代、指向、OCR、GUI、版面、视觉提示不需要各自的解码器。 -
感知原生而非事后补:π0到π0.5的做法是在动作训练里加边界框预测当辅助任务,GroundingPI反过来,先在预训练里把定位学透,动作数据只负责教"怎么动"。 -
迁移有实锤:在固定下游配方下换骨干对比,六个操作设定里五个第一,四个OOD设定全胜。
适用场景:机器人操作的视觉骨干替换、自动驾驶开环轨迹预测、密集小目标检测与计数、文档与GUI信息抽取、具身数据标注。
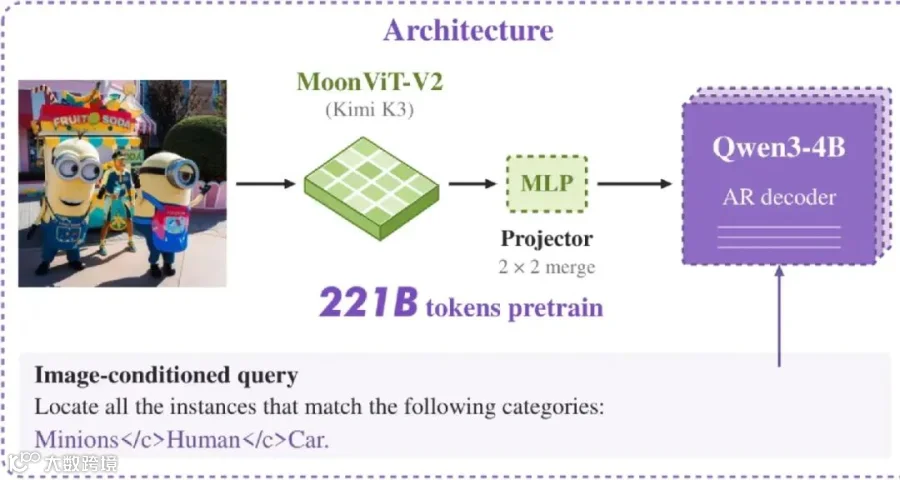 MoonViT-V2编码图像,projector做2×2合并后接入Qwen3-4B自回归解码器,预训练共221B tokens。
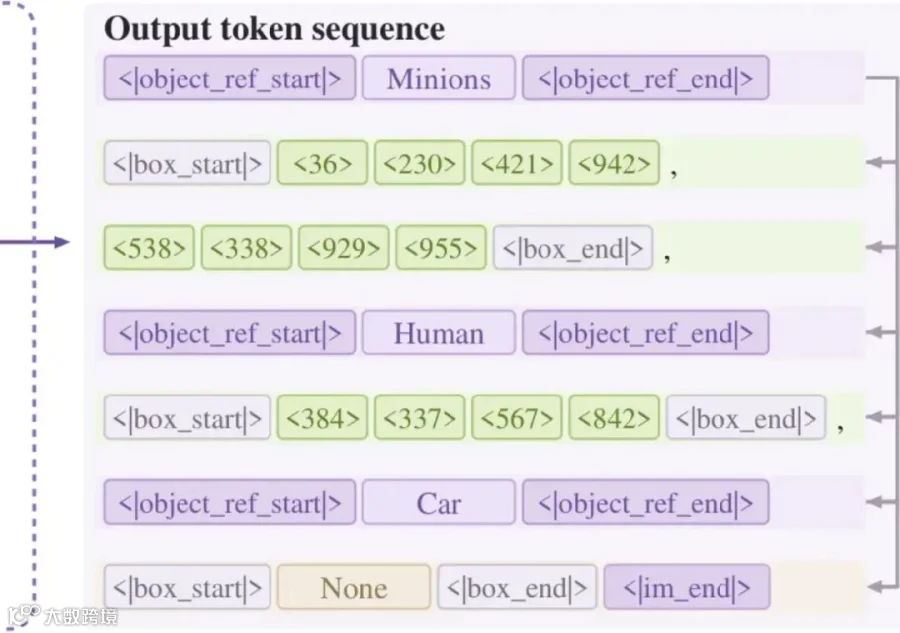 查询要求定位Minions、Human、Car三类。前两类各输出一组量化坐标框,图中没有Car,模型输出None并结束。
方法概述
一套机制管"怎么表示位置",一套机制管"怎么把定位学扎实",再加一套固定配方的下游接法。
1. 视觉原语统一接口(visual primitives)
坐标不再走文本,而是词表里的原子token。tokenizer在151,669的基础词表上加了1000个坐标token(<0>–<999>)和一个类别分隔符,共152,670项;输入嵌入与输出头不共享权重,语义、结构和坐标token由同一个输出头预测。效果直接体现在序列长度上:COCO上每个框平均7.6个token,Dense200上5.1个,而SEED1.5-VL分别是148.8和74.5,差一个数量级。消融里,量化坐标把平均分从71.21拉到73.68,换成文本坐标则相对速度只剩0.25倍。整套模型4.844B参数,其中视觉编码器401M、projector 27M、语言解码器3.63B、输入嵌入和输出头各390.8M。
2. 数据引擎(data engine)
监督来自公开数据集加自建引擎。引擎把多个教师模型对定位、分割、文字、GUI元素、文档区域的预测在字段级融合:语义和几何分开处理,验证过的保留,冲突的触发补充证据;物体-部件包含、词-行层级这类关系会被保留而不是当成重复合并。通过校验的标注反过来训练一个统一的定位专家做迭代标注,不确定的样本用互补教师和局部观测补齐。
3. 三段训练(预训练→SFT→GRPO)
预训练分三步:先冻结两个骨干只用图文对齐projector,再全参联合多模态预训练,最后用问答和描述补通用视觉与视频理解。SFT负责坐标对齐和输出协议,先全参更新,再冻结视觉编码器和projector做语言侧精修。最后是GRPO强化:每个图-查询对采8条回答,定位任务的奖励由两部分组成——集合完备度R_set按参考框最大IoU匹配并校验类别,严格定位R_strict组合多阈值F1、定位、格式、数量与排序并惩罚重复框和过大框,优势按0.7比0.3加权标准化;OCR任务用匈牙利一对一匹配同时评价文本和几何。整个RL阶段冻结SFT参考模型,只更新语言参数。
 Stage 1用token级交叉熵学结构化输出;Stage 2用GRPO,定位奖励平衡覆盖与严格定位,OCR奖励评价文本与几何一致性。
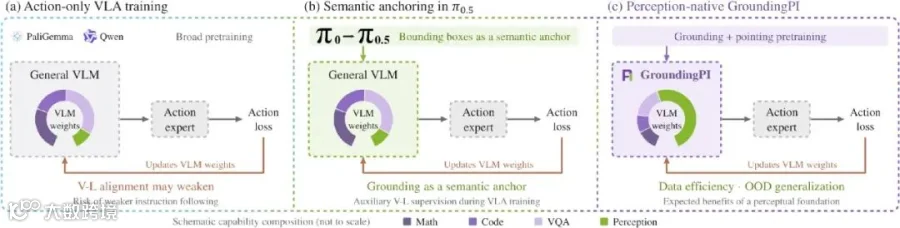 从(a)动作训练顺带学感知,到(b)π0.5把边界框当语义锚,再到(c)GroundingPI把定位做成预训练原生的基座能力。
4. 下游怎么接
两条路径,各自保留原有的动作学习器。自动驾驶把nuScenes的开环轨迹预测改写成语言条件生成:前视摄像头加历史自车状态,输出未来3秒、每0.5秒一个共6个有序路点,坐标映射到既有的0–999词表。机器人操作走π风格的flow-matching策略加StarVLA式分层连接:骨干前向一次,中间层特征投影重采样后注入Action DiT对应的cross-attention层。对比时Action DiT架构、动作数据、优化预算、推理流程全部固定,只换预训练骨干,四个家族共八个模型:通用VLM(Qwen3-VL-4B、PaliGemma-3B)、视频生成骨干(Wan2.2-TI2V-5B、Cosmos-Predict2.5-2B)、定位模型(LocateAnything-3B、Rex-Omni-3B)、具身基座(RynnBrain、RynnBrain1.1)。
实验结果
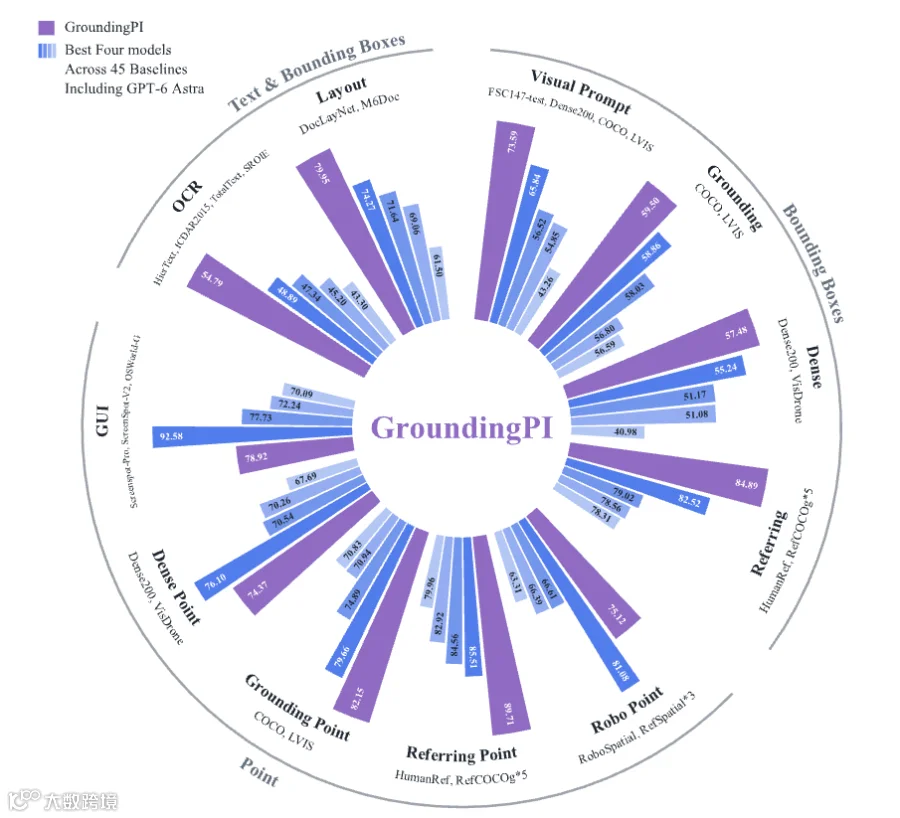
评测口径:自家结果为10次运行平均(5个随机种子各2次),本地评测的基线为3次平均,GPT-6 Astra的thinking effort设为High。框定位和OCR用F1mIoU,指向用F1@Point,空间与GUI用任务准确率。头条平均分是11项能力得分的算术平均。
检测与指代
|
|
|
|
|
|
|
|---|---|---|---|---|---|
| GroundingPI(4B) | 62.98 | 74.53 |
|
88.56 | 83.92 |
|
|
|
|
|
|
|
|
|
|
|
41.59 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Dense200是密集小目标专项基准,Qwen3-VL-4B只有14.02,GroundingPI到74.53。VisDrone一列GroundingPI不是第一:Qwen3.7-Max的41.59和SenseNova-Vision的42.35都在它之上。COCO上对Astra的优势只有0.23。
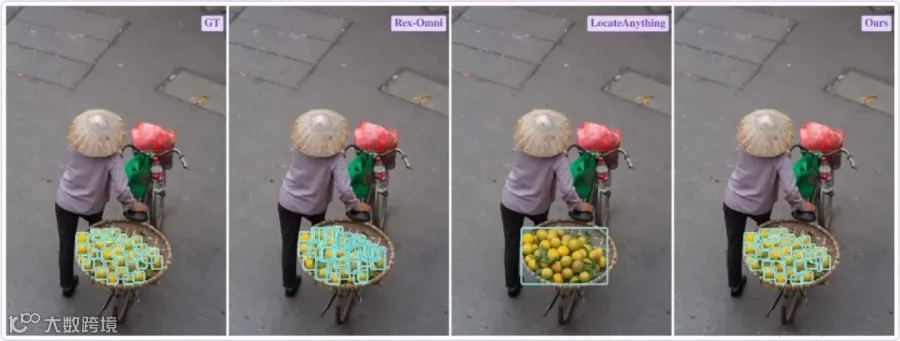 同一辆推车上的密集水果:GT、Rex-Omni、LocateAnything与GroundingPI(最右)。
空间与GUI
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
| GroundingPI(4B) |
|
|
73.77 |
|
|
|
|
|
85.93 | 81.93 |
|
93.17 | 97.88 | 86.70 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
这一组是分界线:在小于10B的同级模型里GroundingPI全面领先,但对Astra只剩RoboSpatial一项反超。ScreenSpot-Pro上65.78对93.17,差距接近28个点。
OCR与文档版面
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
| GroundingPI(4B) |
|
55.68 |
|
72.47 |
|
74.82 |
|
|
|
|
53.55 |
|
|
|
|
|
42.95 |
|
|
|
|
|
|
|
|
|
|
|
85.53 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
SROIE上72.47对Astra的53.57,M6Doc上74.82对60.59,这两项拉开明显差距。TotalText输给Astra,DocLayNet被SenseNova-Vision以85.53微弱压过,HierText输给Qwen3.7-Max。
指向
七列里六列第一:HumanRef 88.79、RefCOCOg val 90.26、RefCOCOg test 90.06、COCO 84.79、LVIS 79.51、VisDrone 67.47,均为全场最高;Dense200一项81.27输给Astra的86.57——框定位强不代表点选得准,点选和边界精度是两个问题。
迁移到物理智能
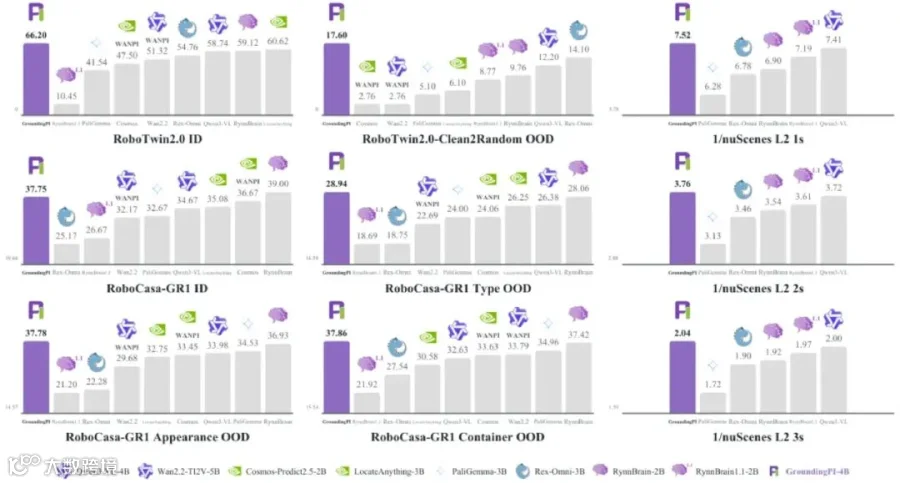 紫色为GroundingPI-4B。六个操作设定里五个第一,四个OOD设定全部第一;nuScenes三个时距都是小幅领先。
|
|
|
|
|---|---|---|
|
|
66.20% |
|
|
|
17.60% |
|
|
|
|
RynnBrain 39.00%,此项目前唯一落败 |
|
|
|
|
|
|
0.296m |
|
四个OOD设定的最高相对提升是24.8%。要注意这个口径:是相对最强基线的相对提升,且只在RoboTwin 2.0上成立。
数据效率
RoboCasa-GR1上把演示量压到25%、50%、75%,GroundingPI在三个缩减档全部领先。关键数字:50%数据拿到28.75%,高于所有基线用75%数据的结果——其中最强的RynnBrain在75%数据下是27.75%。
消融:哪种感知在迁移
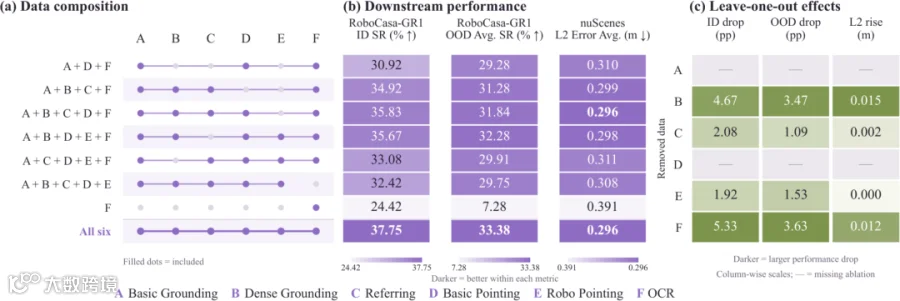
图7:数据配比的留一消融 六组监督的任意剔除对比。B是Dense Grounding,F是OCR。
-
密集定位是空间核心:去掉Dense Grounding,操作成功率掉4.67/3.47个百分点,nuScenes L2上升0.015米,是三列里最大的一格。 -
OCR像个催化剂:去掉含OCR的组,操作掉分最多(5.33/3.63个百分点),但只用OCR训又迁移得最差(单独F组ID只有24.42%)。论文自己的说法是假设——尖锐字符边界逼出局部精度,转写把视觉区域绑到语义上,等价于一个局部描述代理任务。 -
没有任何缩减配方能同时保住操作和定位:全量六组在两个任务上都是最好(ID 37.75%、OOD 33.38%、L2 0.296米)。 -
规模也有效:预训练从88.4B tokens加到221B,定位分数和操作成功率同步上升,泛化曲线跟得最紧。 -
视觉编码器:MoonViT-V2 73.68 > MoonViT 73.17 > Qwen3-ViT 71.65。去掉RL(Stage III)降到72.86。
局限与未来方向
首先,73.68%的平均分不是全面碾压。COCO在IoU 0.95下的F1只有22.84,低于多个基线,严格边界定位仍是短板;TotalText、FSC147视觉提示、frontier级GUI(ScreenSpot-Pro差Astra近28个点)都有明确缺口;VisDrone和DocLayNet分别被SenseNova-Vision压过,HierText输给Qwen3.7-Max。
其次,有两处结论要打折看。驾驶只测了开环,论文自己说这不构成闭环性能或部署上限的证据;数据效率只在操作任务上验证过,驾驶侧没测。OCR的因果性和RynnBrain1.1退步背后的架构机制(门控记忆、多层视觉注入)都还是假设,没有做匹配干预实验。骨干对比虽然固定了下游配方,但各骨干的规模、架构和监督本来就不一样。
此外,评测口径里有提示词和解析器兼容性限制,基线不支持的任务标为N/A,这不算该模型没有那种能力。还有一个容易被忽略的声明:小鹏在论文里明确写了,公司对研究的支持不构成对任何商业应用的背书,论文的结论不代表小鹏的官方技术方向、产品路线图或商业承诺。
结论
GroundingPI验证了一件事:给物理智能单独配一个感知基座,比让动作数据顺带学感知更划算——4B的模型在定位平均分上压过了万亿参数的GPT-6 Astra,并且在换装到机器人和驾驶后真能提分、真能省数据。
对于做VLA和机器人操作的人,最直接的用法是拿它替换Qwen3-VL这类通用骨干试一轮:权重9.81GB,单张24GB卡放得下,接入走StarVLA式的分层注入,官方未公布推荐显存,实测前别按A6000的48GB预算报。对于做OCR、GUI和文档解析的人,它在SROIE和M6Doc上值得试,但ScreenSpot-Pro这类frontier级GUI任务别指望它替代专用模型。对于关注具身智能路线的人,这篇真正有意思的不是分数,而是它和GroundAnything 一起,把"感知"从动作训练的辅助任务拆成了独立的预训练目标。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~