

实时语音交互,并不是把语音识别、语言模型和语音合成简单串起来。人与人的交流通常不是严格的“一问一答”:说与听常常交织在一起,人们会在说到一半时补充或改变想法,也会在对方回应时插话。此外,同样一句话,随着语气、情绪、双方关系和上下文的变化,可能表达不同的含义。自然的交流,既需要听懂内容,还要理解言外之意,知道何时接话、何时等待,以及怎样做出合适的回应。
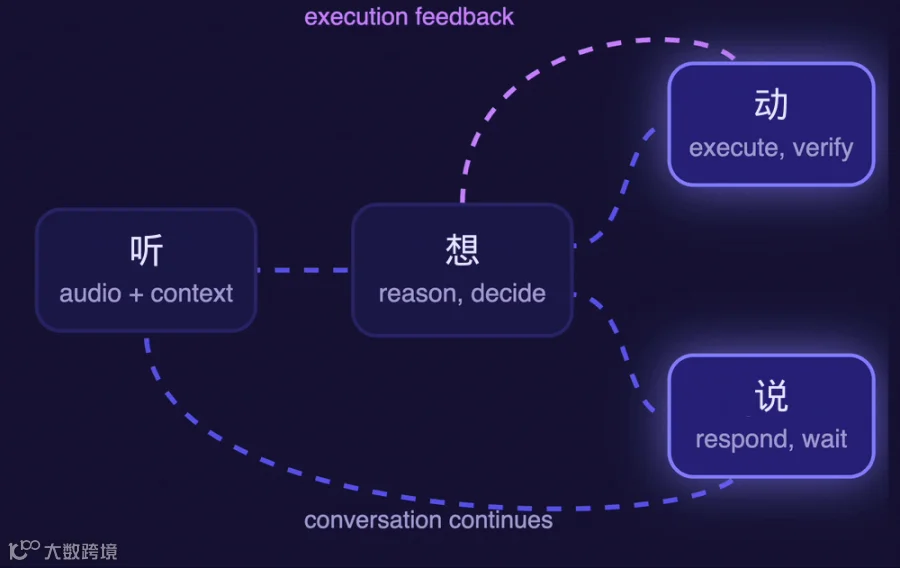
全新升级的 Qwen-Audio-3.1-Realtime,围绕这些真实交流中的细节,进一步提升模型在多语言语音推理、多轮对话、共情表达以及全双工交互方面的能力。通过“听、想、说、动”的协同,模型能在说话的同时持续接收用户输入,结合语境处理插话、打断与话轮转换,让回应更加自然、贴切;也能在需要时调用 Agent 工具完成任务,让对话与执行同步展开。听得更懂、更会接话、更懂共情,也更能提供实际帮助,为用户带来更自然流畅的实时交互体验。
技术报告:https://arxiv.org/abs/2609.25176
项目主页:https://qwenaudio.github.io/qwen-audio-3.1-realtime/
Voice Agent Harness:https://github.com/QwenAudio/qwen-audio-agent
▎交互架构与模型结构:边听、边想、边说、边动
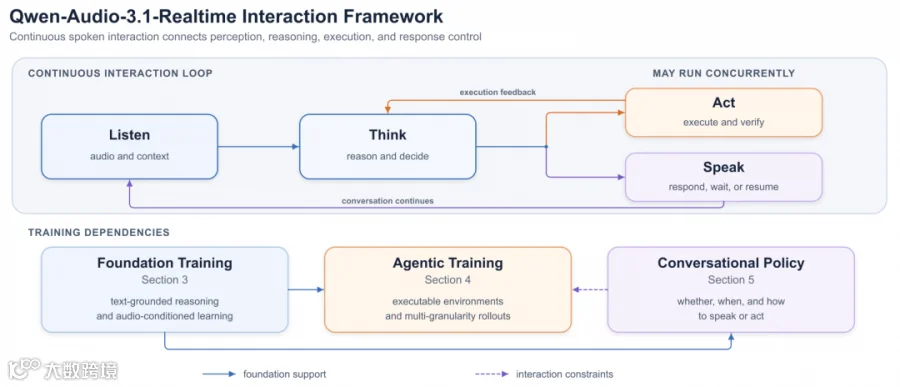
(图 1:Qwen-Audio-3.1-Realtime 整体交互架构与关键模块示意图)
(图 1:Qwen-Audio-3.1-Realtime 整体交互架构与关键模块示意图)
Qwen-Audio-3.1-Realtime 让实时语音交互真正实现了“边听(Listen)、边想(Think)、边说(Speak)、边动(Act)”的持续交互回路。模型在持续接收音频输入的同时解析意图与上下文,在后台调度工具并核验执行状态,在前台实时判断说话、等待或恢复的时机。这里的精妙之处在于彻底打破了线性的时序依赖,让行动与表达并行交织展开——工具的异步反馈与用户随时插进来的新输入,会即时汇入这一回路并参与后续决策,驱动整套交互连贯运转。
图1的下半部分展示了支撑自然交互范式的三大核心能力:
基础模型训练建立语言推理与音频理解能力。
Agentic Training(智能体化训练)通过可执行环境与多粒度交互轨迹,让模型掌握工具使用和任务完成能力。
全双工对话策略训练让模型学会是否、何时以及如何说话或行动,统筹协调模型行为——调用工具前是否需要说明、什么时候需要发起确认、执行过程中如何汇报进展,都需要兼顾行动决策与对话表达。
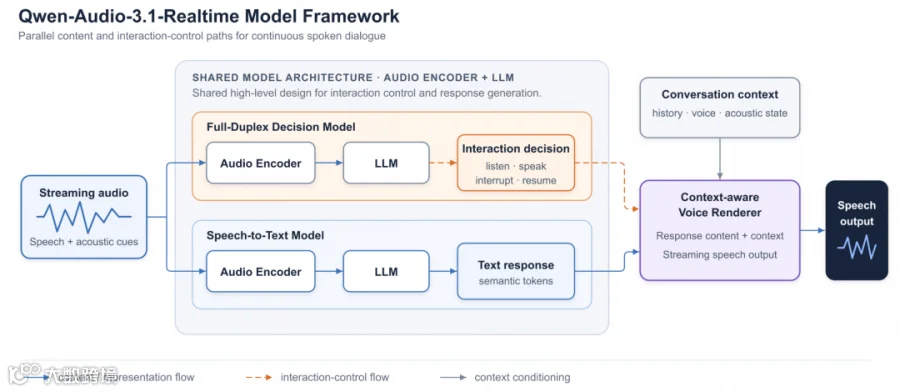
(图 2:Qwen-Audio-3.1-Realtime 模型结构示意图)
模型层面,用户的语音输入会进入“行为控制”和“回复生成”两条链路:
全双工决策模型负责交互控制,结合音频、历史与系统状态,决定继续倾听、开始说话、停止播报或恢复播报。
Speech-to-Text 模型负责回复生成,从语音输入生成文本回复。这里的 Speech-to-Text 并非只做转写,而是承担语音理解后的内容生成。
上下文感知的语音渲染模块(Context-aware Voice Renderer)接收回复内容,并结合对话历史、声音线索与声学上下文生成流式语音。全双工决策则控制语音何时开始、停止或恢复。因此,最终输出不仅取决于准备说什么,也取决于当前是不是合适的说话时机。
▎后训练方法:迁移语言能力,拓展原生音频能力
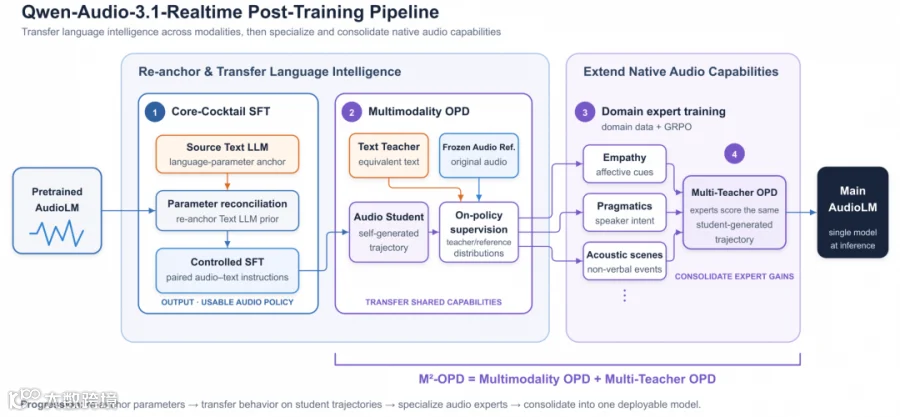
(图 3:Qwen-Audio-3.1-Realtime 后训练工作流示意图)
整个流程从预训练 AudioLM 出发,首先通过 Core-Cocktail 监督微调(SFT)建立可用的音频策略。该阶段以文本模型为语言参数锚点,对 AudioLM 与文本模型的共享语言参数进行重新协调,并使用音频与文本数据共同进行监督微调,让模型在适应语音输入的同时,保留已有的语言知识和推理能力。
多模态在线策略蒸馏(Multimodality OPD)负责跨模态能力迁移。音频学生模型先根据音频输入生成自己的回答轨迹;文本教师模型读取对应的文本输入,冻结的 Audio Reference 接收原始音频,二者都沿着学生已经生成的同一前缀提供逐 token 监督。文本教师提供知识、推理、指令与工具决策等语言侧能力,Audio Reference 则提供音频条件下的参考。学生学习的不是一份预先写好的标准答案,而是在自己生成路径上的决策方式。
仅靠转写文本难以完整保留情绪、语用意图和非语言声学事件信息。为此,我们先通过领域数据与 GRPO 训练相应的音频专家,再通过多教师在线策略蒸馏(Multi-Teacher OPD)整合各领域专家能力:主 AudioLM 根据音频生成自己的回答轨迹,相关专家接收相同的音频上下文与生成前缀,提供逐 token 的概率分布监督,将领域专长内化进主模型。
▎自进化环境:从工具调用到可靠完成任务
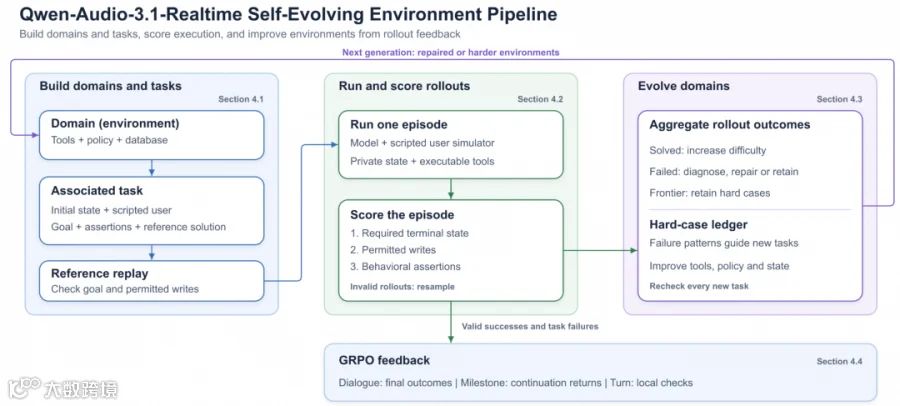
(图 4:Qwen-Audio-3.1-Realtime 自进化环境构建管线示意图)
生成一个格式正确的工具调用,只是完成任务的第一步。模型还需要理解不断变化的要求,根据工具反馈调整行动,并遵守业务规则。即使工具调用成功,如果最终状态不对,或者执行过程越过了权限边界,任务仍然不能算完成。
构建环境与任务。系统以开源工具和 MCP 服务定义为种子,构建包含工具、业务规则和数据库的可执行环境,并生成关联任务。正式交互前,通过回放参考解法,验证任务是否可执行,并确定允许修改的状态范围。
执行并评分。模型与用户模拟器在独立的任务状态中进行多轮交互,工具返回实际执行结果或错误。评分依次检查最终状态是否达标、写入是否合规,以及确认、核验和进展表达是否满足行为要求。
根据反馈演化环境。对稳定解决的任务增加难度,对持续失败的任务诊断并修复环境缺陷,或保留暴露模型弱点的有效任务;接近能力边界的案例则指导后续任务生成。
多粒度 GRPO 反馈。有效轨迹为 GRPO 提供对话级、里程碑级和轮次级反馈,分别比较完整任务的最终结果、从相同中间状态出发的不同后续执行结果,以及单轮回复与工具决策,将任务完成与局部行为的学习结合起来。
▎持续语音 Agent:前台保持对话,后台持续执行
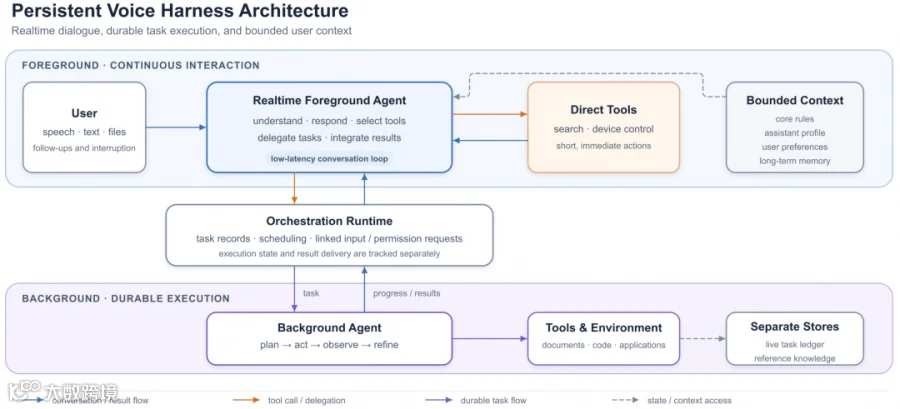
(图 5:Qwen-Audio-3.1-Realtime 全时前后台语音交互示意图)
持续交互的前台系统(图上半部分)。 实时交互前台(Qwen-Audio-3.1-Realtime)支持语音、文本、文件等输入,在维护流式会话的同时,可直接调用工具完成搜索、设备控制等低延迟操作;对于复杂任务,前台将其委派至后台,后续的执行进展与结果则会无缝回流至当前会话中。
异步编排后台,长程任务解耦(图下半部分)。 前台提交明确的目标、约束与关联输入,编排运行时创建持久化任务记录,并返回受理事件,使前台可以继续交流。后台 Agent 则在专属环境中自主进行“规划—执行—观察—修正”闭环;执行过程中的阶段进展、上下文追加、权限审批及最终结果均与该任务锚定,并通过运行时按序同步给实时前台。
分工原则与安全边界。依任务性质而非调用次数划分——即时闭环留在前台,重计算、重探索工作剥离至后台。核心规则、人设画像与个人记忆分层注入。将任务台账作为执行状态的唯一事实源,且严守安全底线:任何角色设定与历史记忆均无权逾越工具权限与安全红线。
▎异步协同:跨多轮长程任务执行
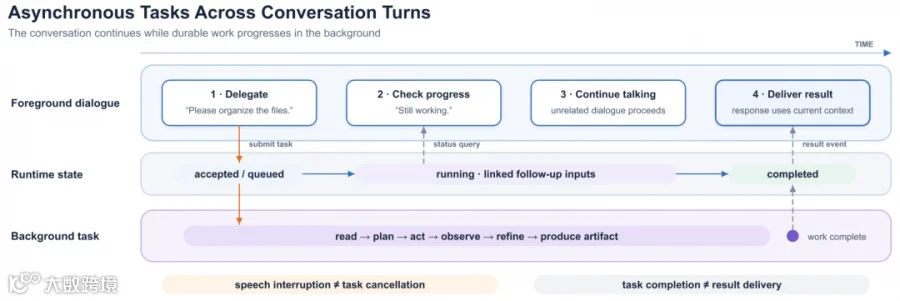
(图 6:跨轮次异步任务执行工作流示意图)
Voice Harness 框架中,前后台分工解决了“由谁执行”,异步任务周期管理则解决了“任务进行到哪里,以及何时把结果告诉用户”。后台任务可以跨越多轮语音交互,用户委派工作后,仍可随时插话查询进度、追加条件,或切入其他闲聊话题;待后台任务执行完毕后,系统再结合当下的实时对话语境,交付结果。
此外,受理事件只表示任务提交成功,不意味着执行已经开始或完成。运行时记录排队、运行、完成、失败或取消等状态,并将后续补充和权限请求关联到原任务,使助手能够依据实际记录汇报进展,而不是仅凭对话内容推测。
打断语音播报不等于取消后台任务,后台任务完成也不等于结果已经送达。 用户插话时,当前播报可以停止,但任务仍可继续运行;结果生成后,也可以等待合适的对话时机再交付。即使结果播报被打断,已经完成的工作也不会因此失效。
▎基准评测:多项核心能力领跑
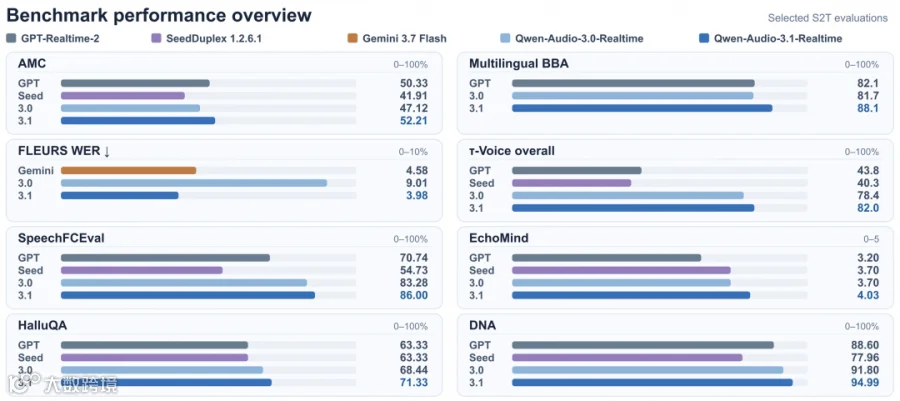
(图 7:模型在多项核心能力基准评测中的结果)
(图 2:Qwen-Audio-3.1-Realtime 模型结构示意图)
模型层面,用户的语音输入会进入“行为控制”和“回复生成”两条链路:
全双工决策模型负责交互控制,结合音频、历史与系统状态,决定继续倾听、开始说话、停止播报或恢复播报。
Speech-to-Text 模型负责回复生成,从语音输入生成文本回复。这里的 Speech-to-Text 并非只做转写,而是承担语音理解后的内容生成。
上下文感知的语音渲染模块(Context-aware Voice Renderer)接收回复内容,并结合对话历史、声音线索与声学上下文生成流式语音。全双工决策则控制语音何时开始、停止或恢复。因此,最终输出不仅取决于准备说什么,也取决于当前是不是合适的说话时机。
▎后训练方法:迁移语言能力,拓展原生音频能力
(图 3:Qwen-Audio-3.1-Realtime 后训练工作流示意图)
整个流程从预训练 AudioLM 出发,首先通过 Core-Cocktail 监督微调(SFT)建立可用的音频策略。该阶段以文本模型为语言参数锚点,对 AudioLM 与文本模型的共享语言参数进行重新协调,并使用音频与文本数据共同进行监督微调,让模型在适应语音输入的同时,保留已有的语言知识和推理能力。
多模态在线策略蒸馏(Multimodality OPD)负责跨模态能力迁移。音频学生模型先根据音频输入生成自己的回答轨迹;文本教师模型读取对应的文本输入,冻结的 Audio Reference 接收原始音频,二者都沿着学生已经生成的同一前缀提供逐 token 监督。文本教师提供知识、推理、指令与工具决策等语言侧能力,Audio Reference 则提供音频条件下的参考。学生学习的不是一份预先写好的标准答案,而是在自己生成路径上的决策方式。
仅靠转写文本难以完整保留情绪、语用意图和非语言声学事件信息。为此,我们先通过领域数据与 GRPO 训练相应的音频专家,再通过多教师在线策略蒸馏(Multi-Teacher OPD)整合各领域专家能力:主 AudioLM 根据音频生成自己的回答轨迹,相关专家接收相同的音频上下文与生成前缀,提供逐 token 的概率分布监督,将领域专长内化进主模型。
▎自进化环境:从工具调用到可靠完成任务
(图 4:Qwen-Audio-3.1-Realtime 自进化环境构建管线示意图)
生成一个格式正确的工具调用,只是完成任务的第一步。模型还需要理解不断变化的要求,根据工具反馈调整行动,并遵守业务规则。即使工具调用成功,如果最终状态不对,或者执行过程越过了权限边界,任务仍然不能算完成。
构建环境与任务。系统以开源工具和 MCP 服务定义为种子,构建包含工具、业务规则和数据库的可执行环境,并生成关联任务。正式交互前,通过回放参考解法,验证任务是否可执行,并确定允许修改的状态范围。
执行并评分。模型与用户模拟器在独立的任务状态中进行多轮交互,工具返回实际执行结果或错误。评分依次检查最终状态是否达标、写入是否合规,以及确认、核验和进展表达是否满足行为要求。
根据反馈演化环境。对稳定解决的任务增加难度,对持续失败的任务诊断并修复环境缺陷,或保留暴露模型弱点的有效任务;接近能力边界的案例则指导后续任务生成。
多粒度 GRPO 反馈。有效轨迹为 GRPO 提供对话级、里程碑级和轮次级反馈,分别比较完整任务的最终结果、从相同中间状态出发的不同后续执行结果,以及单轮回复与工具决策,将任务完成与局部行为的学习结合起来。
▎持续语音 Agent:前台保持对话,后台持续执行
(图 5:Qwen-Audio-3.1-Realtime 全时前后台语音交互示意图)
持续交互的前台系统(图上半部分)。 实时交互前台(Qwen-Audio-3.1-Realtime)支持语音、文本、文件等输入,在维护流式会话的同时,可直接调用工具完成搜索、设备控制等低延迟操作;对于复杂任务,前台将其委派至后台,后续的执行进展与结果则会无缝回流至当前会话中。
异步编排后台,长程任务解耦(图下半部分)。 前台提交明确的目标、约束与关联输入,编排运行时创建持久化任务记录,并返回受理事件,使前台可以继续交流。后台 Agent 则在专属环境中自主进行“规划—执行—观察—修正”闭环;执行过程中的阶段进展、上下文追加、权限审批及最终结果均与该任务锚定,并通过运行时按序同步给实时前台。
分工原则与安全边界。依任务性质而非调用次数划分——即时闭环留在前台,重计算、重探索工作剥离至后台。核心规则、人设画像与个人记忆分层注入。将任务台账作为执行状态的唯一事实源,且严守安全底线:任何角色设定与历史记忆均无权逾越工具权限与安全红线。
▎异步协同:跨多轮长程任务执行
(图 6:跨轮次异步任务执行工作流示意图)
Voice Harness 框架中,前后台分工解决了“由谁执行”,异步任务周期管理则解决了“任务进行到哪里,以及何时把结果告诉用户”。后台任务可以跨越多轮语音交互,用户委派工作后,仍可随时插话查询进度、追加条件,或切入其他闲聊话题;待后台任务执行完毕后,系统再结合当下的实时对话语境,交付结果。
此外,受理事件只表示任务提交成功,不意味着执行已经开始或完成。运行时记录排队、运行、完成、失败或取消等状态,并将后续补充和权限请求关联到原任务,使助手能够依据实际记录汇报进展,而不是仅凭对话内容推测。
打断语音播报不等于取消后台任务,后台任务完成也不等于结果已经送达。 用户插话时,当前播报可以停止,但任务仍可继续运行;结果生成后,也可以等待合适的对话时机再交付。即使结果播报被打断,已经完成的工作也不会因此失效。
▎基准评测:多项核心能力领跑
(图 7:模型在多项核心能力基准评测中的结果)
(图 5:Qwen-Audio-3.1-Realtime 全时前后台语音交互示意图)
▎异步协同:跨多轮长程任务执行
(图 6:跨轮次异步任务执行工作流示意图)
Voice Harness 框架中,前后台分工解决了“由谁执行”,异步任务周期管理则解决了“任务进行到哪里,以及何时把结果告诉用户”。后台任务可以跨越多轮语音交互,用户委派工作后,仍可随时插话查询进度、追加条件,或切入其他闲聊话题;待后台任务执行完毕后,系统再结合当下的实时对话语境,交付结果。
此外,受理事件只表示任务提交成功,不意味着执行已经开始或完成。运行时记录排队、运行、完成、失败或取消等状态,并将后续补充和权限请求关联到原任务,使助手能够依据实际记录汇报进展,而不是仅凭对话内容推测。
打断语音播报不等于取消后台任务,后台任务完成也不等于结果已经送达。 用户插话时,当前播报可以停止,但任务仍可继续运行;结果生成后,也可以等待合适的对话时机再交付。即使结果播报被打断,已经完成的工作也不会因此失效。
▎基准评测:多项核心能力领跑
(图 7:模型在多项核心能力基准评测中的结果)
(图 6:跨轮次异步任务执行工作流示意图)
▎基准评测:多项核心能力领跑
(图 7:模型在多项核心能力基准评测中的结果)
(图 7:模型在多项核心能力基准评测中的结果)
▎结语
告别单调的回合制一问一答,语音交互的真正质变,发生于感知、表达与行动深度融合的瞬间。
Qwen-Audio-3.1-Realtime 给出的解法,是一套兼顾模型能力与系统架构的完整范式:以多模态后训练铸就原生音频底座,以自进化环境锻造可靠的 Agent 行为,再以全双工策略与 Voice Harness 架构化解交互冲突、支撑长程异步演进。
当“边听、边想、边动、边说”成为现实,智能助手不仅拥有了听懂弦外之音的温度,更具备了接管复杂长程任务的底气。让自然交流与现实生产力在此交汇,这正是下一代端到端语音智能体正在开启的未来。
