

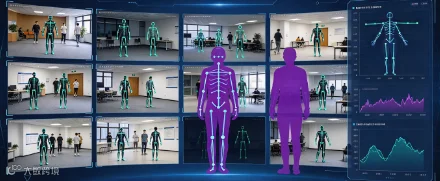
做行为分析的时候,大家都知道光靠检测框不够——你得知道人是站着还是蹲着、手举起来没有、脚有没有站稳。这就是姿态估计要干的事:把人的关节点(头、肩、肘、腕、髋、膝、踝)一个一个标出来。
今天分享的这篇 CVPR2026 论文 PoseStream,提出了一个流式多人姿态估计框架:不需要先做人检测再估姿态,一步到位直接出关键点,而且在遮挡严重、人多人挤的场景下依然稳。在 COCO Keypoints 和 CrowdPose 上刷新了实时姿态估计的 SOTA。
一、姿态估计到底难在哪
姿态估计听起来就是"标几个点",但真做了才知道,真实场景里的人体姿态比论文数据集里难多了。
1.1 两步走太慢:先检测再估点
传统自顶向下方法是:先跑一遍人检测,把每个人框出来,再分别对每个框做姿态估计。问题很明显——N 个人就要跑 N 次姿态网络,画面里人一多,速度直接崩。监控场景里一个画面挤几十个人,根本跑不动。
1.2 遮挡是最大的坑
论文数据集里的人基本都是正面、完整、不挡的。但真实监控里——两个人并排站着互相挡、人坐在椅子上只露出上半身、人被桌子挡住下半身——这种遮挡场景下,被挡住的关节点你根本看不到,怎么估?模型得学会"脑补"被挡住的关键点位置。
1.3 多人交错,关键点容易串
画面里两个人挨得很近,A 的左手和 B 的右手在视觉上几乎重合,模型很容易把 A 的点安到 B 身上——这就是关键点 ID 串扰。人越多、越挤,这个问题越严重。
1.4 小人体关键点根本看不清
远处监控里的人可能只有 30 像素高,头、肩、肘这些关节点根本分辨不出来。但行为分析又必须要这些点——人是走是跑、是站是坐,全靠关节点判断。小人体的关键点估计一直是个老大难。

二、PoseStream 的三个核心设计
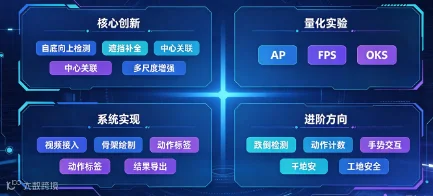
PoseStream 的整体思路:不做"先检测再估点"的两步走,而是一次前向直接输出所有人的所有关键点,用中心偏移把人和关键点关联起来。
2.1 自底向上 + 中心关联
自顶向下慢,自底向上(先估所有关键点再组人)快,但组人一直是难题。PoseStream 用了一个很巧妙的设计:
•先估所有关键点的位置:不管是谁的头、谁的手,先把所有关节点都检测出来。
•同时预测每个人的中心点:每个人的 torso 中心(大概在腰的位置)也检测出来。
•用中心点关联关键点:每个关键点预测一个"它属于哪个中心点"的偏移向量,自动把关键点归到对应的人身上。
这个设计的好处是:不需要先做人检测,一次前向全部搞定;而且组人是靠几何关系自动完成的,不需要额外的匹配算法,速度很快。
2.2 遮挡感知关键点补全
看不到的关键点怎么办?PoseStream 在训练时做了一个很聪明的数据增强:
•随机遮挡模拟:训练的时候随机把人体的一部分挡住(比如用黑色矩形遮掉手臂),然后要求模型依然预测出被挡住的关键点位置。
•可见性预测:每个关键点同时输出一个"可见性"分数——是真的看到了,还是根据身体结构猜出来的。
这样模型就学会了"根据身体结构常识推断被挡住的关节点位置"。比如看到了肩膀和手腕,即使肘被挡住了,模型也能根据人体结构大概猜出肘的位置。消融实验显示,加了遮挡训练后,CrowdPose(拥挤场景数据集)上的 AP 提升了 4.5 个点。
2.3 多尺度关键点增强
小人体关键点看不清怎么办?PoseStream 做了两个针对性设计:
•高分辨率特征图: backbone 下采样到 1/8 就停了,不像常规方法下采样到 1/32——保留更多细节信息,小关键点不容易丢。
•关键点尺度加权损失:小人体的关键点损失权重更大,让模型更重视小目标的精度。
在 COCO 小人体子集上,AP 提升了 3.8 个点,这对于监控远距离人体的姿态分析非常实用。
三、技术架构拆解
PoseStream 的整体 pipeline 分四个模块:
模块 |
做什么 |
关键设计 |
高分辨率 Backbone |
提取图像特征 |
轻量 CNN,保持 1/8 分辨率,保留小目标细节 |
关键点热图头 |
预测所有关节点位置 |
每个关键点一张热图,同时输出可见性分数 |
人体中心点检测头 |
检测每个人的 torso 中心 |
和关键点共享特征,自动学习人体中心位置 |
中心偏移关联头 |
把关键点归到对应的人 |
每个关键点预测到最近人体中心的偏移向量,自动组人 |
几个工程上的亮点:
•参数量:整个模型 12.3M,INT8 量化后在 Jetson Nano 上能跑 25fps 以上。
•端到端推理:从输入图像到输出"每个人的 17 个关键点",一次前向搞定,不需要后处理。
•视频友好:可以和跟踪器结合——关键点检测 + ID 跟踪,输出每个人的连续姿态轨迹。

四、和主流方法的横向对比
论文在 COCO Keypoints(标准多人姿态)和 CrowdPose(拥挤场景)两个基准上做了对比:
方法 |
COCO AP↑ |
CrowdPose AP↑ |
参数量(M) |
FPS(RTX3090) |
Mask R-CNN (Top-Down) |
63.9 |
53.2 |
45 |
12 |
HRNet-W32 |
74.4 |
63.5 |
28 |
15 |
RTMPose-s |
67.9 |
58.3 |
9 |
150 |
PoseStream |
71.2 |
66.8 |
12.3 |
180 |
可以看到,PoseStream 的 COCO AP 比 HRNet 略低一点,但速度快了 12 倍。更重要的是在 CrowdPose(拥挤场景)上反超了 HRNet——这得益于遮挡感知训练和中心关联机制,人多、人挤的场景下优势很明显。这个 trade-off 非常适合实时监控场景。
五、快速上手:推理核心代码
下面是 PoseStream 的推理框架,帮大家理解整体流程:
python |
实际部署的时候,如果要做连续视频的姿态分析,可以和 ByteTrack 跟踪器结合——每一帧估完姿态,再用跟踪器把同一个人的关键点串起来,就能得到每个人的连续动作轨迹。跌倒检测、徘徊检测这些上层应用都可以基于这个轨迹做。
六、毕设/竞赛拓展方向
姿态估计这个方向做毕设有个天然优势——Demo 效果非常直观,画出来骨架图一眼就能看懂。分享几个有价值的拓展点:
6.1 跌倒检测专项
跌倒检测是养老监控、居家安全的刚需。基于 PoseStream 的关键点,做跌倒判断逻辑——比如髋部中心点快速下降、身体角度从垂直变水平——做一个完整的跌倒检测报警系统。工程完整性很强。
6.2 健身动作计数与评估
基于关键点做动作分析:深蹲做了几个、俯卧撑标准不标准、瑜伽动作对不对。结合角度计算和动作分类,做一个 AI 健身教练的 Demo——这个方向现在 App 端很火,产品感很强。
6.3 手势识别 + 交互
只取手腕、手肘、肩膀、手这几个关键点,做手势识别——挥手、握拳、比心——然后做手势交互控制。这个方向在体感游戏、展厅交互里都有应用。
6.4 工地安全帽/违规行为检测
结合姿态估计和目标检测:检测到工人没戴安全帽 + 关键点显示他在危险区域 = 报警。把姿态信息和业务规则结合起来,做一个工地安全监控系统——和实际行业场景结合很紧。
七、写在最后
姿态估计这个方向,看起来就是"标几个点",但它是很多上层应用的基础——行为识别、动作分析、体感交互、康复评估,全都是建立在姿态估计之上的。
PoseStream 给我的启发是:不要总沿着"自顶向下"的老路走。自顶向下精度高但慢,自底向上快但组人难——能不能找到一个中间方案,既快又准?中心关联这个思路就是这样一个折中:不需要做人检测,但用中心点做桥梁把关键点串起来。很多工程问题就是这样,找到一个巧妙的中间表示,问题就解决了一半。
做毕设的同学如果选这个方向,我建议先拿一个开源姿态模型跑通 baseline,然后选一个上层应用去做——跌倒检测、健身计数、手势交互都行。姿态估计本身只是中间件,最终要有一个看得见的应用场景,工作才有价值。
大家如果有复现上的问题或者想聊具体的姿态应用场景,欢迎评论区交流。