

最近咱们聊过三篇“开源 Palantir”:Helix Foundry 把公司的数据库和 SaaS 连成一个本体,跑在你自己电脑上;semantica 给 Agent 的每次决策建图谱,追得回为什么;微软的 Ontology Playground 则退一步,先教你图里到底该装什么。
这三篇其实都默认了一件事:真到动手建本体的时候,你知道该用什么工具。
现实是,很多人就卡在这一步。问一圈,答案通常是 Protégé。下载,装 Java,打开,面对一屏为描述逻辑专家准备的菜单,开始怀疑人生。本体还没建,先被工具上了一课。
一位叫 Ralfo Becher 的国外数据从业者写了篇文章,说他每隔几个月就要建一次本体,每次都被同一类工具折磨。他要的从来不是哲学体验,只是建一个合理的类层次,加上属性和注解,导出一份合法的 Turtle。抱怨到最后,他干脆自己写了一个。这就是今天的主角:OrionBelt Ontology Builder。
一句话:纯 Python 的 OWL/SKOS 本体编辑器,Streamlit 加 rdflib,不要 Java,不用装桌面软件,pip install 之后一条命令,在浏览器里开工。
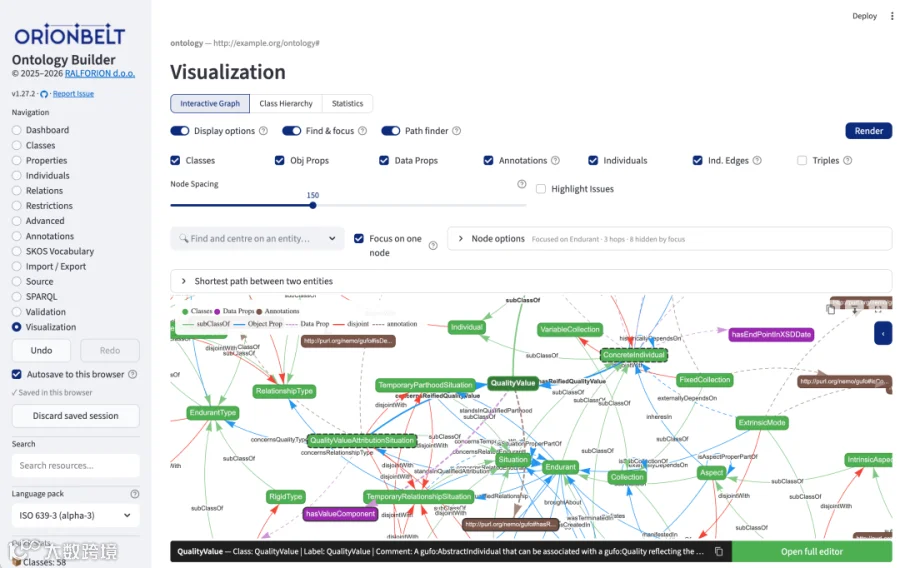
几个基本面:GitHub 上 216 个 stars,2025 年 11 月开源,更新很勤。除了 pip,还能用 Docker 跑,能装成桌面窗口应用,也能直接在官方放的在线 demo(orionbelt.streamlit.app)里试,什么都不用装。
Ralfo Becher 先把话说死了:这不是 Protégé。完整的描述逻辑、SWRL、复杂公理建模,它一概不做。你需要那些,请去用 Protégé,那是优秀的软件。它瞄准的是另一种处境:你想快速建一个干净的本体,不想先把第一个小时花在驯服工具上。
这个定位,和我们前面写的三篇“平替”文章有本质区别。Helix Foundry 和 semantica 想做的是平台,本体只是它们运转的核心层。OrionBelt 不碰平台,它只回答一个更朴素的问题:本体这个文件本身,用什么写?
批量操作和真 undo:被烂工具折磨过的人才懂
Ralfo Becher 在自述里花最多笔墨的,不是架构,是三个具体的心结。
第一个,批量操作。要建 30 个类,他不想把同一个表单填 30 遍,用他的原话,那是“办公室体罚”。在 OrionBelt 里,你把名字粘进去,一行一个,或者直接贴 CSV,类就建好了。属性、个体、注解,一视同仁。批量编辑是一个可以直接改的表格视图,批量删除是多选之后一次搞定。
第二个,真正的撤销。每一次改动都留下一个检查点,批量操作整体算一步,一次回滚。删一个类之前,工具先告诉你有哪些东西依赖它,确认之后才动手。不是那种“关掉重开,顺便反思人生”的假 undo。
第三个,导入前的 diff。Ralfo Becher 说他被坑过太多次:把一个文件导入某个编辑器,之后才发现它悄悄覆盖了半个本体。OrionBelt 的做法是导入前先出审查面板:哪些是新的,哪些冲突,前缀怎么变,三种合并策略自己挑,还能先下载一份变更报告再决定。
这三件事没有一件听起来性感。但只要你真维护过本体,就知道它们就是日常工作本身。
SKOS 是一等公民,但没有“全部修复”按钮
很多人的本体工作其实不是建类层次,而是维护受控词表:术语表、分类法、标签体系。这类活在语义网里叫 SKOS,大多数编辑器把它当附属功能,OrionBelt 给了它一个独立页面。
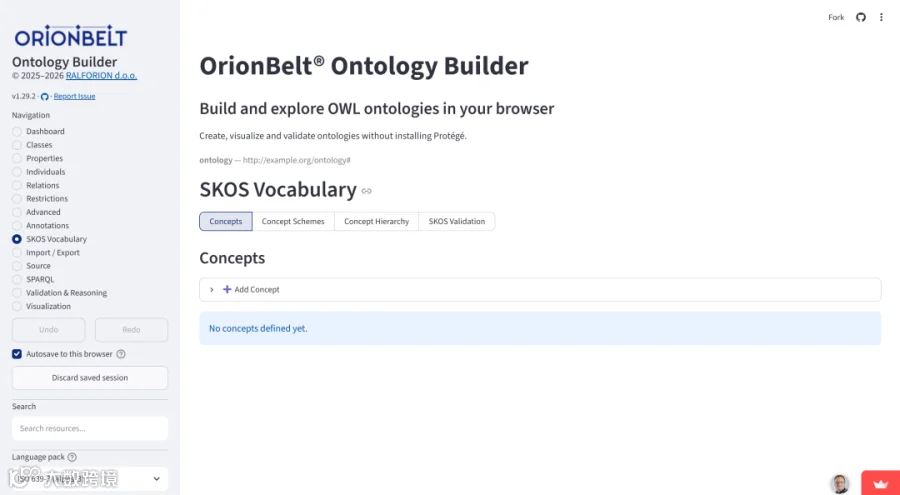
多语言标签、多重父级、和 Wikidata 这类外部词表的映射,都支持。最见功力的是校验:22 项检查,分错误、惯例、编辑建议三层,每条依据标注得清清楚楚,是来自 SKOS 标准、老牌质检工具 qSKOS,还是词表实践惯例。层级成环、标签缺失、孤儿概念,都指名道姓告诉你谁在哪。
其中 7 项可以一键修复,但Ralfo Becher 故意不做“全部修复”按钮。他的理由是:断开一个环、删掉一条冗余边,丢掉的都可能是他本意,这个决定必须人来下,一次一类。一个工具在这种地方克制,比它多十个功能更能说明问题。
只读 SPARQL,和一个不裸奔的起点
工具内置一个 SPARQL 控制台,但只读:SELECT、ASK、CONSTRUCT、DESCRIBE 随便跑,INSERT 和 DELETE 一律拒绝。理由和上一节是同一个:修改必须走编辑器,才能进检查点,才能撤销。查询还有行数和时间上限,一条写砸的查询不会把应用拖死。
推理和质检也没落下:OWL-RL 推理、模型质量规则(发现问题可以说明理由后抑制)、SHACL 校验,都能直接跑。
起点方面它不让你面对空白页:五个模板(组织、产品目录、事件、人物、SKOS 词表),两个打包好的上层本体 gist 和 gUFO,FOAF、PROV-O、GoodRelations 三个常用参考本体,外加一个约一百个概念的地理词表示例。想从专业地基开始,还是想从玩具开始,随你。
还有个值得知道的用法:它可以不当应用,直接当 Python 库 import 进脚本或 CI,编辑器能做的事,底层 OntologyManager 都有对应方法。
它不适合谁
毕竟是个人维护的开源工具,肯定有缺点,我们照着官方文档如实列:
要完整的描述逻辑推理、SWRL 规则、复杂公理建模,它没有,Ralfo Becher 明说请用 Protégé。schema.org 这类纯 RDFS 词表,目前不会在类和属性面板里显示。没有多人协作,没有服务端,本体存在本地文件或浏览器里。
还有许可证:BUSL-1.1,不是 Apache 也不是 MIT。个人用、内部用问题不大,但要拿它做对外商业产品,得先读一遍条款。好消息是它约定了 2030 年 3 月 30 日自动转成 Apache 2.0。
所以本体工具到底怎么选
把这个问题按场景拆开,答案其实不难:
做严肃本体工程。 要完整 DL 推理、SWRL、插件生态,选 Protégé,斯坦福出品,免费,二十多年的老工具。要多人协作,用它的网页版 WebProtégé。代价是学习曲线,它本来就是为专业人士造的。
治理词表和术语体系。 开源的 VocBench 专门干这个,团队审批流都带。预算充足、要企业级语义层和商业支持,看 TopBraid EDG 和 PoolParty。
把本体当数据平台的运营核心。 对象、管道、权限、应用、行动要连成一体,那说的是 Palantir Foundry。注意,那是另一个物种:你买的不是本体编辑器,是一整套平台和配套的交付方法论,想清楚了再上车。
让 LLM 直接写。 现在很多人让大模型直接生成 Turtle,起步快,打个草稿、冷启动都合适。但本体是要长期维护的资产,一致性检查、增量演进、多人改动,迟早需要工具兜底。顺便一提,OrionBelt 有个姊妹项目 OrionBelt Analytics(https://github.com/ralfbecher/orionbelt-analytics),能从 PostgreSQL、Snowflake 的库表结构自动生成本体和 SQL 映射,走的是“从现有数据反推本体”这条路。
自己快速建一个干净的本体或词表。 不想学描述逻辑,不想配环境,导出要是标准格式,以后能交给别的工具接着用。这就是 OrionBelt 的位置。
一句话总结:工具没有高下,只有你的活属于哪一类。
结语
建本体真正需要的只有两样:一个顺手的工具,和想清楚你到底在解决什么问题。
前者,今天这篇给了你一个清单。后者,谁也替不了你。
你手头那个本体,或者那份早就该结构化的术语表,是打算继续躺在 wiki 里,还是这周就给它找个工具?
参考资料:OrionBelt Ontology Builder 的 GitHub 仓库(github.com/ralforion/orionbelt-ontology-builder),Ralfo Becher 制作的在线演示 orionbelt.streamlit.app。
提醒:请朋友们将“智见AI视界”加“星标”,觉得写得好就点击右下角“拇指”和“收藏”哦,不然会慢慢收不到文章推送~
关联阅读