

哈喽,大家好~
有同学私信问到:“普通回归只能给我一个预测值,如果我还想知道这个预测靠不靠谱呢?”
其实这时候,高斯过程回归就很合适了。
趁这个机会,我们今天来聊一个自带“不确定性评估”的回归模型,高斯过程回归,简称 GPR。
它不仅能预测结果,还会给出预测区间,告诉我们模型在哪些地方有把握,哪些地方心里没底~
01高斯过程回归
普通线性回归会先假设一个函数形式,比如:
然后再根据数据学习参数 和 。
高斯过程回归的思路不太一样。它不急着确定函数长什么样,而是先假设:可能的函数有很多条,距离相近的样本,其函数值通常也更相似。
随着观测数据不断加入,不符合数据的函数会被淘汰,最后剩下的函数共同形成预测结果。
你可以把它理解成:GPR不是只画一条线,而是在综合很多条合理曲线之后,给出一条平均曲线和一个可信范围。
它比较适合以下场景:
-
数据量不大,但特征与目标之间存在非线性关系; -
除了预测值,还关心预测的不确定性; -
样本获取成本高,例如实验优化、传感器建模和贝叶斯优化。
不过它也有一个明显缺点:训练复杂度约为 。数据达到几万甚至几十万条时,直接使用标准GPR就会比较吃力。
02核心原理
相似的输入,得到相似的输出~
高斯过程通常写成:
其中, 是均值函数,表示函数整体趋势; 是核函数,用来衡量两个输入 和 有多相似。
我们这里使用常见的RBF核:
控制函数变化幅度, 叫长度尺度。
越小,模型越关注附近样本,拟合曲线会更灵活; 越大,较远的样本也会互相影响,曲线会更平滑。
假设训练数据为 、 ,测试点为 ,那么预测均值为:
预测协方差为:
这里的 是训练样本之间的核矩阵, 描述训练点和测试点的相似度, 表示观测噪声方差。
一句话概括:测试点越接近训练数据,预测通常越稳定;离训练数据越远,不确定性就越大。
03完整案例
我们下面构造一组带有三个特点的数据:非线性、噪声随 增大、并且中间故意留出一段采样空白。
代码会生成两张分析图~
第一张观察最终拟合效果,第二张比较不同长度尺度对模型的影响。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.gaussian_process import GaussianProcessRegressor
from sklearn.gaussian_process.kernels import RBF, ConstantKernel
from sklearn.metrics import mean_squared_error

np.random.seed(42)

# 真实函数
def true_func(x):
    return 0.45 * x * np.sin(1.6 * x) + 0.8 * np.cos(3.2 * x)

# 生成训练数据,中间[3.4, 4.5]没有样本
x1 = np.random.uniform(0, 3.4, 22)
x2 = np.random.uniform(4.5, 8, 20)
X = np.sort(np.r_[x1, x2]).reshape(-1, 1)

# 异方差噪声:x越大,噪声越明显
noise_std = 0.15 + 0.06 * X.ravel()
y = true_func(X.ravel()) + np.random.normal(0, noise_std)

X_test = np.linspace(-1, 9, 500).reshape(-1, 1)
y_true = true_func(X_test.ravel())

# 常数核控制幅度,RBF核控制平滑程度
kernel = ConstantKernel(
    1.0, (1e-2, 1e2)
) * RBF(
    length_scale=1.0,
    length_scale_bounds=(0.05, 10)
)

gpr = GaussianProcessRegressor(
    kernel=kernel,
    alpha=noise_std ** 2,   # 每个样本对应自己的噪声方差
    normalize_y=True,
    n_restarts_optimizer=8,
    random_state=42
)

gpr.fit(X, y)
mean, std = gpr.predict(X_test, return_std=True)

inside = (X_test.ravel() >= 0) & (X_test.ravel() <= 8)
rmse = mean_squared_error(
    y_true[inside], mean[inside]
) ** 0.5

print("优化后的核函数:", gpr.kernel_)
print("区间[0, 8]上的RMSE:", round(rmse, 4))

# 图1:预测曲线、不确定性和数据空白区
fig, ax = plt.subplots(figsize=(11, 6))
ax.plot(X_test, y_true, "--", color="#00C2FF",
        linewidth=2.2, label="True function")
ax.plot(X_test, mean, color="#FF2E88",
        linewidth=2.6, label="GPR mean")
ax.fill_between(
    X_test.ravel(),
    mean - 1.96 * std,
    mean + 1.96 * std,
    color="#FFD166",
    alpha=0.48,
    label="95% confidence band"
)
ax.scatter(X, y, s=55, color="#6C3BFF",
           edgecolor="white", linewidth=0.8,
           zorder=5, label="Observations")

ax.axvspan(3.4, 4.5, color="#00E5A8", alpha=0.16,
           label="Sampling gap")
ax.axvspan(-1, 0, color="#FF6B35", alpha=0.10)
ax.axvspan(8, 9, color="#FF6B35", alpha=0.10)

ax.set_title("Gaussian Process Regression with Uncertainty")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.grid(alpha=0.2)
ax.legend(ncol=2)
plt.tight_layout()
plt.show()

# 图2:不同长度尺度下的预测对比
length_scales = [0.25, 1.0, 3.0]
colors = ["#FF2E88", "#00B8D9", "#7C4DFF"]

fig, axes = plt.subplots(1, 3, figsize=(16, 4.8), sharey=True)

for ax, length, color in zip(axes, length_scales, colors):
    fixed_kernel = (
        ConstantKernel(1.0, constant_value_bounds="fixed")
        * RBF(length, length_scale_bounds="fixed")
    )

    model = GaussianProcessRegressor(
        kernel=fixed_kernel,
        alpha=noise_std ** 2,
        normalize_y=True,
        optimizer=None
    )
    model.fit(X, y)
    pred, pred_std = model.predict(X_test, return_std=True)

    ax.plot(X_test, y_true, "--", color="#222222",
            linewidth=1.6, label="True")
    ax.plot(X_test, pred, color=color,
            linewidth=2.4, label="Prediction")
    ax.fill_between(
        X_test.ravel(),
        pred - 1.96 * pred_std,
        pred + 1.96 * pred_std,
        color=color,
        alpha=0.22
    )
    ax.scatter(X, y, s=22, color="#FFB000", edgecolor="white")
    ax.axvspan(3.4, 4.5, color="#00E5A8", alpha=0.12)
    ax.set_title(f"length_scale = {length}")
    ax.set_xlabel("x")
    ax.grid(alpha=0.2)

axes[0].set_ylabel("y")
axes[0].legend()
fig.suptitle("How Length Scale Changes GPR", fontsize=15)
plt.tight_layout()
plt.show()
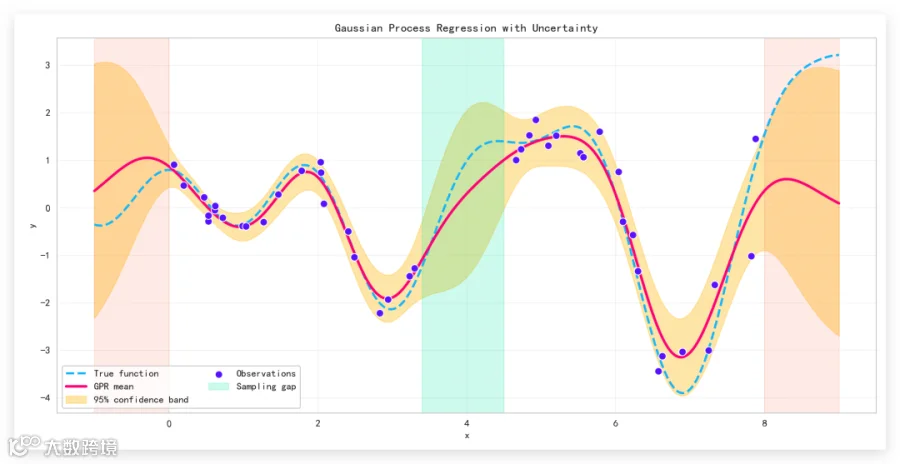
第一张图中,粉色曲线是预测均值,黄色区域是约95%的置信区间。中间绿色区域没有训练样本,因此置信区间会变宽;在训练范围之外,不确定性也会明显增加。
这正是GPR很有价值的地方:它不会在陌生区域假装自信。
第二张图展示了长度尺度 的影响~
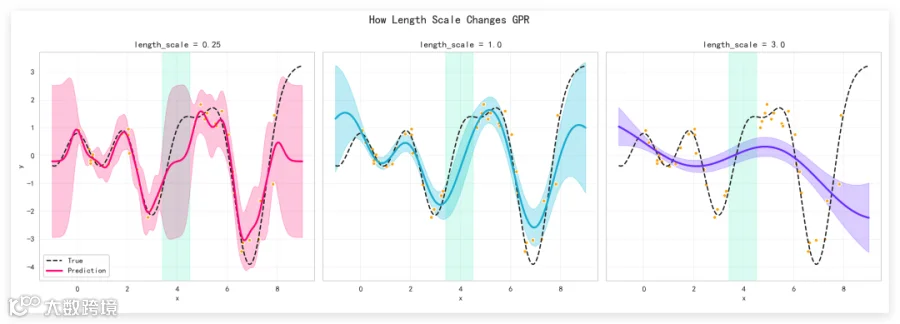
时曲线变化很快,容易追随局部噪声; 时又过于平滑,容易漏掉真实波动;中间值通常能在拟合能力和平滑性之间取得更好的平衡。
实际使用时,可以让模型通过最大化对数边际似然自动寻找核参数,也可以结合交叉验证进一步检查泛化效果。
最后
高斯过程回归的核心,是利用核函数描述样本之间的相似性,同时输出预测均值和不确定性。它在小样本、非线性以及需要风险判断的任务中非常实用。
接下来大家可以尝试更换Matérn核,观察不光滑数据上的效果;也可以把多个核函数相加,分别建模长期趋势、周期变化和局部波动。数据量较大时,则可以继续了解稀疏高斯过程和近似推断。