

哈喽,大家好~
最近有同学问到,为什么模型准确率不高,训练时还一直震荡?
一个非常重要的原因,可以先想想,数据归一化了吗?
我们在日常的实验中,不同特征的数值范围经常差得很大。比如年龄是 20~60,年收入却是几万到几十万。模型直接拿这些数据训练,很容易被“大数值特征”带偏~
今天我们就把数据归一化讲清楚,再用一个分类数据集,看它如何影响 KNN 的决策边界和模型训练过程~
01数据归一化是什么
数据归一化,就是把不同量纲、不同范围的特征,转换到一个相近的数值区间。
你可以这样理解:一个特征说话声音是 1,另一个特征的声音是 10000。模型听到以后,自然更关注后者。但数值大,不代表它真的更重要。
常见的 Min-Max 归一化公式为:
其中, 是原始数据, 和 分别是该特征的最小值与最大值, 是归一化结果。
例如某个特征范围是 0~100,原始值为 20,那么归一化后就是:
一句话概括:Min-Max 归一化会把数据压缩到 区间,同时保留原来的大小关系。
02哪些模型更需要归一化
归一化对依赖“距离”和“梯度”的模型非常重要。
KNN、K-Means 会直接计算样本距离。如果某个特征范围特别大,它就会主导距离结果。逻辑回归、神经网络等模型依赖梯度优化,特征尺度差异过大,也会让损失函数更难优化。
SVM、PCA 同样对特征尺度敏感。不过,决策树、随机森林这类基于特征切分的模型,通常不依赖距离,对归一化没有那么敏感。
需要注意的是,Min-Max 对异常值比较敏感。存在极端值时,可以考虑标准化:
这里的 是均值, 是标准差。它会把数据转换为均值接近 0、标准差接近 1 的形式。
03完整案例
下面生成一个二分类数据集,并故意把第二个特征放大 80 倍。我们分别观察 KNN 决策边界,以及逻辑回归的训练损失。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
import torch
import torch.nn as nn

np.random.seed(42)
torch.manual_seed(42)

# 1. 构造数据,并制造特征尺度差异
X, y = make_classification(
    n_samples=600, n_features=2, n_redundant=0,
    n_informative=2, class_sep=1.3, random_state=42
)
X[:, 1] *= 80

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=42
)

# 只能使用训练集拟合归一化器,避免数据泄漏
scaler = MinMaxScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 2. 训练KNN
knn_raw = KNeighborsClassifier(n_neighbors=9).fit(X_train, y_train)
knn_scaled = KNeighborsClassifier(n_neighbors=9).fit(
    X_train_scaled, y_train
)

# 3. 使用PyTorch训练逻辑回归
def train_logistic(data, label, epochs=150):
    torch.manual_seed(42)
    model = nn.Linear(2, 1)
    optimizer = torch.optim.SGD(model.parameters(), lr=0.05)
    criterion = nn.BCEWithLogitsLoss()

    tx = torch.tensor(data, dtype=torch.float32)
    ty = torch.tensor(label[:, None], dtype=torch.float32)
    losses = []

    for _ in range(epochs):
        optimizer.zero_grad()
        loss = criterion(model(tx), ty)
        loss.backward()
        optimizer.step()
        losses.append(loss.item())
    return losses

raw_losses = train_logistic(X_train, y_train)
scaled_losses = train_logistic(X_train_scaled, y_train)

# 4. 绘制决策边界
def draw_boundary(ax, model, data, label, title):
    x1_min, x1_max = data[:, 0].min() - .2, data[:, 0].max() + .2
    x2_min, x2_max = data[:, 1].min() - .2, data[:, 1].max() + .2

    xx, yy = np.meshgrid(
        np.linspace(x1_min, x1_max, 300),
        np.linspace(x2_min, x2_max, 300)
    )
    grid = np.c_[xx.ravel(), yy.ravel()]
    zz = model.predict_proba(grid)[:, 1].reshape(xx.shape)

    ax.contourf(xx, yy, zz, levels=20, cmap="cool", alpha=.65)
    ax.contour(xx, yy, zz, levels=[.5], colors="#FFE600", linewidths=3)
    ax.scatter(data[:, 0], data[:, 1], c=label,
               cmap="spring", edgecolor="black", s=28)
    ax.set_title(title)

fig, axes = plt.subplots(1, 3, figsize=(18, 5))

raw_acc = accuracy_score(y_test, knn_raw.predict(X_test))
scaled_acc = accuracy_score(
    y_test, knn_scaled.predict(X_test_scaled)
)

draw_boundary(
    axes[0], knn_raw, X_train, y_train,
    f"Raw Data | KNN Accuracy={raw_acc:.3f}"
)
draw_boundary(
    axes[1], knn_scaled, X_train_scaled, y_train,
    f"Normalized | KNN Accuracy={scaled_acc:.3f}"
)

axes[2].plot(raw_losses, color="#FF1744", lw=2.5, label="Raw")
axes[2].plot(scaled_losses, color="#00E676", lw=2.5,
             label="Normalized")
axes[2].set_yscale("log")
axes[2].set_title("Logistic Regression Training Loss")
axes[2].set_xlabel("Epoch")
axes[2].set_ylabel("Loss")
axes[2].grid(alpha=.25)
axes[2].legend()

plt.tight_layout()
plt.show()
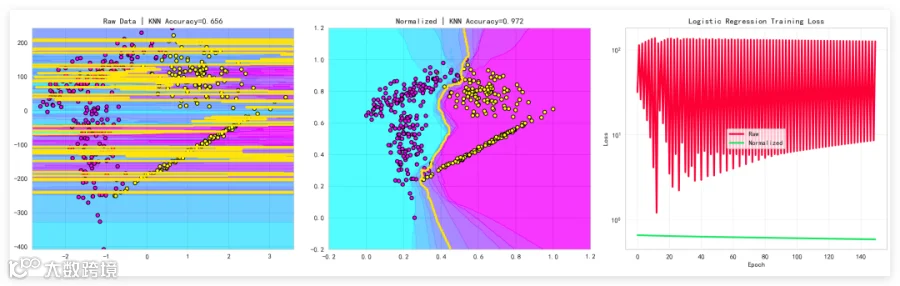
前两张图展示的是 KNN 决策边界。背景颜色代表模型对不同类别的预测区域,黄色曲线是分类分界线。
原始数据中,第二个特征被放大了 80 倍,KNN 计算距离时会过度关注它。归一化后,两个特征回到相近尺度,决策边界通常会更贴合真实的数据结构,测试集准确率也更合理。
第三张图对比逻辑回归的训练损失。纵轴使用对数刻度,可以更清楚地观察收敛速度。绿色曲线如果下降得更快、更平稳,说明归一化改善了优化过程。
还有一个细节必须注意:一定要先划分训练集和测试集,再用训练集执行 fit。如果拿全部数据计算最大值和最小值,就等于提前看到了测试集信息,这叫数据泄漏。
最后
数据归一化不是简单地“把数字变小”,而是让不同特征在更公平的尺度上参与模型计算。对于 KNN、SVM、K-Means、逻辑回归和神经网络,它往往会直接影响距离、收敛速度和最终效果。
实际使用时,你可以继续对比 MinMaxScaler 与 StandardScaler 的表现;如果数据中存在明显异常值,也可以尝试 RobustScaler。总之就是说,调模型之前,先把数据尺度检查清楚,很多问题会简单不少。