

一次完整的“设计 → 仿真 → 验证 → 工程化”之旅,记录一个极简 VLIW 从概念到跑通的全部过程 😄
🌟 缘起:为什么要手搓 VLIW?
如果你读过计算机体系结构的教材,一定对 VLIW(Very Long Instruction Word,超长指令字) 这个概念不陌生。它是 ILP(指令级并行)探索史上一颗璀璨又悲情的明星:Intel 的 Itanium、TI 的 C6x DSP、Transmeta 的 Crusoe,都曾是它的信徒。它最终没能在通用 CPU 领域击败乱序执行的超级标量,但在 DSP、AI 加速器、网络处理器里活得很好。
VLIW 的哲学极其简单粗暴:把“哪些指令可以并行”这个决定,从硬件的运行时,挪到编译器的编译时。 超级标量 CPU 让硬件在运行时检查依赖、动态调度、乱序发射,电路复杂、功耗高、但能自适应;VLIW CPU 只让硬件负责“一条长指令里的 N 个槽位同时发射”,电路极简、功耗低,但完全依赖编译器调度。
这个取舍非常适合作为学习项目:硬件简单到一个人一周能写完,而软件侧(编译器调度)的坑可以慢慢填。更妙的是,它天然并行,很适合拿来做“VLIW vs 超级标量”的对比实验。于是就有了这个项目:一个 4 槽位、32 位、带分支和访存的极简 VLIW 处理器。RTL 用 SystemVerilog,仿真用 Verilator + C++,构建系统用 CMake。全程开源工具链,零商业 EDA 依赖。🎉
这篇博客会把这整条流水线完整地走一遍。如果你也想动手,跟着走就行。
🧠 第一章:VLIW 到底是什么?
1.1 一条指令,四个动作
传统 RISC 的一条指令只做一件事。VLIW 把多条独立指令打包成一条“超长指令”,硬件一个周期全部发射。我们设计的格式是 128 位一条长指令 = 4 × 32 位槽位:
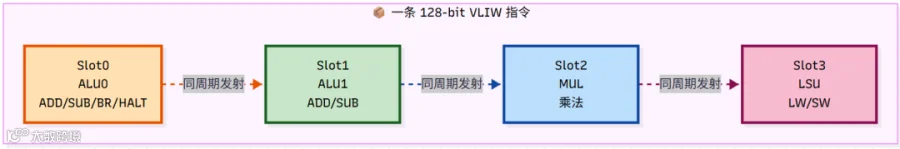
每个 32 位槽位的编码是统一的:
[31:28] op | [27:23] rd | [22:18] rs1 | [17:13] rs2 | [12:0] imm(13位有符号)
1.2 VLIW vs 超级标量:控制权的转移
用一张对比图说明差异:
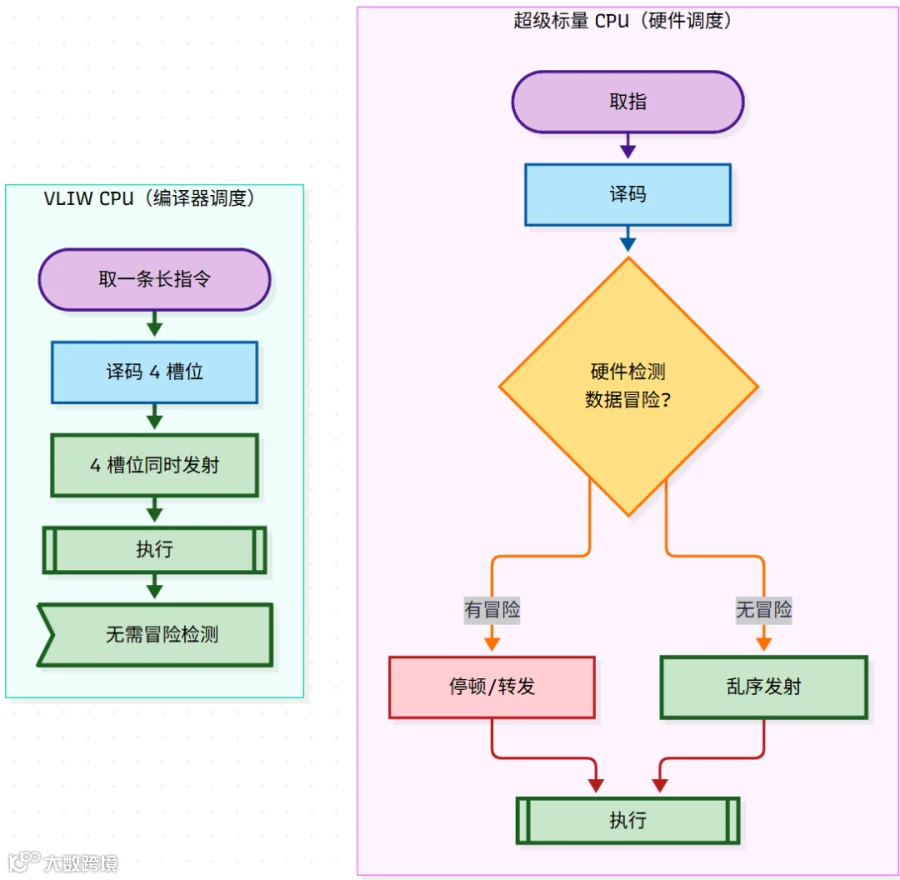
硬件的复杂度差异一目了然。VLIW 里没有冒险检测器、没有重排序缓冲、没有保留站——这些“高级功能”全被编译器吃掉了。
1.3 我们的设计目标
🏗️ 第二章:整体架构与数据通路
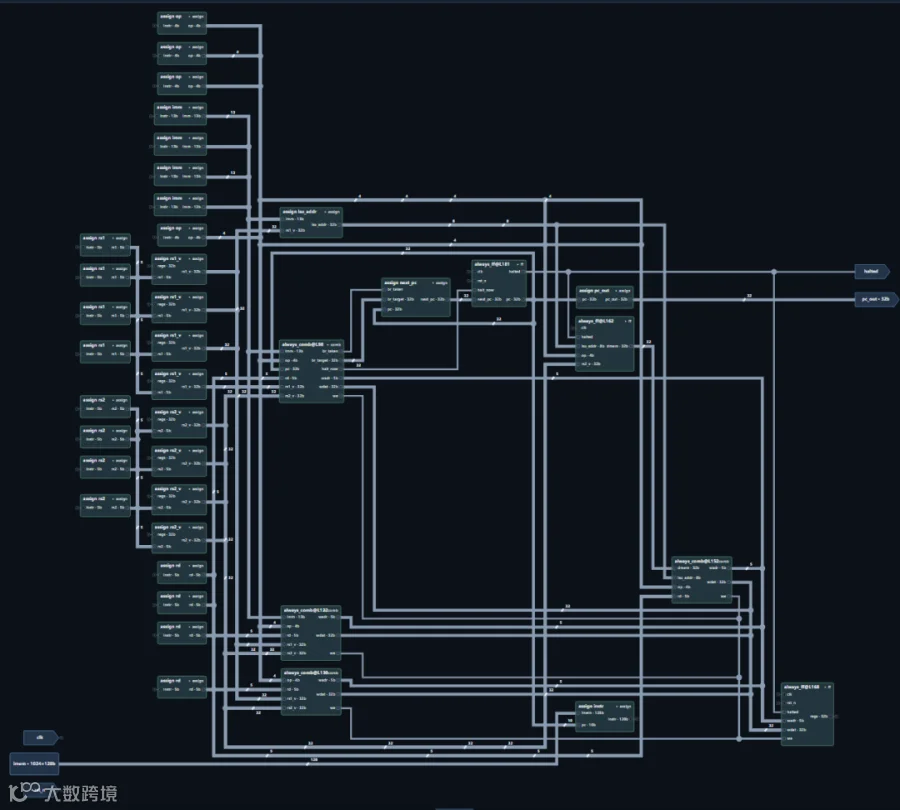
2.1 顶层架构
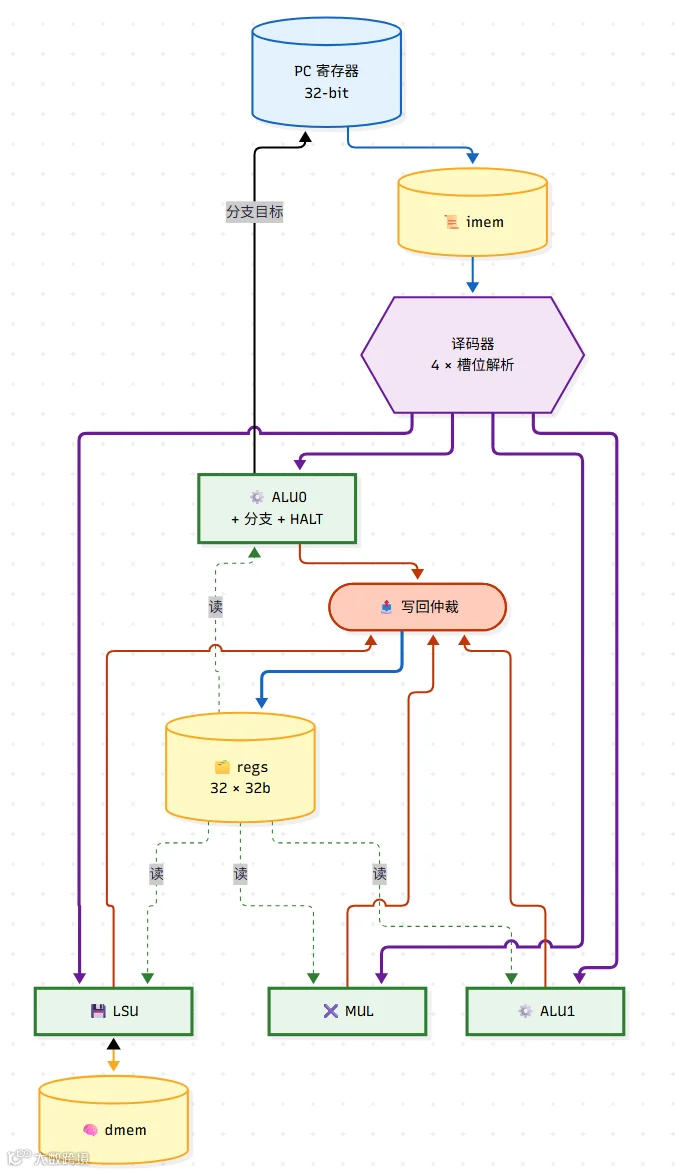
上面的顶层架构框图给出数据通路概览,下面的模块链接图进一步展示各模块之间的连接关系:
2.2 时序:没有冒险检测的“优雅”
我们利用组合读寄存器 + 时钟沿写寄存器这一对特性,让跨周期的 RAW 冒险自动安全:
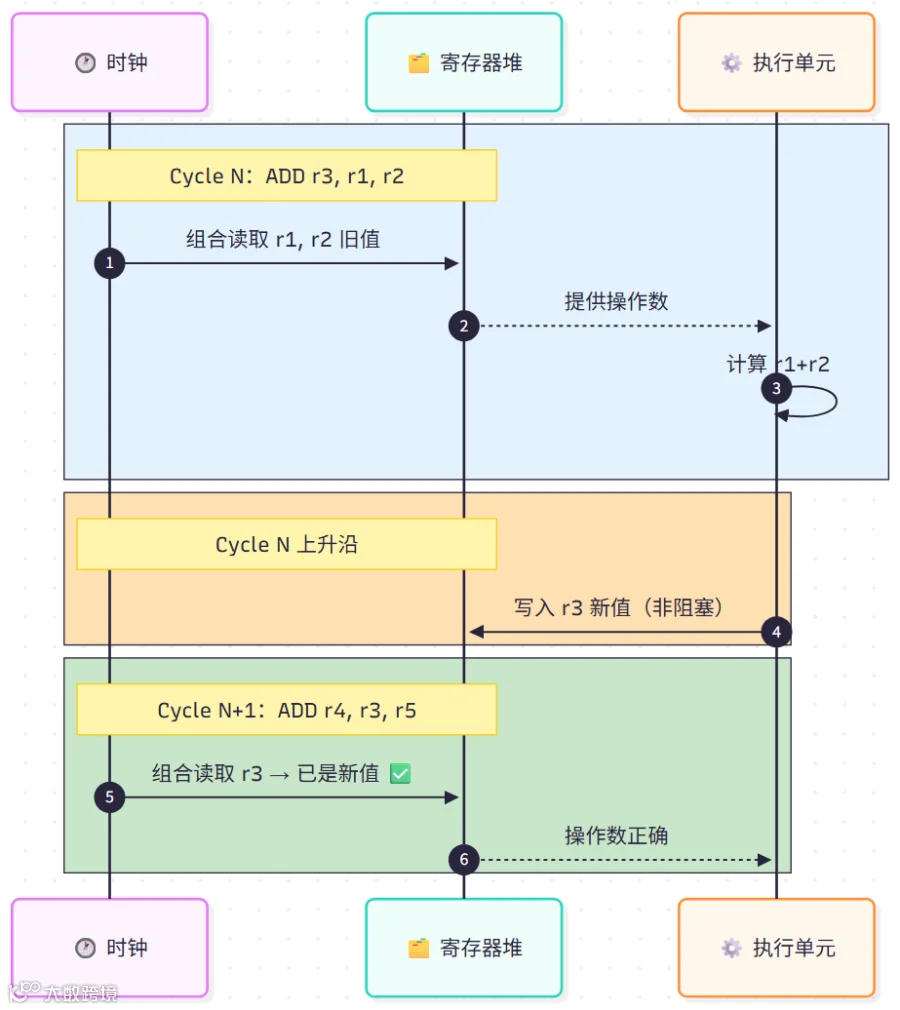
关键在于:同一周期内的读看到的是旧值,写发生在周期末尾,下一周期才可见。这正是教科书里“寄存器堆读写不同沿”的经典用法。所以跨周期 RAW 是安全的;同周期内 RAW 则危险,比如 ADD r3, r1, r2 和 ADD r4, r3, r5 放在同一个长指令里,r4 会读到 r3 的旧值。这就要靠编译器把有依赖的两条指令放到不同周期——这就是 VLIW 的“调度”责任。
2.3 写回冲突
如果编译器(或手写的糟糕测试)让两个槽位同一周期写同一个寄存器,硬件里有个固定的仲裁顺序:ALU0 → ALU1 → MUL → LSU,后面的覆盖前面的。
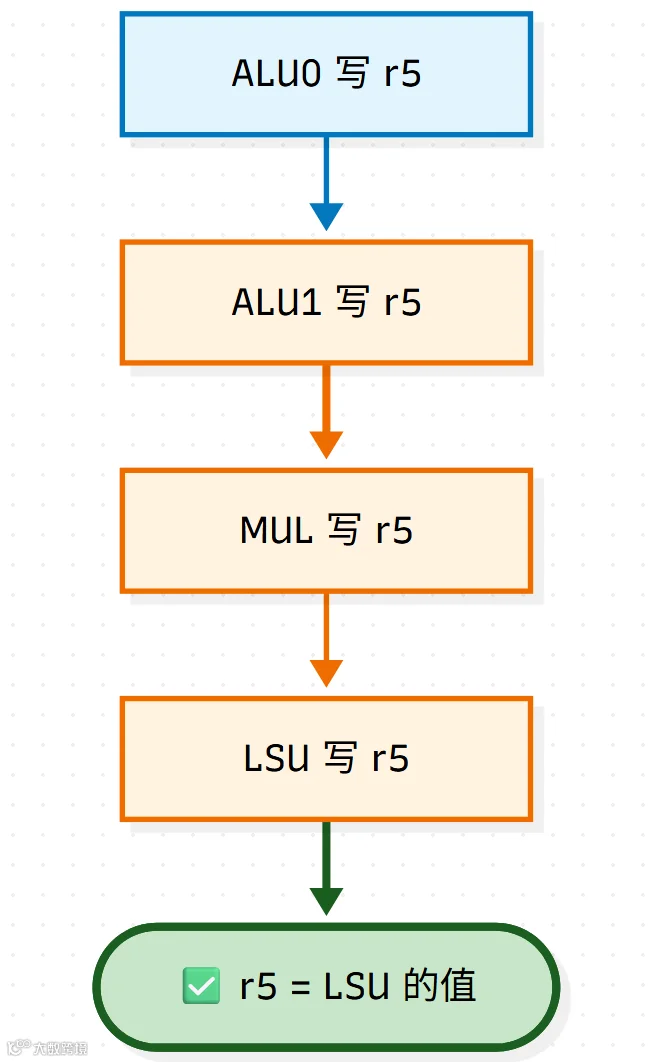
这不是特性,是 bug 的温床。编译器的责任是保证永远不发生这种冲突。我的 RTL 里用简单的顺序 if 实现,不做检测——这就是 VLIW 的“丑话在前头”。
💻 第三章:RTL 实现
整份 RTL 大约 220 行,为了便于阅读,下面按功能拆成若干块逐一说明。
3.1 模块声明与参数
   `timescale 1ns/1ps
`default_nettype none

module vliw_cpu #(
    parameter int IMEM_WORDS = 1024,
    parameter int DMEM_WORDS = 256,
    parameter     INIT_FILE  = ""
)(
    input  logic        clk,
    input  logic        rst_n,
    output logic [31:0] pc_out,
    output logic        halted
);

    localparam int XLEN      = 32;
    localparam int N_REGS    = 32;
    localparam int N_SLOTS   = 4;
    localparam int VLIW_BITS = XLEN * N_SLOTS;

    localparam int S_ALU0 = 0;
    localparam int S_ALU1 = 1;
    localparam int S_MUL  = 2;
    localparam int S_LSU  = 3;
-
• IMEM_WORDS控制指令存储器深度,默认 1024 条长指令 -
• DMEM_WORDS控制数据存储器深度,默认 256 个字 -
• INIT_FILE非空时从文件加载指令;为空时全部初始化为 NOP -
• XLEN=32是每个槽位的位宽,N_SLOTS=4是槽位数 -
• VLIW_BITS=128是整条长指令的位宽 -
• S_ALU0 / S_ALU1 / S_MUL / S_LSU是四个槽位的下标常量,后续写回仲裁会用到
3.2 操作码定义
       localparam logic [3:0] OP_NOP  = 4'd0;
    localparam logic [3:0] OP_ADD  = 4'd1;
    localparam logic [3:0] OP_SUB  = 4'd2;
    localparam logic [3:0] OP_AND  = 4'd3;
    localparam logic [3:0] OP_OR   = 4'd4;
    localparam logic [3:0] OP_XOR  = 4'd5;
    localparam logic [3:0] OP_MUL  = 4'd6;
    localparam logic [3:0] OP_ADDI = 4'd7;
    localparam logic [3:0] OP_BEQ  = 4'd8;
    localparam logic [3:0] OP_BNE  = 4'd9;
    localparam logic [3:0] OP_JMP  = 4'd10;
    localparam logic [3:0] OP_LW   = 4'd11;
    localparam logic [3:0] OP_SW   = 4'd12;
    localparam logic [3:0] OP_HALT = 4'd15;
-
• 4 位操作码最多容纳 16 条指令,当前用了 14 条 -
• OP_NOP用于填充空闲槽位,译码时不做任何操作 -
• OP_ADDI是立即数加法,其他算术逻辑运算都是寄存器-寄存器形式 -
• 三个分支指令 BEQ / BNE / JMP只在 ALU0 槽生效 -
• OP_LW / OP_SW只在 LSU 槽生效 -
• OP_HALT只在 ALU0 槽生效,置位halted后整个 CPU 停止
3.3 存储与寄存器声明
       // 存储器 —— public_flat_rw 允许 C++ TB 直接读写
    logic [VLIW_BITS-1:0] imem [0:IMEM_WORDS-1] /*verilator public_flat_rw*/;
    logic [XLEN-1:0]      dmem [0:DMEM_WORDS-1] /*verilator public_flat_rw*/;
    logic [XLEN-1:0]      regs [0:N_REGS-1]     /*verilator public_flat_rw*/;

    logic [XLEN-1:0]      pc, next_pc;
    logic [VLIW_BITS-1:0] instr;
    logic                 br_taken, halt_now;
    logic [XLEN-1:0]      br_target;

    assign instr = imem[pc[$clog2(IMEM_WORDS)-1:0]];
-
• /*verilator public_flat_rw*/是 Verilator 的注解,允许 C++ TB 通过rootp直接读写这三个数组 -
• imem宽度是 128 位,每个元素是一条完整的长指令 -
• dmem和regs都是 32 位宽 -
• instr在当前周期从imem[pc]组合读出 -
• pc[$clog2(IMEM_WORDS)-1:0]截断地址,防止越界访问
3.4 译码 generate 循环
       logic [3:0]          op    [0:N_SLOTS-1];
    logic [4:0]          rd    [0:N_SLOTS-1];
    logic [4:0]          rs1   [0:N_SLOTS-1];
    logic [4:0]          rs2   [0:N_SLOTS-1];
    logic signed [12:0]  imm   [0:N_SLOTS-1];
    logic [XLEN-1:0]     rs1_v [0:N_SLOTS-1];
    logic [XLEN-1:0]     rs2_v [0:N_SLOTS-1];

    logic        we   [0:N_SLOTS-1];
    logic [4:0]  wadr [0:N_SLOTS-1];
    logic [XLEN-1:0] wdat [0:N_SLOTS-1];

    genvar gi;
    generate
        for (gi = 0; gi < N_SLOTS; gi++) begin : g_dec
            assign op[gi]    = instr[gi*32+31 : gi*32+28];
            assign rd[gi]    = instr[gi*32+27 : gi*32+23];
            assign rs1[gi]   = instr[gi*32+22 : gi*32+18];
            assign rs2[gi]   = instr[gi*32+17 : gi*32+13];
            assign imm[gi]   = instr[gi*32+12 : gi*32+0];
            assign rs1_v[gi] = (rs1[gi] == 5'd0) ? '0 : regs[rs1[gi]];
            assign rs2_v[gi] = (rs2[gi] == 5'd0) ? '0 : regs[rs2[gi]];
        end
    endgenerate
-
• generate一次生成 4 套结构完全相同的译码逻辑,避免重复代码 -
• 每个槽位从 32 位中提取 op / rd / rs1 / rs2 / imm五个字段 -
• r0硬连零:rs1或rs2等于 0 时操作数取 0,不访问寄存器堆 -
• rs1_v / rs2_v是组合读出的操作数值,仿真时立即生效 -
• we / wadr / wdat是每个槽位的写回端口,由后续 always_comb 驱动
3.5 ALU 通用运算与符号扩展
       function automatic logic [XLEN-1:0] alu_func(
        input logic [3:0]         opc,
        input logic [XLEN-1:0]    a,
        input logic [XLEN-1:0]    b,
        input logic signed [12:0] im
    );
        case (opc)
            OP_ADD:  alu_func = a + b;
            OP_SUB:  alu_func = a - b;
            OP_AND:  alu_func = a & b;
            OP_OR:   alu_func = a | b;
            OP_XOR:  alu_func = a ^ b;
            OP_ADDI: alu_func = a + {{(XLEN-13){im[12]}}, im};
            default: alu_func = '0;
        endcase
    endfunction

    function automatic logic [XLEN-1:0] sext13(input logic signed [12:0] im);
        return {{(XLEN-13){im[12]}}, im};
    endfunction
-
• alu_func把六种算术逻辑运算集中在一个函数里,供 ALU0 和 ALU1 共用 -
• OP_ADDI先把 13 位立即数符号扩展到 32 位,再加到a上 -
• sext13专门做 13 位到 32 位的符号扩展,供分支和访存地址计算复用 -
• 函数声明为 automatic,避免综合工具误判为静态存储
3.6 Slot0:ALU0 + 分支 + HALT
       always_comb begin
        we[S_ALU0]   = 1'b0;
        wadr[S_ALU0] = rd[S_ALU0];
        wdat[S_ALU0] = '0;
        br_taken     = 1'b0;
        br_target    = '0;
        halt_now     = 1'b0;
        case (op[S_ALU0])
            OP_ADD, OP_SUB, OP_AND, OP_OR, OP_XOR: begin
                wdat[S_ALU0] = alu_func(op[S_ALU0], rs1_v[S_ALU0], rs2_v[S_ALU0], imm[S_ALU0]);
                we[S_ALU0]   = 1'b1;
            end
            OP_ADDI: begin
                wdat[S_ALU0] = alu_func(OP_ADDI, rs1_v[S_ALU0], '0, imm[S_ALU0]);
                we[S_ALU0]   = 1'b1;
            end
            OP_BEQ:  begin br_taken = (rs1_v[S_ALU0] == rs2_v[S_ALU0]); br_target = pc + sext13(imm[S_ALU0]); end
            OP_BNE:  begin br_taken = (rs1_v[S_ALU0] != rs2_v[S_ALU0]); br_target = pc + sext13(imm[S_ALU0]); end
            OP_JMP:  begin br_taken = 1'b1;                             br_target = pc + sext13(imm[S_ALU0]); end
            OP_HALT: halt_now = 1'b1;
            default: ;
        endcase
    end
-
• Slot0 是唯一带控制流能力的槽位 -
• 算术逻辑运算与 ALU1 完全一致,区别只在于额外支持分支和 HALT -
• 分支目标是 pc + 符号扩展后的 13 位立即数,即 PC 相对寻址 -
• br_taken / br_target / halt_now是组合信号,下一周期 PC 立即响应 -
• 分支解析在组合逻辑中完成,没有流水线延迟
3.7 Slot1:ALU1
       always_comb begin
        we[S_ALU1]   = 1'b0;
        wadr[S_ALU1] = rd[S_ALU1];
        wdat[S_ALU1] = '0;
        case (op[S_ALU1])
            OP_ADD, OP_SUB, OP_AND, OP_OR, OP_XOR: begin
                wdat[S_ALU1] = alu_func(op[S_ALU1], rs1_v[S_ALU1], rs2_v[S_ALU1], imm[S_ALU1]);
                we[S_ALU1]   = 1'b1;
            end
            OP_ADDI: begin
                wdat[S_ALU1] = alu_func(OP_ADDI, rs1_v[S_ALU1], '0, imm[S_ALU1]);
                we[S_ALU1]   = 1'b1;
            end
            default: ;
        endcase
    end
-
• Slot1 是纯算术逻辑单元,不支持分支或访存 -
• 结构与 Slot0 的算术部分一致,但没有 br_taken等控制信号 -
• 两个 ALU 并行可以让“加法 + 减法”这类组合在一个周期内完成 -
• 写回端口独立,最终由寄存器堆写回逻辑统一仲裁
3.8 Slot2:MUL
       always_comb begin
        we[S_MUL]   = 1'b0;
        wadr[S_MUL] = rd[S_MUL];
        wdat[S_MUL] = '0;
        if (op[S_MUL] == OP_MUL) begin
            wdat[S_MUL] = $signed(rs1_v[S_MUL]) * $signed(rs2_v[S_MUL]);
            we[S_MUL]   = 1'b1;
        end
    end
-
• Slot2 只做乘法,操作码不匹配时写使能保持为 0 -
• $signed强转让乘法按有符号数处理,结果为 32 位截断 -
• 单周期乘法在 FPGA 上通常映射到 DSP 资源,仿真时行为一致 -
• 写回端口独立,与 ALU0/ALU1/LSU 并列
3.9 Slot3:LSU
       logic [XLEN-1:0] lsu_addr;
    assign lsu_addr = rs1_v[S_LSU] + sext13(imm[S_LSU]);

    always_comb begin
        we[S_LSU]   = 1'b0;
        wadr[S_LSU] = rd[S_LSU];
        wdat[S_LSU] = '0;
        if (op[S_LSU] == OP_LW) begin
            wdat[S_LSU] = dmem[lsu_addr[$clog2(DMEM_WORDS)-1:0]];
            we[S_LSU]   = 1'b1;
        end
    end

    always_ff @(posedge clk) begin
        if (op[S_LSU] == OP_SW && !halted)
            dmem[lsu_addr[$clog2(DMEM_WORDS)-1:0]] <= rs2_v[S_LSU];
    end
-
• lsu_addr是基址寄存器加 13 位符号扩展立即数,即典型的LW rd, imm(rs1)寻址 -
• LW在组合逻辑中从dmem读出,走写回路径进入寄存器堆 -
• SW在时钟上升沿写入dmem,与寄存器堆写回互不干扰 -
• !halted保证 HALT 之后不再产生新的存储写 -
• 地址截断到 $clog2(DMEM_WORDS)位,简单环绕寻址
3.10 寄存器堆写回仲裁
       integer rst_i;
    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            for (rst_i = 0; rst_i < N_REGS; rst_i = rst_i + 1) regs[rst_i] <= '0;
        end else if (!halted) begin
            if (we[S_ALU0] && wadr[S_ALU0] != 5'd0) regs[wadr[S_ALU0]] <= wdat[S_ALU0];
            if (we[S_ALU1] && wadr[S_ALU1] != 5'd0) regs[wadr[S_ALU1]] <= wdat[S_ALU1];
            if (we[S_MUL ] && wadr[S_MUL ] != 5'd0) regs[wadr[S_MUL ]] <= wdat[S_MUL ];
            if (we[S_LSU ] && wadr[S_LSU ] != 5'd0) regs[wadr[S_LSU ]] <= wdat[S_LSU ];
        end
    end
-
• 复位时所有寄存器清零, r0之后也会被写保护挡住 -
• 四个写端口按 ALU0 → ALU1 → MUL → LSU 的顺序排列 -
• 非阻塞赋值让同周期多个写同一寄存器时,后面的覆盖前面的 -
• wadr != 5'd0保护r0永远不会被写入 -
• 编译器应避免同周期多写同一寄存器,这里只做兜底
3.11 PC 与 halted
       assign next_pc = br_taken ? br_target : (pc + 1'b1);

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            pc     <= '0;
            halted <= 1'b0;
        end else if (!halted) begin
            if (halt_now) halted <= 1'b1;
            else          pc     <= next_pc;
        end
    end

    assign pc_out = pc;
-
• 分支命中时 next_pc = br_target,否则顺序加一 -
• halted一旦置位,PC 停止更新,寄存器堆和 dmem 也不再写入 -
• pc_out暴露到顶层端口,方便 TB 或波形观察当前执行位置 -
• 复位信号低有效,同步释放到 PC 和 halted
3.12 初始化
       initial begin
        for (int k = 0; k < IMEM_WORDS; k++) imem[k] = '0;
        for (int k = 0; k < DMEM_WORDS; k++) dmem[k] = '0;
        if (INIT_FILE != "") $readmemh(INIT_FILE, imem);
    end
-
• initial块把imem和dmem清零,避免 X 态传播 -
• INIT_FILE非空时用$readmemh从十六进制文件加载指令 -
• 这个块在 Verilator 中第一次 eval()时执行,C++ TB 会先 eval 再写内存 -
• 清零操作在仿真开始时只做一次,不影响后续运行
🧪 第四章:Verilator + C++ 测试平台
4.1 头文件与辅助函数
   #include "Vvliw_cpu.h"
#include "Vvliw_cpu___024root.h"   // 让 rootp 类型完整
#include "verilated.h"

#include <cstdio>
#include <cstdint>

static void tick(Vvliw_cpu* d) {
    d->clk = 0; d->eval();
    d->clk = 1; d->eval();
}
-
• Vvliw_cpu.h是 Verilator 生成的外层接口头文件 -
• Vvliw_cpu___024root.h包含内部状态类的完整定义,必须显式包含才能访问rootp -
• tick函数执行一个完整时钟周期:先低电平 eval,再高电平 eval -
• 两次 eval()分别对应组合逻辑稳定和时钟沿触发
4.2 长指令写入函数
   // imem 类型为 VlUnpacked<VlWide<4>, IMEM_WORDS>
// VlWide 用 operator[] 访问 32 位字:[0]=slot0, [1]=slot1, ...
static void put(VlUnpacked<VlWide<4>, 1024>& imem, int idx,
                uint32_t s0, uint32_t s1, uint32_t s2, uint32_t s3) {
    imem[idx][0] = s0;
    imem[idx][1] = s1;
    imem[idx][2] = s2;
    imem[idx][3] = s3;
}
-
• VlUnpacked<VlWide<4>, 1024>是 Verilator 对 128 位数组的 C++ 表示 -
• 模板参数 4表示 4 个 32 位字,1024对应IMEM_WORDS -
• VlWide用operator[]访问每个 32 位字,而不是.words -
• put把一条长指令的四个槽位按顺序写入imem[idx]
4.3 main 初始化
   int main(int argc, char** argv) {
    Verilated::commandArgs(argc, argv);
    auto* dut = new Vvliw_cpu;

    // 先 eval 一次,让 RTL 的 initial 块执行完
    dut->eval();

    auto& root = *dut->rootp;
    auto& imem = root.vliw_cpu__DOT__imem;
    auto& dmem = root.vliw_cpu__DOT__dmem;
    auto& regs = root.vliw_cpu__DOT__regs;
-
• Verilated::commandArgs解析 Verilator 运行时参数,标准做法 -
• new Vvliw_cpu只构造对象,此时initial块尚未执行 -
• dut->eval()第一次调用触发initial块,完成imem/dmem清零 -
• 之后再通过 rootp拿到imem / dmem / regs三个内部数组的引用 -
• 如果省略这次 eval(),后续写入会被initial清零覆盖
4.4 程序写入
       // 0: LW  r1, 0(r0)
    put(imem, 0, 0x00000000, 0x00000000, 0x00000000, 0xB0800000);
    // 1: LW  r2, 1(r0)
    put(imem, 1, 0x00000000, 0x00000000, 0x00000000, 0xB1000001);
    // 2: ADD r3,r1,r2 [s0] || MUL r4,r1,r2 [s2]   <-- 真正并行
    put(imem, 2, 0x11844000, 0x00000000, 0x62044000, 0x00000000);
    // 3: ADD r5, r3, r4
    put(imem, 3, 0x128C8000, 0x00000000, 0x00000000, 0x00000000);
    // 4: SW  r5, 2(r0)
    put(imem, 4, 0x00000000, 0x00000000, 0x00000000, 0xC000A002);
    // 5: HALT
    put(imem, 5, 0xF0000000, 0x00000000, 0x00000000, 0x00000000);

    dmem[0] = 10;
    dmem[1] = 20;
-
• 前两条 LW把dmem[0]=10和dmem[1]=20载入r1和r2 -
• 第三条是 VLIW 的核心演示: ADD r3和MUL r4在同一长指令的两个槽位并行 -
• 第四条依赖前一条的结果,必须放在下一个周期 -
• 第五条把 r5写回dmem[2],用于验证存储写入 -
• 最后一条 HALT 让 CPU 停止,TB 跳出循环
4.5 复位与仿真循环
       dut->rst_n = 0;
    for (int i = 0; i < 4; i++) tick(dut);
    dut->rst_n = 1;

    int cycles = 0;
    while (!dut->halted && cycles < 10000) { tick(dut); cycles++; }
    for (int i = 0; i < 2; i++) tick(dut);
-
• 复位保持 4 个周期,确保 PC、halted、regs 全部稳定 -
• 释放复位后进入主循环,每个 tick 推进一个周期 -
• cycles < 10000是超时保护,防止程序跑飞时死循环 -
• HALT 之后再多跑两个周期,让最后一条写回稳定
4.6 结果检查
       int fails = 0;
    auto check = [&](const char* name, uint32_t got, uint32_t expect) {
        if (got != expect) { std::printf("FAIL %-8s got=%u expect=%u\n", name, got, expect); fails++; }
        else               { std::printf("PASS %-8s = %u\n", name, got); }
    };

    std::printf("cycles = %d, halted = %d\n", cycles, dut->halted);
    check("r1",      regs[1],  10);
    check("r2",      regs[2],  20);
    check("r3",      regs[3],  30);
    check("r4",      regs[4],  200);
    check("r5",      regs[5],  230);
    check("dmem[2]", dmem[2],  230);

    delete dut;
    std::printf("%s\n", fails ? "==== TEST FAILED ====" : "==== ALL PASS ====");
    return fails ? 1 : 0;
}
-
• checklambda 统一处理 PASS/FAIL 输出,失败时累加计数 -
• r3 = r1 + r2 = 30,验证 ALU0 槽 -
• r4 = r1 * r2 = 200,验证 MUL 槽 -
• r5 = r3 + r4 = 230,验证跨周期依赖 -
• dmem[2] = r5 = 230,验证 LSU 写存储 -
• 返回非零退出码让 CTest 能判定失败
4.7 指令编码的手工汇编 🧮
因为还没写编译器,测试程序靠手工编码。以第 2 条 ADD r3, r1, r2 为例:
   op=1(ADD) | rd=3 | rs1=1 | rs2=2 | imm=0
= 0001 00011 00001 00010 0_0000_0000_0000
= 0x11844000
MUL r4, r1, r2 同理:0x62044000。把它们填进 slot0 和 slot2,其余槽位填 NOP 的 0x00000000,就得到 put(imem, 2, 0x11844000, 0x00000000, 0x62044000, 0x00000000)。这条指令一个周期内完成加法和乘法,速度提升 2×,这就是 VLIW 的魅力。⚡
🛠️ 第五章:工程组织
5.1 Verilator 与可执行文件
   cmake_minimum_required(VERSION 3.20)
project(vliw_cpu LANGUAGES CXX)

set(CMAKE_CXX_STANDARD 17)
set(CMAKE_CXX_STANDARD_REQUIRED ON)

find_package(verilator REQUIRED)

add_executable(tb_vliw tb/tb_vliw.cpp)

verilate(tb_vliw
    SOURCES rtl/vliw_cpu.sv
    TOP_MODULE vliw_cpu
    PREFIX Vvliw_cpu
    VERILATOR_ARGS
        --public-flat-rw
        -Wno-fatal
        -Wno-UNUSED
        -Wno-DECLFILENAME
        -Wno-VARHIDDEN
        -Wno-CASEINCOMPLETE
        -Wno-lint
)
-
• find_package(verilator)找到系统里的 Verilator 并加载verilate()宏 -
• add_executable声明 C++ TB 目标,源文件只有tb_vliw.cpp -
• SOURCES指定 RTL 源文件,可以是多个 -
• TOP_MODULE指定顶层模块名,必须与 RTL 里一致 -
• PREFIX决定生成的头文件名,这里是Vvliw_cpu.h -
• --public-flat-rw让public_flat_rw注解生效,C++ 可直接读写内部数组 -
• 一串 -Wno-*关掉与教学无关的风格警告
5.2 CTest 与运行目标
   enable_testing()
add_test(NAME vliw_test COMMAND tb_vliw)
set_tests_properties(vliw_test PROPERTIES WORKING_DIRECTORY ${CMAKE_BINARY_DIR})

add_custom_target(run
    COMMAND tb_vliw
    DEPENDS tb_vliw
    WORKING_DIRECTORY ${CMAKE_BINARY_DIR}
    COMMENT "Running VLIW simulation"
)
-
• enable_testing()打开 CTest 支持 -
• add_test把tb_vliw注册为一个测试用例 -
• WORKING_DIRECTORY设到构建目录,避免相对路径问题 -
• add_custom_target(run)提供一个make run的快捷方式 -
• DEPENDS tb_vliw保证先构建可执行文件再运行
5.3 工程结构
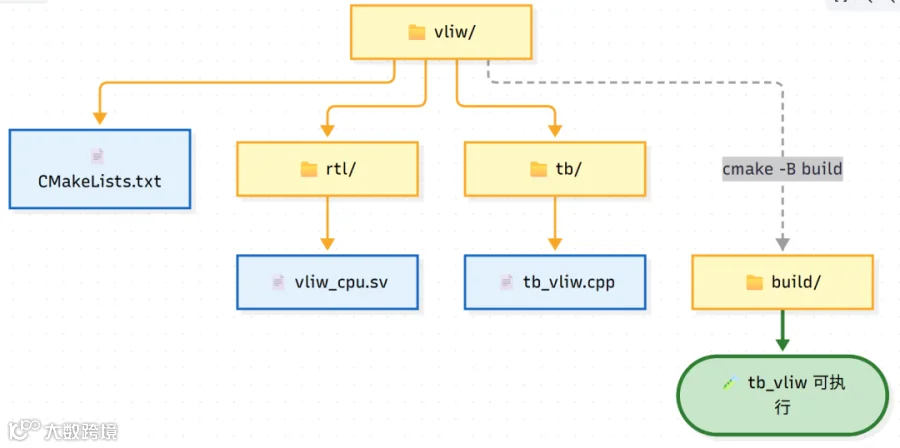
5.4 一条命令跑完全流程
   cmake -B build
cmake --build build -j
ctest --test-dir build --output-on-failure
-
• 第一条生成构建目录并配置项目 -
• 第二条并行编译 RTL 和 C++ TB -
• 第三条通过 CTest 运行测试,失败时输出完整日志
📊 第六章:最终成果与验证
运行结果:
   cycles = 7, halted = 1
PASS r1      = 10
PASS r2      = 20
PASS r3      = 30
PASS r4      = 200
PASS r5      = 230
PASS dmem[2] = 230
==== ALL PASS ====
程序执行流程:
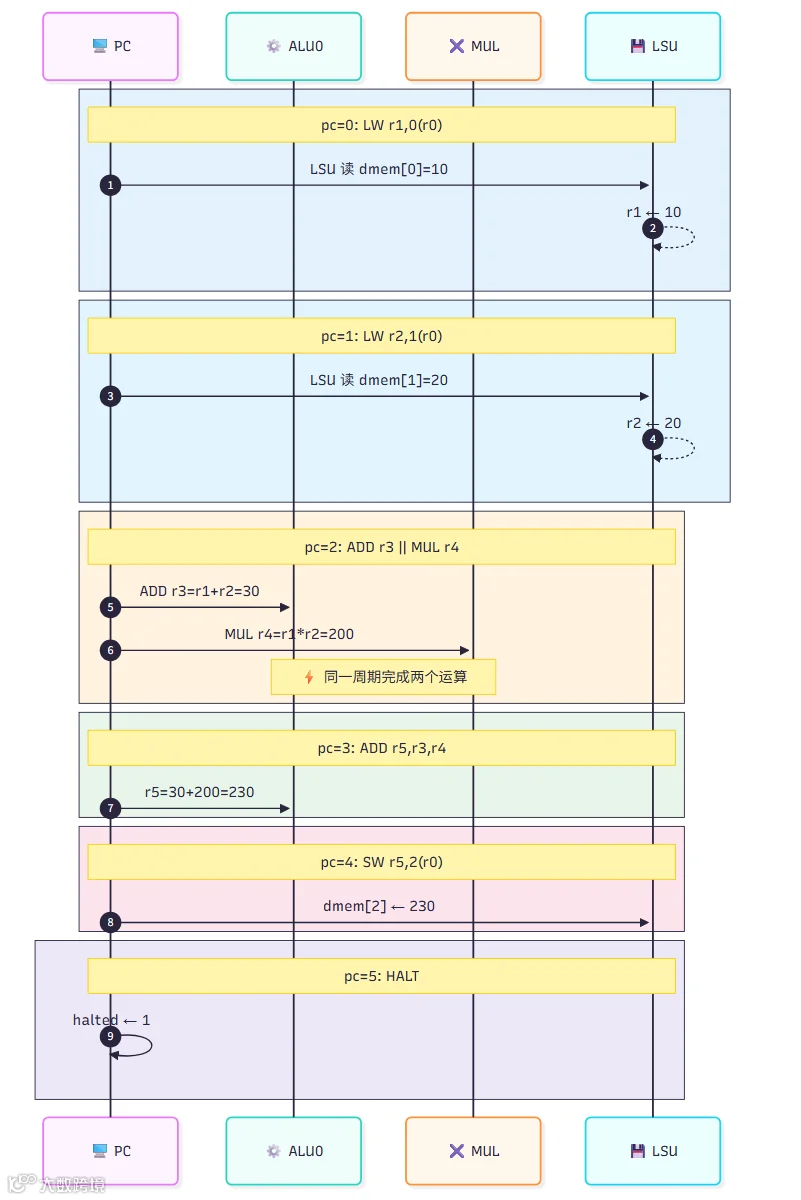
7 个周期跑完,其中 pc=2 那条指令一周期完成加法和乘法,这就是 VLIW 并行性的直接体现。
🤔 第七章:思考与延伸
7.1 这个设计“不 VLIW”的地方
作为教学原型,它简化了几件事。没有功能单元延迟:真实 VLIW(如 C6x)的 MUL 要 3~5 周期,需要软件流水,我们假设所有单元单周期。没有寄存器堆多端口压力:真实设计里 4 个槽位同时读 8 个操作数,端口数爆炸。没有谓词执行(predication):真实 VLIW 用谓词消分支,我们只有跳转。没有软件流水和循环展开:这是 VLIW 性能的关键,必须靠编译器。
7.2 下一步可以做什么?
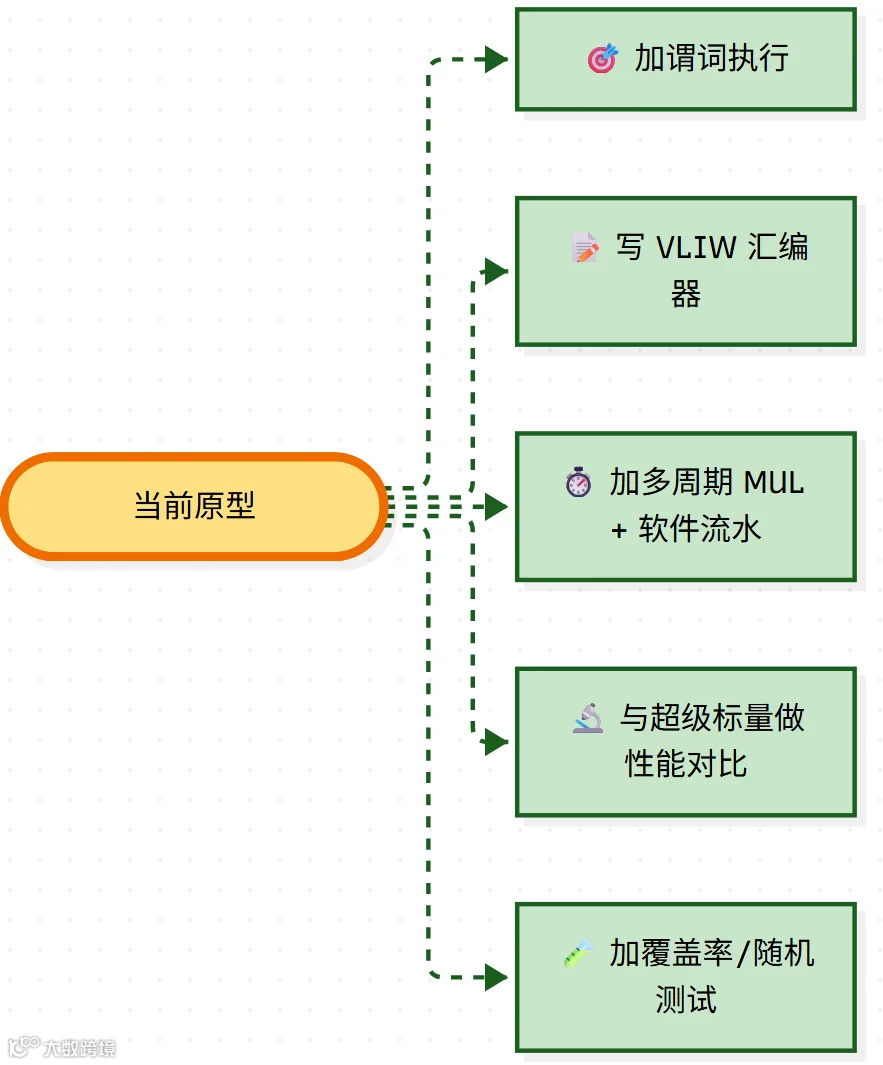
我最想做的下一步是写一个简单的 VLIW 汇编器,把“手算十六进制”的苦差事自动化。之后再往上接一个玩具编译器(或至少是带调度器的汇编器),就能真正体验“编译器决定并行度”的 VLIW 哲学了。
7.3 为什么值得做这个项目?
RTL 能力上,220 行覆盖了译码、功能单元、写回仲裁、PC 逻辑,麻雀虽小五脏俱全。工具链能力上,Verilator + CMake 是现代开源芯片验证的常用组合。体系结构直觉上,亲手实现过才真正理解“ILP 是一种资源,谁来决定使用它是一种权衡”。
🎬 结语
从一条 128 位的长指令,到 CMake 里的一个 add_executable,再到 CTest 里一条 PASS,这条链路把芯片设计、验证与工程化串成了一体。VLIW 是一个绝佳的学习载体:它的硬件简单到能看全貌,它的软件复杂到能玩一年,它的历史又足够有故事性。
这个项目最有价值的经验是:工具的行为模型和直觉不一致时,先怀疑直觉。Verilator 不是仿真器,它是编译器;initial 不是构造,它是一次性过程。理解工具的真实语义,比背诵它的 API 重要得多。
希望这篇博客能帮到同样想手搓 VLIW 的你。如果踩到新坑,欢迎回来补充。🍻
PS:所有代码均已在 Verilator 5.x + CMake 3.28 + Ubuntu 22.04 环境验证通过。祝玩得开心!🎉