

0
1
为什么你的测试团队需要AI?
1.1 测试人员的三大烦恼
想象一下,你是一个测试工程师,每天面对这些场景:
场景一:页面改版,脚本全崩
产品经理在群里说“按钮换个样式,更圆润一些”,你心里咯噔一下:昨天刚跑通的50个脚本,今天又得熬夜改定位器了。这已经是本月第三次因为UI微调而批量修改脚本了。
场景二:造数据比测Bug还累
测试一个“满100减20”的优惠券功能,需要准备10种不同金额的订单、5种优惠券类型、3种用户等级。手动造数据要半天,写SQL更是心累,数据之间的关联关系经常搞错。
场景三:失败用例查不出原因
凌晨CI跑挂了,报告只有一行“期望页面显示‘支付成功’,实际显示‘系统繁忙’”。你翻日志、查截图、问开发,折腾2小时才发现是测试环境的支付网关配置过期了,而测试脚本根本不会告诉你这个。
这些烦恼,本质上是因为传统自动化测试缺乏理解能力——它只会机械执行指令,无法理解页面变化背后的语义,无法构造复杂业务场景的数据,无法从错误中推理根因。
1.2 AI大模型能做什么?
AI大模型(如GPT-4、Claude)就像是一个“懂测试的实习生”——它读过海量代码和文档,能理解自然语言,还能进行一定程度的推理。以下是它在测试领域的实际能力:
测试活动 |
AI能做什么 |
打个比方 |
写用例 |
读懂需求文档,自动生成测试点和边界场景 |
像一位细心的人,读完需求就帮你列好测试清单,连边界都想到了 |
写脚本 |
理解自然语言,自动生成可执行的测试代码 |
像一位代码助手,你说“登录后检查用户名”,它就帮你写好完整的Playwright代码 |
造数据 |
根据业务规则,生成真实多样的测试数据 |
像一位数据专员,你要10个不同等级的用户,它分分钟给你,还带上手机号、地址等关联信息 |
查问题 |
分析失败日志,推断根因并给出修复建议 |
像一位老测试,看一眼日志就知道是数据过期还是代码变更,甚至告诉你该怎么改 |
修脚本 |
当元素定位失效时,尝试找到新的定位方式 |
像一位聪明的导航,原路不通时,自动帮你重新规划路线 |
关键认知:AI不是来取代测试工程师的,而是来“干掉”那些重复、繁琐、低价值的工作,让我们把时间花在探索性测试、场景设计、质量策略上。未来测试工程师的核心竞争力,将是“懂业务 + 会编程 + 善用AI”。
0
2
四个场景:AI如何融入测试工作流
场景1:智能用例生成——让AI读懂需求
痛点:人工写用例,费时又容易遗漏
一份10页的PRD,测试人员需要逐字阅读,提炼测试点,还要自己脑补边界情况。复杂模块(如优惠券、支付)往往需要2-3小时才能写出一份像样的用例清单,而且容易遗漏一些边界组合(比如“满减券+折扣券同时存在”这种场景)。
解决方案:AI读需求,人审质量
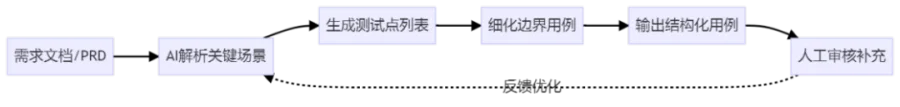
图1:AI智能用例生成流程
就像让一位资深测试阅读需求后写出用例草稿,AI负责“初稿”,人工负责“把关”。人工审核时发现遗漏的场景,可以反馈给AI,让它下次生成时更全面。经过2-3轮迭代,AI就能很好地掌握业务风格。
实操案例:优惠券功能
需求原文(电商优惠券功能,来自PRD):
用户下单后可使用优惠券,优惠券分为满减券(满100减20)和折扣券(85折)。系统自动选择最优优惠,不可叠加使用。订单金额小于门槛时不可使用。优惠券有有效期,过期不可用。
AI生成的测试用例(GPT-4输出,经过格式整理):
# 正常场景
场景:满减券满足门槛
假设订单金额为150元
并且用户有一张满100减20的满减券
当用户使用优惠券
那么订单金额变为130元

# 边界场景
场景:订单金额等于优惠门槛
假设订单金额为100元
并且用户有一张满100减20的满减券
当用户使用优惠券
那么订单金额变为80元

场景:订单金额刚好低于门槛
假设订单金额为99.99元
并且用户有一张满100减20的满减券
当用户使用优惠券
那么提示“不满足使用条件”

# 最优选择场景
场景:折扣券与满减券同时存在
假设订单金额为200元
并且用户有满减券(减20)和折扣券(85折)
当系统自动选择优惠
那么系统选择折扣券,订单金额变为170元

# 时间相关场景
场景:优惠券已过期
假设订单金额为150元
并且用户有一张满100减20的满减券,有效期昨天结束
当用户使用优惠券
那么 提示“优惠券已过期”
AI不仅生成了正常场景,还主动补充了边界场景(等于、低于门槛)、组合场景(两种券同时存在)、时间场景(过期)——这些都是人容易遗漏的,而AI通过训练数据中大量类似案例,天然具备这种“边界意识”。
落地细节:如何让AI生成更高质量的用例?
1、明确输入格式:不要直接把PRD全文丢给AI,而是先提取关键业务规则,以结构化方式输入:
请根据以下业务规则生成Gherkin格式的测试用例:
- 规则1:满减券满100减20
- 规则2:折扣券85折
- 规则3:不可叠加,自动选最优
- 规则4:金额小于门槛不可用
- 规则5:有效期限制
2、使用统一的输出模板:要求AI按照指定格式输出,方便后续导入测试管理工具(如Jira、TestRail):
请以以下格式输出:
【场景名称】
前置条件:...
操作步骤:...
预期结果:...
3、建立反馈循环:每次人工审核后,将补充的用例作为“正例”反馈给AI,通过few-shot学习提升质量。
效率数据
传统方式:复杂模块用例设计平均4小时
AI辅助:AI生成30分钟 + 人工审核30分钟 = 1小时
效率提升:75%
场景2:智能脚本生成——用自然语言写代码
痛点:写脚本费时,定位器容易失效
一个登录功能的脚本,看似简单,但要考虑等待、断言、异常处理,新手可能要写半小时。更头疼的是,定位器(如#username)一旦被开发改了,脚本就挂了。
解决方案:AI理解意图,自动生成稳定脚本
图2:自然语言到自动化脚本的转换
就像对助理说“帮我订个外卖”,AI自动完成下单、支付、跟踪。你说“测试登录”,AI自动生成包含定位、输入、点击、断言的完整代码。
实操案例:用GitHub Copilot生成登录脚本
你在代码中写下注释(支持自然语言):
// 测试登录功能:访问登录页,输入用户名test@example.com,密码123456,点击登录,验证跳转到首页并显示用户名
Copilot自动补全(按Tab接受):
test('登录功能', async ({ page }) => {
await page.goto('https://example.com/login');
await page.fill('#username', 'test@example.com');
await page.fill('#password', '123456');
await page.click('button[type="submit"]');
await expect(page).toHaveURL('https://example.com/dashboard');
await expect(page.locator('.user-name')).toHaveText('test@example.com');
});
AI不仅生成了代码,还自动添加了等待(fill内部已含等待)和断言,比很多新手写的还规范。
进阶:让AI推荐稳定的定位器
当元素属性经常变化时,告诉AI你的困境:
输入:需要定位“提交订单”按钮,id和class经常变,但页面有唯一文本“提交订单”,请推荐最稳定的定位方式
AI会输出:
// 推荐方案1:基于角色和名称(最稳定)
await page.getByRole('button', { name: '提交订单' }).click();
// 推荐方案2:基于文本(次稳定)
await page.getByText('提交订单').click();
// 不推荐:基于CSS选择器(易失效)
await page.locator('#submit-btn').click();
对比说明:
getByRole:不依赖具体属性,只要按钮的role和文本不变,就能稳定定位。
getByText:依赖文本,如果按钮文字改了(如“提交”变“确认”),就会失效。
CSS选择器:依赖id/class,最容易因UI改动而失效。
落地细节:如何让AI生成高质量的脚本?
使用最新的Playwright API:在提示词中明确“请使用Playwright的最新API”,AI会优先使用getByRole、getByText等稳定定位器。
添加等待策略:如果页面有异步加载,告诉AI“等待某个元素出现后再操作”,它会自动插入waitForSelector。
异常处理:可以让AI生成重试逻辑,比如:
await expect(page.locator('.result')).toHaveText('成功', { timeout: 10000 });
效率数据:
传统方式:编写10个测试用例的脚本平均8小时
AI辅助:AI生成2小时 + 人工调试1小时 = 3小时
效率提升:62%
痛点:测试数据是“隐形成本”
一个支付功能测试,需要准备:
· 正常金额(100元、200元...)
· 边界金额(0.01元、100.00元、9999.99元)
· 异常金额(负数、非数字、超长)
· 特殊场景(组合支付、优惠券抵扣、分期支付)
手动构造这些数据,往往需要编写SQL脚本或调用API,还要保证数据之间的关联关系(如用户、订单、优惠券)。这个过程比写测试用例还花时间,而且容易遗漏边界。
解决方案:AI根据业务规则生成结构化数据
提示词模板(可以设计成可复用的):
请生成10条用户注册测试数据,包含以下字段:- 用户名:6-12位字母数字,不能以数字开头- 邮箱:有效格式,支持常见域名(@example.com, @test.com)- 手机号:中国大陆手机号,11位数字,以1开头
- 密码:至少8位,包含大小写字母和数字,允许特殊字符
同时生成3条边界数据:- 用户名超长(>12位)- 邮箱无@符号- 手机号包含字母
以JSON格式输出,分为normal和boundary两个数组。
AI输出(部分):
{"normal": [{"username": "alice123","email": "alice@example.com","phone": "13812345678","password": "Alice@2025","description": "正常用户"},{"username": "bob_test","email": "bob@test.com","phone": "15987654321","password": "Bob#1234","description": "正常用户"}],"boundary": [{"username": "thisisaverylongusernamethatexceeds12chars","email": "invalid","phone": "abcd12345","password": "short","description": "边界:用户名超长,邮箱无效,手机号含字母,密码过短"}]}
AI不仅生成了正常数据,还自动准备了边界异常数据,覆盖了测试人员容易遗漏的场景。
集成到测试框架:数据驱动测试
// 使用AI生成的数据进行数据驱动测试import testData from './generated_data.json';test.describe('用户注册测试', () => {for (const data of testData.normal) {test(`注册用户: ${data.username}`, async ({ page }) => {await page.goto('/register');await page.fill('#username', data.username);await page.fill('#email', data.email);await page.fill('#phone', data.phone);await page.fill('#password', data.password);await page.click('button[type="submit"]');await expect(page.locator('.success-message')).toBeVisible();});}for (const data of testData.boundary) {test(`边界测试: ${data.description}`, async ({ page }) => {await page.goto('/register');await page.fill('#username', data.username);await page.fill('#email', data.email);await page.click('button[type="submit"]');// 预期错误提示await expect(page.locator('.error-message')).toBeVisible();});}});
落地细节:如何让AI生成符合业务规则的数据?
提示词要具体:不要只说“生成用户数据”,要明确字段类型、长度、格式、关联关系。
使用few-shot示例:如果AI第一次生成的质量不好,可以给它几个正确的示例,让它模仿。
后处理校验:对AI生成的数据进行二次校验,比如用正则验证手机号格式,过滤无效数据。
数据工厂模式:将AI生成的数据保存为JSON文件,测试脚本动态读取。需要刷新数据时,重新运行AI生成脚本。
效率数据:
传统方式:准备10组测试数据平均2小时(包括设计SQL、执行、清理)
AI辅助:编写提示词10分钟 + AI生成5分钟 = 15分钟
效率提升:87%
......
本文节选自第九十二期《51测试天地》
原创文章
《智测未来:用AI大模型重塑Web自动化测试》
文章后续为大家详细讲解了:
AI模型怎么选、AI测试流水线与避坑指南等
想继续阅读全文
或查看更多《51测试天地》的原创文章
请点击下方 阅读原文或扫描二维码 查看
声明:本文为51Testing软件测试网 半夏 用户投稿内容,该用户投稿时已经承诺独立承担涉及知识产权的相关法律责任,并且已经向51Testing承诺此文并无抄袭内容。发布本文的用途仅仅为学习交流,不做任何商用,未经授权请勿转载,否则作者和51Testing有权追究责任。如果您发现本公众号中有涉嫌抄袭的内容,欢迎发送邮件至:editor@51testing.com进行举报,并提供相关证据,一经查实,将立刻删除涉嫌侵权内容。