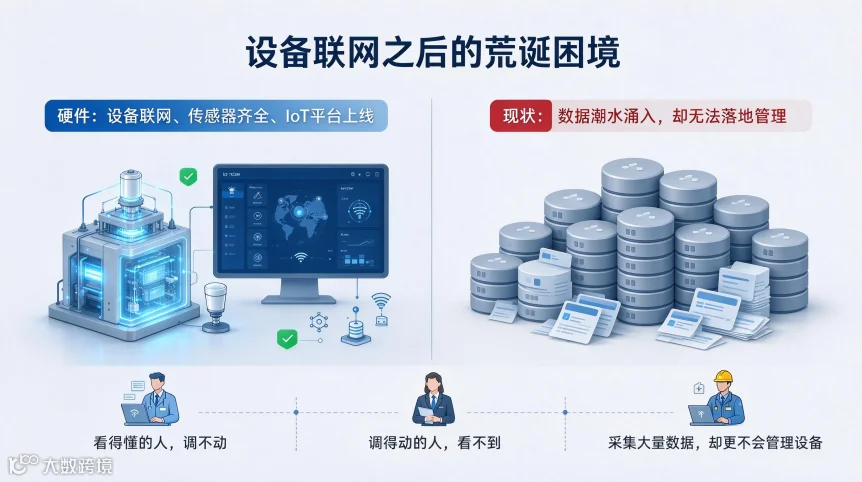
很多企业花大价钱把设备连上网、装上传感器、上了物联网平台,数据像潮水一样涌进来。然后呢?
数据躺在库里,没人看。看得懂的人,调不动。调得动的人,看不到。一个有点荒诞的现实出现了:我们采集了前所未有的数据,却比没数据时更不会管设备了。
这不是某一家企业的困境。2025 到 2026 年,AI与物联网的融合从概念演示走向真实产线,多家分析机构的行业报告都指向同一个判断——预测性维护、能耗优化这类“用数据做决策”的场景,正从试点走向规模化落地。但另一边,大量企业的 IoT 平台,还停在“数据展厅”阶段:大屏很漂亮,决策靠经验。
设备和数据都到位了,中间缺的那一环,是把数据变成管理动作的能力。而这种能力,恰恰最难被一次性买断——它得一点点长出来。
先说最直观的那层:黑盒盲区。
设备分散在不同厂区、不同城市、不同门店,有的在车间深处,有的在野外站点。它们的状态,对管理者来说长期是个黑盒。今天这台离线,明天那台温度异常,后天气压不稳,这些信号散落在各自的系统里,没有汇到同一个人眼前。
一个很常见的画面:某制造企业的几千台设备分布在多个基地,半夜一台关键机组悄悄出现异常。告警弹了出来,但淹没在当天的几百条消息里。等到第二天产线停了、订单延误了,人才知道“昨晚那台设备不对劲”。设备不是没报警,是报警了没人接得住。
这种黑盒不是一天形成的。设备来自不同厂家、不同批次,通信协议五花八门,各自的监控系统各行其是。状态天然是割裂的,没有人被默认为“这台设备的全局负责人”。于是每台设备都在自己的小世界里报喜不报忧,等到它彻底罢工,才被迫进入所有人的视野。
比“看不见”更麻烦的,是“看不懂”。即便数据被采上来,故障来了,往往只知道“某设备异常”,不知道根因在哪、影响范围多大、该派谁去。运维人员像救火队员,哪里冒烟往哪里跑,跑完一场还有下一场。问题不是修得慢,是永远修不完——因为没有人记得住几千台设备各自的历史。
再往深一层,是数据本身的负担。一台设备一天能产生成百上千条运行数据,几千台就是天文数字。这些数据存哪里、怎么压缩、谁来治理,本身就是一道工程题。很多企业发现自己陷进了“采得起、存不下、看不懂”的怪圈——花大价钱把数据接进来,结果数据越多越乱,反而成了负担。
最致命的一点藏在最后:数据有了,价值没来。 采集本身不知不觉成了目的。没人追问一句:这堆数据,到底帮业务做了什么决定?当“接了多少台、采了多少TB”变成汇报里的漂亮数字,数据就完成了它的使命——除了占地方。

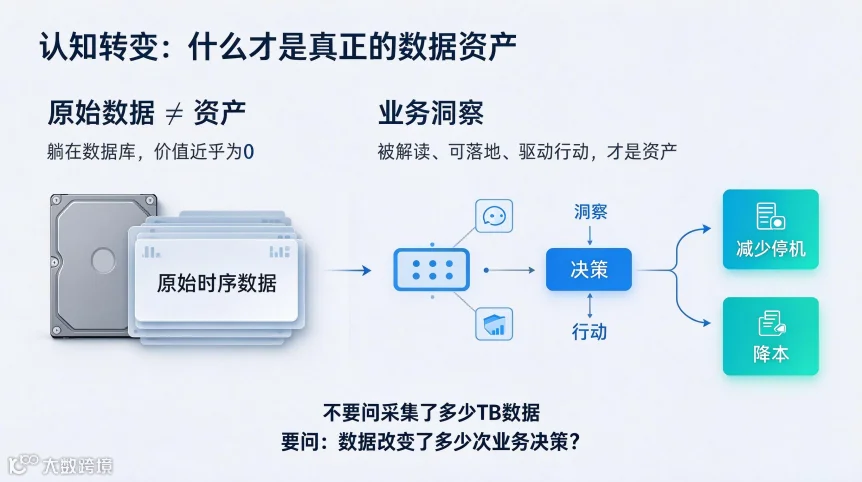
要打破这个怪圈,得先改一个根深蒂固的念头:数据本身不是资产,能被用起来的洞察才是。
一块硬盘里的原始时序数据,价值约等于零。它不会自己变成决策,不会自己降低停机,也不会自己提升产能。数据的价值,在于被解释、被翻译成行动。同样一批温度曲线,躺在库里是噪声,被模型识别成“这台压缩机正在加速老化”,就是资产。
打破黑盒,是这一切的第一步。看不见,就管不了。设备状态不可知,后面所有“用数据”的设想都是空中楼阁。你都没法回答“现在哪台设备最危险”,就谈不上让数据去驱动什么。
很多企业在这一步就跑偏了:把“我们采集了多少TB”当成绩。但真正该问的,从来不是采集量,而是——这些数据,过去一年改变了几次实际决策? 如果答案是“没几次”,那堆再大的数据,也只是电子垃圾。
从“拥有数据”到“用好数据”,是认知上的一道坎。前者是一次性投入、好量化、容易写进预算;后者是持续工程、跨部门、难在当年见效。资源的流向,天然就偏向了前者。所以“数据多却用不上”,不是偶然,是结构使然。
更隐蔽的是,不少企业把“上平台”误当成“用起来”。平台买来了,大屏亮起来了,报告自动生成了,管理层以为数字化完成了。可这些输出,有多少真正回流到了排产、维保、采购的决策里?如果数据只是在系统之间转了一圈又睡回去,那它从未离开过黑盒。
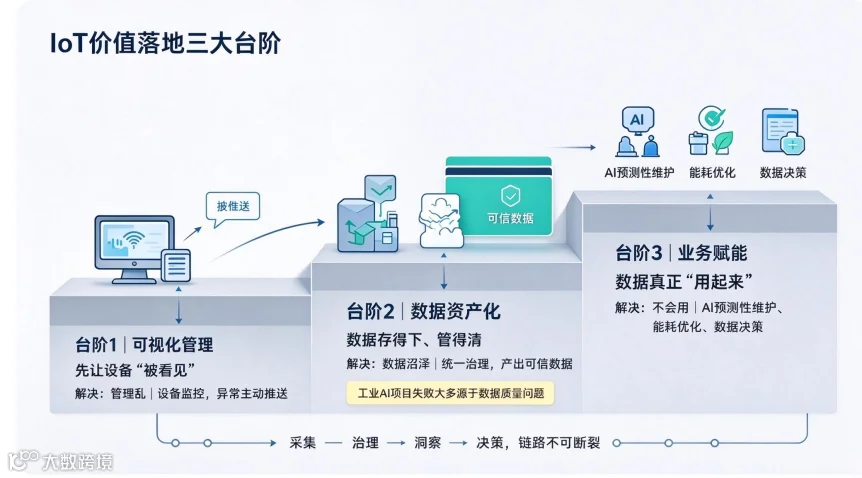
理念清楚了,落地要一步步走。中间隔着三个台阶。
第一步,可视化管理:先让设备“被看见”(解决“管理乱”)。
这一层不神秘,但要扎实。设备状态实时监控、异常精准定位,核心是让关键信息一眼可见、让问题主动找人,而不是人去翻几百条日志找问题。它不是把数据堆成一面华丽的大屏,而是把“哪台设备异常、异常在哪、影响多大”直接推到该看的人面前。
天枢物这类平台把设备状态、告警、定位放在同一张实时视图里,做的就是这件事——先把“管理乱”这一关过了,让散落各地的设备第一次在同一个画面里说话。
第二步,数据资产化:让数据“存得下、管得清”。
看得见只是前提,数据还得“治”得过来。海量时序数据不能只管采,不管存和理。合理的存储策略、统一的字段口径、可追溯的治理体系,决定这些数据未来能不能被用。
没有治理,数据越多越乱,最后形成一片“数据沼泽”:找不准、对不齐、信不过。很多企业不是没数据,是数据之间互相矛盾,谁都不敢拿它做决定。资产化这一步,就是把raw data变成trusted data。它常常被跳过,因为短期看不见收益——可跳过之后,再往上叠任何AI都建立在流沙上。
这里有一个被反复验证的行业事实:工业AI项目的卡壳点,多数不在算法,而在数据与治理。 Gartner 将 85% 的 AI 项目失败归因于数据质量不足或缺乏相关数据;制造业 AI 项目的成功率在 2024 年约为 13%,而约 70% 的项目预算花在了数据采集、准备与系统集成上,真正用于模型开发部署的只占约 20%。模型再先进,喂进去的是错位、缺失、口径不一的数据,出来的结论也不可信。所谓“智能”,得先有“干净的数据”打底。
第三步,业务赋能:让数据真正“用起来”(解决“不会用”)。
这是最有价值、也最难的一级。在治理好的数据之上叠加AI能力,数据才开始反哺业务:预测性维护,让企业从“坏了再修”变成“提前知道哪台快坏”;能耗优化,从被动缴费变成主动调优;产能提升,从凭经验排产变成看数据排产。
2026年这波AI与IoT的融合,带来了一个实质变化:模型正从“故障诊断”走向“剩余寿命预测”,边缘侧推理让实时预警不再完全依赖云端往返。这意味着数据第一次不只是被“看”,而是被“用”去做决定——设备还没坏,系统已经建议“这台该安排了”。
把三个台阶连起来看,真正稀缺的不是某一个单点能力,而是让“采集—治理—洞察—决策”不断裂的链路能力。 天枢物所做的,正是把实时监控、数据治理与AI分析放在同一条链上,让各个环节之间不再各自为政。断点补上了,数据才真正开始流动,而不是躺在库里睡大觉。
走到这一步,回报才显形。
运维方式,从“救火式”转向“预防性”。过去是设备停了、损失发生了,人才到场。现在能在故障发生前介入,把非计划停机挡在门外。省下的不只是维修费,还有订单、口碑和一连串连锁损失。
决策方式,从“经验”转向“数据”。老师傅的直觉依然宝贵,但叠加了数据佐证,判断更快、更稳、可复盘。一个年轻工程师,借助系统里的历史规律和实时信号,能做出不输资深专家的判断——这才是对人才真正的放大,而不是替代。
但这中间最难的部分,是闭环。采集、存储、治理、洞察、决策,单独看每一级都不神秘,真正难的是把它们连成一条不断裂的链路。太多项目死在“断点”上:采了没人存,存了没人理,理了没人用,用了没人反馈。任何一个环节脱节,“数据驱动”就永远停在PPT里。
闭环之所以难,因为它横跨多个团队。采集归运维,存储归IT,分析归数据团队,决策归业务——每段都做得不错,却没有一个角色为“这条链不断”负责。补上这个责任缺口,比再买一套平台更关键。
IoT的终极目标不是采集数据,而是用数据驱动业务决策。跨越“管理乱”与“不会用”,关键就在于建立从“数据采集”到“管理价值”的闭环。
如果这篇只留三句话:第一,数据不是资产,能被用起来的洞察才是;第二,打破黑盒只是起点,建立“采集—治理—洞察—决策”的闭环才是终点;第三,别再只问“接了多少台设备”,改问“这些数据,今天帮你做了几个决定”。
—END—
想进一步了解卓铸科技的产品与方案?
点击「卓铸-电子名片」小程序卡片👉卓铸-电子名片,即可查看公司简介、产品体系与专属联系方式。也可随时拨打咨询热线400-0418-918,专业团队竭诚为您服务。
内容看完有收获
点个“推荐”吧