某保险公司法务吴女士在公司领导推荐下,把自行整理加工后的公司稽核问题数据表上传至第三方AI平台,用于做PPT和数据分析。
一个月后,公司以“严重违反规章制度”为由单方解除劳动合同,法院一审判定解除违法,判决已生效。
法院列出的三条理由是:
公司从未禁止员工使用第三方AI办公,没有专项规则,也没做过培训与风险告知;
公司拿不出证据证明上传文件属于核心保密信息,也拿不出证据证明造成实际损害;
吴女士本人没有违反规章制度的主观故意。
这三条共同确认了一个前提:企业自己没把“哪些数据能用AI处理、能处理到什么程度”说清楚,就不能在出事之后要员工承担后果。
这也是瑞莱智慧在做中枢词元NexToken平台时,需要反复回答的问题。
敏感词换成字母ABC,
却仍然暴露风险?
换掉敏感词,是企业里最常见的第一反应,也是最靠不住的一种。
官方披露过一起案例:某涉密单位工作人员起草涉密材料时,把部分敏感内容替换成字母代码,再输入AI写作工具辅助生成文稿,仍然导致涉密信息暴露风险陡增,本人受到严肃处理。
字母代码替换只处理了词面,无法消除上下文中的可识别线索。
合同的类型、条款结构、行业惯例、时间节点、地域范围都留在文本里,加上用户的连续追问,几处线索一交叉,替代词就失去意义。
多轮对话会把这个口子拉得更大。
第一轮问这类合同常见的付款周期,第二轮问我们这份约定的账期算不算长,第三轮问按行业惯例要不要加违约条款。

单看每一轮都没有出现敏感词,三轮合起来却足以让对话的接收方或关联分析者还原出项目、对手和金额区间。
交出去多少信息?
看这一步要什么
法官在判决之后,还针对这类案例给了三条建议:细化涉密信息清单;明确禁止录入上传AI平台的核心数据与机密文件范围;制定AI工具使用管理办法,划定合规使用边界。
企业习惯先替数据定级,再决定要不要交出去。
这个顺序有一个前提并不成立:同一份数据,在不同任务里的必要程度不一样。
判断的依据应是任务。中枢词元NexToken平台在数据发送到大模型之前,用“规则检测+语义判别”两层能力识别敏感内容。
基础层用正则表达式与词典匹配,快速检出个人信息、账号密钥这类特征明确的字段。
语义层支持企业用自然语言定义保护规则,例如“禁止外发未公开的项目报价”、“识别包含客户商业秘密的内容”,由平台自训练的语义判别模型结合上下文识别风险。
两层配合,按策略执行脱敏、拦截或放行。
一句请求拆成五步,
每一步交出去的信息都不同
在NexToken的机制里,这句请求会被拆成五件事,一件一件处理。
这一步只需要会议主题、材料格式要求等与个人隐私无关的信息;本地个人信息不会上传,云端大模型看到的只有会议主题和材料格式要求。
这一步要看两样东西:你在本地日历上那一周的安排,和公司的差旅制度,如舱位要求、住宿标准。这两样都不必发出去,本地就能判断出结果。云端大模型看到的只有一个结论,行或者不行。
03 出方案
本地参与/原始数据不出端
行程方案怎么写、报销单要填哪些项、申请流程分几步,这是通用的方法,跟你的具体数据无关。云端大模型看到的只有方案撰写指导,真实的日历、制度原文和具体数值,由本地按模板填入。
04 推荐航班和酒店
最小语义/保留任务必要语义
这一步要用到你的历史偏好,个人信息只在本地归纳成要求,云端大模型看到的只有一句“避开红眼、安静房”。
05 实名出票与报销
精确字段/指定工具定向提交
这一步绕不开真实身份:姓名、身份证号、银行账号、开票信息。这些字段全程只在本地处理,仅定向提交到指定的出票与报销系统,不进入通用云端大模型。
一个请求拆分成五个子任务,每个子任务独立判定隐私数据如何参与。每一步交出去多少信息,只看这一步需要什么。
五步背后,
是NexToken的四层能力

四层的编排顺序是:需求判定、载荷保护、端云协同编排、生命周期治理。
同一个请求可以同时经过多层能力,最终只暴露完成当前子任务所需的最小信息。
披露状态靠多个技术层的组合实现。信息越必要,保护重点越从“删除”转向“受控参与”。
从企业查得清,
到企业敢放开用
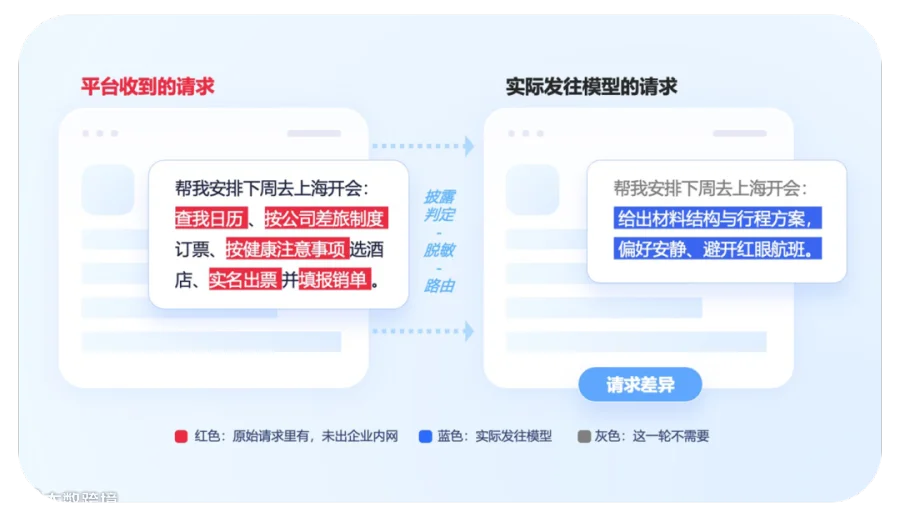
每一次请求都会留下记录。中枢词元NexToken平台用唯一任务标识把它们串成一条审计链:请求接入、隐私处理、模型调用、结果返回。
其中“请求差异”同时记录平台收到的原始请求与实际发往模型的请求,直观呈现两者的差异。
企业事后因此能说清,这一轮到底发出去了什么。
说得清,规则才立得住。
责任边界由规则明确,员工不必每一次都靠个人去猜该不该传、传多少。企业也不必再靠“一刀切禁止”来兜底。
规则立住了,业务就不必为安全让路。
同一份数据,在不同环节本来就有不同的处理方式;准备材料时个人敏感数据一个字都不出去,任务照样办得成。
企业败诉,输在拿不出证据。它缺的正是这份清单:哪些数据能交出去、交出去之前要处理到什么程度。
企业想用AI提效,这件事本没错。什么信息能出去、出去到什么程度,正需要企业来把关。
瑞莱智慧已将这份清单固化为中枢词元NexToken平台的默认机制:用最小披露,换最大效率。
END