

10 月 20 日晚上,Ornith 在 X 上放出 Ornith-1.5-122B,MIT 许可,权重直接挂在 Hugging Face。官方帖子到 21 日早上已有大约 41 万次展示、两千一百多个赞、近千次收藏,Ollama 当晚就上了 ollama run ornith-1.5:122b。
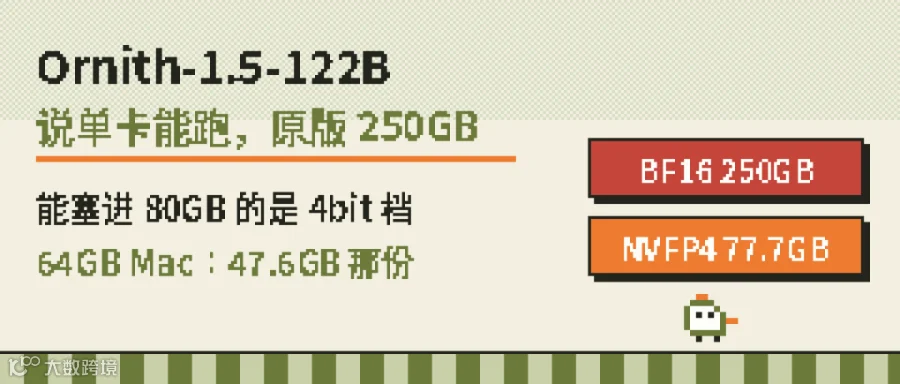
最抓人的是模型卡里那句话:这是一个 122B 的 MoE 模型,可以跑在单张 80GB GPU 上。可你点开 Files 一栏,原版权重显示的是 250 GB。
两句话都没错,只是说的不是同一份文件。我的结论先放这:能塞进一张 80GB 卡的是官方 4bit 那一档,余量很紧;手上是 64GB Mac 的人有一份 47.6GB 的社区量化可以试;至于模型卡上的分数,目前全是自报,第三方复测还没出来,别急着当结论用。
01
PART
它是什么
WHAT IT IS
Ornith-1.5 这个系列 8 月就发过 9B、35B、397B 三档,122B 是 10 月 20 日补上的中间档(Ollama 页面的更新记录写得很清楚)。它是推理模型,默认先在
几个硬参数:上下文 262,144 token,用 YaRN 系数 4.0 可以拉到大约 100 万,但模型卡自己也提醒,开源推理框架的 YaRN 是静态缩放,短输入的质量可能会略掉,用不到长窗就别开。config.json 里的架构名是 Qwen3_5MoeForConditionalGeneration,也就是 Qwen3.5 的 MoE 结构;Ornith 8 月的博客写过,1.0 代是在 Qwen3.5 和 Gemma 4 上继续训练出来的。
跑分是官方模型卡自报:SWE-bench Verified 84.5、SWE-bench Pro 76.9、Terminal-Bench 2.1 81.2、CyberGym 80.0、BrowseComp 78.5、MCP-Atlas 74.6。官方的说法是同尺寸开源模型里最好。
模型卡开头还有一句宣传:任务完成得更快、输出更短。这句没有配数字,但对推理模型很要紧——思考过程也算 token,输出越短,等待时间和电费就越省。这一项值得你自己记一下:同一个任务,它和你现在用的模型各吐了多少 token。
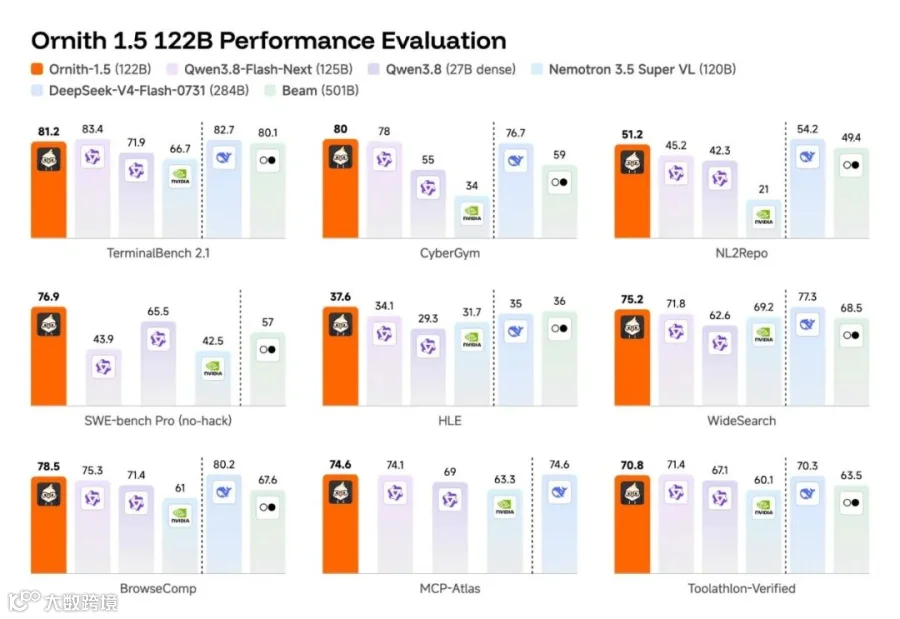
这张图要会看。对照组里有 125B 的 Qwen3.8-Flash-Next、284B 的 DeepSeek-V4-Flash-0731、501B 的 Beam。Ornith 在 SWE-bench Pro 上拉开得最多(76.9 对 Qwen3.8-Flash-Next 的 43.9),但 Terminal-Bench 2.1 上 Qwen3.8-Flash-Next 是 83.4、DeepSeek 是 82.7,都比它高;NL2Repo 和 BrowseComp 上 DeepSeek 也更高。所以「同尺寸最好」成立的前提是拿 120B 级别比,它并没有在每一项都赢。
02
PART
能不能本地跑:先看文件大小
WILL IT FIT
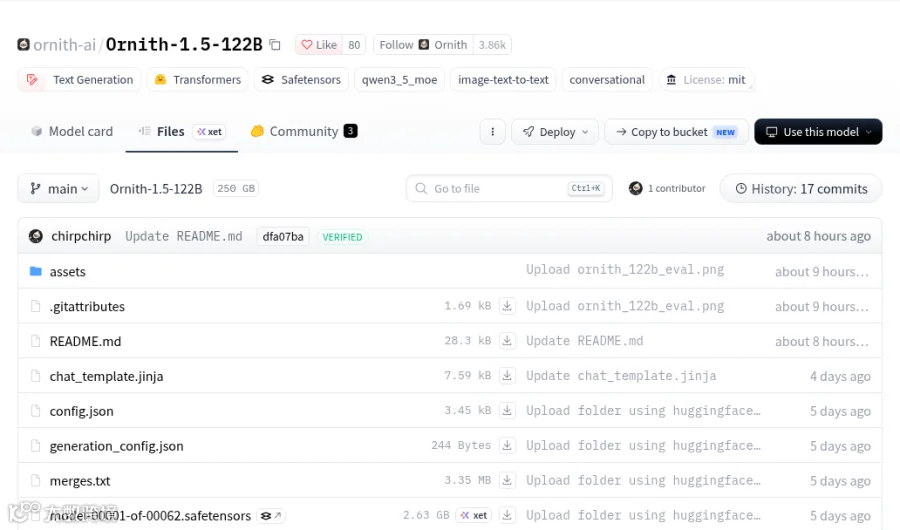
单张 80GB 这个说法,对得上的是官方自己出的 NVFP4 版。我把官方和几个社区仓库的文件大小拉了一遍(Hugging Face 文件列表,10 月 21 日早上的数字):
看完这张表,「单卡」的真实意思就清楚了:80GB 的卡放 77.7GB 的 NVFP4,只剩 2GB 出头给 KV 缓存和运行时开销。权重能装下,但 262K 长上下文基本别想跑满,实际能开多长要你自己压测。Ollama 页面上 122b 标的是 73GB–77GB,也是 4bit 这一档。
这里顺带说一个常被忽略的点:文件大小只是权重本身。模型跑起来,还要为对话上下文留一块缓存,上下文越长占得越多,再加上推理框架自己的开销。所以挑版本时别按「内存刚好等于文件大小」来算,至少留出一成以上的余量,长上下文任务留得更多。
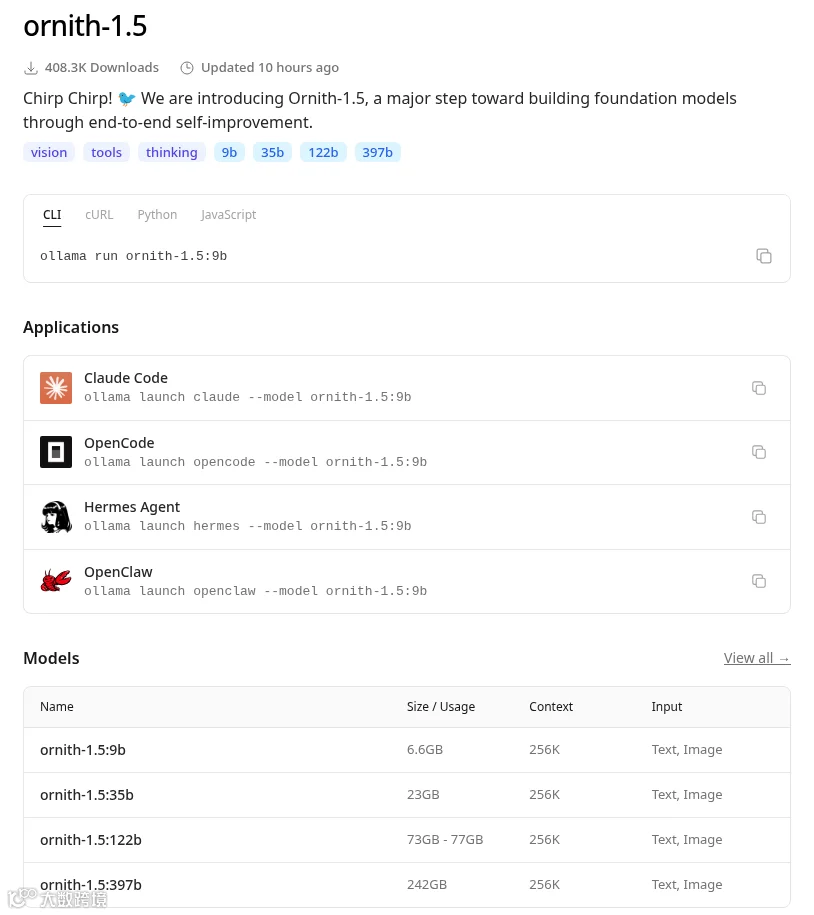

没有 80GB 卡的人,路在社区量化。Ornith 官方发帖点名感谢了 Atomic Chat 的一组量化,从 132.6GB 一路压到 35.0GB。Atomic Chat 自己的帖子里给 64GB Mac 推荐的是 47.6GB 的 AD-IQ3_XXS-IQ2_S,并写了一个数:和 BF16 原版相比,首选 token 一致率 86.0%。换个说法,大约每 7 个 token 里有 1 个和原版的第一选择不同。写代码时这点偏差会不会变成 bug,只能拿你自己的任务去试。
Atomic Chat 在仓库说明里把每一档都测了一遍,这张表比任何宣传都有用:132.6GB 的 Q8_0 一致率 96.28%,78.5GB 那档 94.19%,47.6GB 是 86.05%,最小的 35.0GB 只剩 77.18%。他们自己把 35GB 那份标成「研究用文件」,意思是能跑起来,但每 4 到 5 个 token 就有 1 个和原版选得不一样,建议至少用 39.2GB 那档。128GB 的 Mac,他们给的实际上限是 AD-Q6_K(97 GiB)。
截至 21 日早上,Hugging Face 上名字带 Ornith-1.5-122B 的仓库已经有 36 个,其中官方 7 个,其余是社区做的 GGUF、MLX、EXL3、投机解码加速版。量化的选择不缺,缺的是每一档掉多少点的公开对比。

03
PART
四条上手路径
HOW TO TRY
最省事:Ollama。装好 Ollama 之后一行命令,拉下来的是 73–77GB 那档,机器内存要明显大于 77GB 才从容,比如 128GB 统一内存的机器;80GB 卡能装下但很紧。
64GB Mac:llama.cpp 加社区 GGUF。只下 47.6GB 那一个文件,不要把整个仓库拉下来(Atomic Chat 的仓库全部加起来有好几百 GB)。
有服务器:vLLM / SGLang。模型卡给了现成配方,对运行时版本有硬要求:Transformers ≥ 5.8.1、vLLM ≥ 0.19.1、SGLang ≥ 0.5.9,老版本直接起不来。原版 250GB 需要多卡,加 --tensor-parallel-size 切分。
单台 DGX Spark 或 RTX PRO 6000:社区作者 @MiaAI_lab 发布当天放出了 EXL3 4bpw 量化,明确写给这两种机器用,并预告了一份基于 TensorFold 的部署配方。
命令摘自官方模型卡与 Ollama 页面
# A. Ollama(4bit 档,73–77GB)
ollama run ornith-1.5:122b
# B. 只下 64GB Mac 那一个文件
hf download AtomicChat/Ornith-1.5-122B-GGUF --include "Ornith-1.5-122B-AD-IQ3_XXS-IQ2_S.gguf" --local-dir ./ornith
# C. vLLM(官方配方,OpenAI 兼容接口)
vllm serve ornith-ai/Ornith-1.5-122B --served-model-name Ornith-1.5-122B --max-model-len 262144 --enable-auto-tool-choice --tool-call-parser qwen3_xml --reasoning-parser qwen3 --trust-remote-code
# 写代码推荐采样:temperature=0.6 top_p=0.95 top_k=20
04
PART
真人怎么说,冷水在哪
COLD WATER
最早的上手反馈来自提前拿到测试资格的 X 用户 @PaulGugAI。对方在发布前一天跑了自己的 Nerfwatch Index,20 题全对,但本人写得很克制:这套题只有 20 道,是用来盯模型有没有退化的,不是排名用的。另一位用户 @cornokun 在 Mac 上试完的评价是「在 Mac 上居然不拉胯,目前挺满意」。有 4 万多粉丝的 @MiaAI_lab 说表现让自己很意外,但那份 100 个 HTML 页面的对比实验还没发出来。
这些都是好兆头,也只是兆头。下面几盆冷水,下载之前值得过一遍:
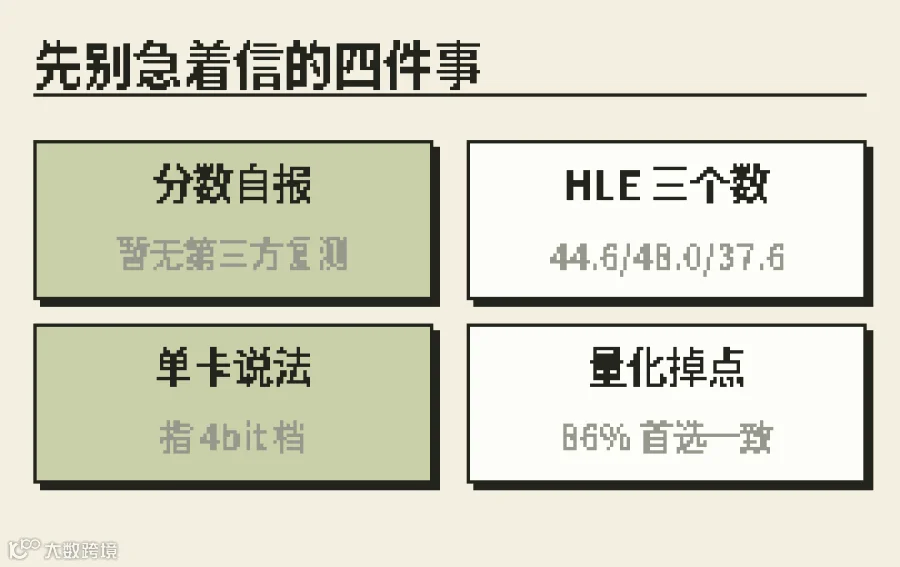
第一,分数全是自报。模型卡上的成绩都是 Ornith 自己用自己的设置跑的,比如 SWE-bench 用 OpenHands 框架、温度 1.0、256K 窗口。到 21 日早上,我还没看到第三方榜单给出 122B 的独立成绩。
第二,同一项 HLE,官方给了三个数。X 发布帖写 0.446,模型卡表格里带工具是 48.0、不带工具是 37.68,跑分图上标的是 37.6。可能只是口径不同,但官方没有说明。引用的时候请写清楚是哪一个。
第三,「单卡」指的是 4bit。官方在「单张 80GB GPU」和「单张 DGX」两种说法之间混用。按文件算,原版 250GB 至少要四张 80GB 卡,FP8 要两张,只有 NVFP4 和 Q4 塞得进一张。
第四,越小的量化越要自己测。上面那组一致率是量化作者自己测的,衡量的是「和原版选词像不像」,不等于你的任务能不能做对;官方的 NVFP4 和 MLX 版没有公开类似数字。编码代理一步错,后面几十步都会跟着错,量化越狠,越要拿真实任务回归。
第五,口碑样本还很少。X 账号 @notanotherbench 引用的一个众评榜单里,Ornith-1.5 的 35B 兄弟排在 327 个模型里的第 166 位,1,159 人打分平均 6.4;122B 还没上榜。小兄弟的口碑不代表大的,但至少说明这个系列还没被大量用户验证过。
05
PART
谁该现在试,谁可以等
WHO SHOULD TRY
现在就值得试的:代码和数据不能出内网的团队,MIT 许可加本地部署,合规上最省心;手上已经有 64GB 以上 Mac、想把编码代理搬到本机的个人开发者;已经有 80GB 卡、在找一个比 30B 级更强的本地编码模型的人。
可以先等等的:只有 24GB 或 32GB 显卡的人,最小的 35GB 量化也装不下,同系列的 35B 在 Ollama 上是 23GB,更现实;主要靠云端 API、也不在乎数据出不出网的人,没必要为了一张自报跑分图折腾几十 GB 下载,等第三方复测出来再说不迟。
说说我的态度。Ornith-1.5-122B 值得试,是因为它把本地编码代理的门槛往下拉了一档:MIT 许可没有商用顾虑,Ollama 第一天就能跑,社区量化一夜之间铺满了各种内存档位。但「单卡能跑」这四个字,在 250GB 的原版和 77.7GB 的 4bit 之间省掉了很多细节;84.5 的 SWE-bench 也还只是厂商自己的数字。先用自己的 20 个真实任务跑一遍,比看任何一张跑分图都靠谱。
CHECKLIST
量内存 → 挑一档文件 → 只下单个文件 → 用 20 个真实任务回归 → 再决定是否换掉现在的 API
照着做:① 先看自己机器的显存或统一内存,80GB 卡选 NVFP4,128GB 统一内存的机器用 Ollama,64GB Mac 用 47.6GB 那份;② 用 hf download 加 --include 只下需要的文件;③ 升级 vLLM 到 0.19.1 以上、Transformers 到 5.8.1 以上再起服务;④ 写代码时把温度调到 0.6,通用任务用 1.0;⑤ 先开 32K 或 64K 上下文,稳了再往上加;⑥ 拿你自己的 20 个真实任务,和现在用的 API 模型并排跑,记下成功率、耗时和失败样例;⑦ 文中所有分数都是官方自报,第三方复测出来后再更新判断。
很多人卡在第 ⑥ 步:模型跑起来了,却不知道怎么把它变成一份能报价的交付,比如给团队搭一套不出内网的编码助手,过关标准怎么写、维护谁来做。
你手上的机器是多大内存?准备下哪一档,还是继续用 API?评论区聊聊。
出处:Hugging Face ornith-ai/Ornith-1.5-122B 模型卡与文件列表(10月21日查看)、Ornith 官方 X @ornith_(10月20日)、Ollama 模型页、Atomic Chat 官方 X、X 用户 @PaulGugAI @cornokun @MiaAI_lab @notanotherbench 公开帖。
往期 · 接着看
Reflection开源Beam:501B只激活23B,Apache 2.0可商用,第三方测出幻觉率47%
DeepSeek发Flash-1017:API名字没变,自报终端题42.3(旧31.2)
Blockway发Volundr 32B v1:SWE循环36/50变0,16GB自称开262K
「AI商业实战」新人邀请礼遇 ¥25,进圈可领两张短卡:「交付定义卡」把买家、交付文件、过关标准、改稿轮次一次写清;「一周试跑清单」按天跑通一个最小交付闭环。不保证接单,帮你少走弯路。
工具会用了,下一步是把它变成能交付的活。「AI商业实战」里有人在做本地模型部署和编码代理的实单,欢迎来交流。
点文末「阅读原文」开启 AI 实战交流
觉得有用的话,欢迎点赞、收藏、评论。
THANKS FOR READING