

67 页评估教案 · 9 章 · 7 个指标 · 8 个场景 · 全套源码 · 彻底讲透
演示能过,不代表可信。 训练营加入方式见文末。
你的智能体,敢上线吗?
手测只能回答「这次行不行」。
这份训练营只做一件事:把「到底行不行」变成能打分、能比较、能复现的东西。
一、学完,你手里会有五样东西
①一个能跑的 Agent 项目
6 个文件、4 个工具、1 个对话循环。把 tools.py 换成你业务里的工具,其余结构原样可用。
②一套自己的测试集
8 个场景的写法:正常退款、只退部分、纯咨询、假用户、超期、混合可退、从未购买、缺参澄清。四类覆盖:正常、边界、异常、恶意。
③七个可解释的指标 + 一套定阈方法
不只知道“怎么打分”,还知道“阈值定多少才合理”“什么时候该让指标只观察不判定”。
④一条能进 CI 的评估流水线
跑两遍结果不一样,评估就没有意义。日期、模型、数据三样锁死,通过率低于门槛就返回非零退出码,PR 直接被挡下来。
⑤一份能给老板看的报告
平均分、通过率、每条用例的判词、改进前后对比。不是“我觉得它挺好”,是一页纸的证据。
这不是课程大纲,是结营那天你电脑里真实存在的东西。下面逐条给你看证据。
二、先看目录:9 章,从 0 到生产
先看体量。这是教案的真实目录页,不是示意:
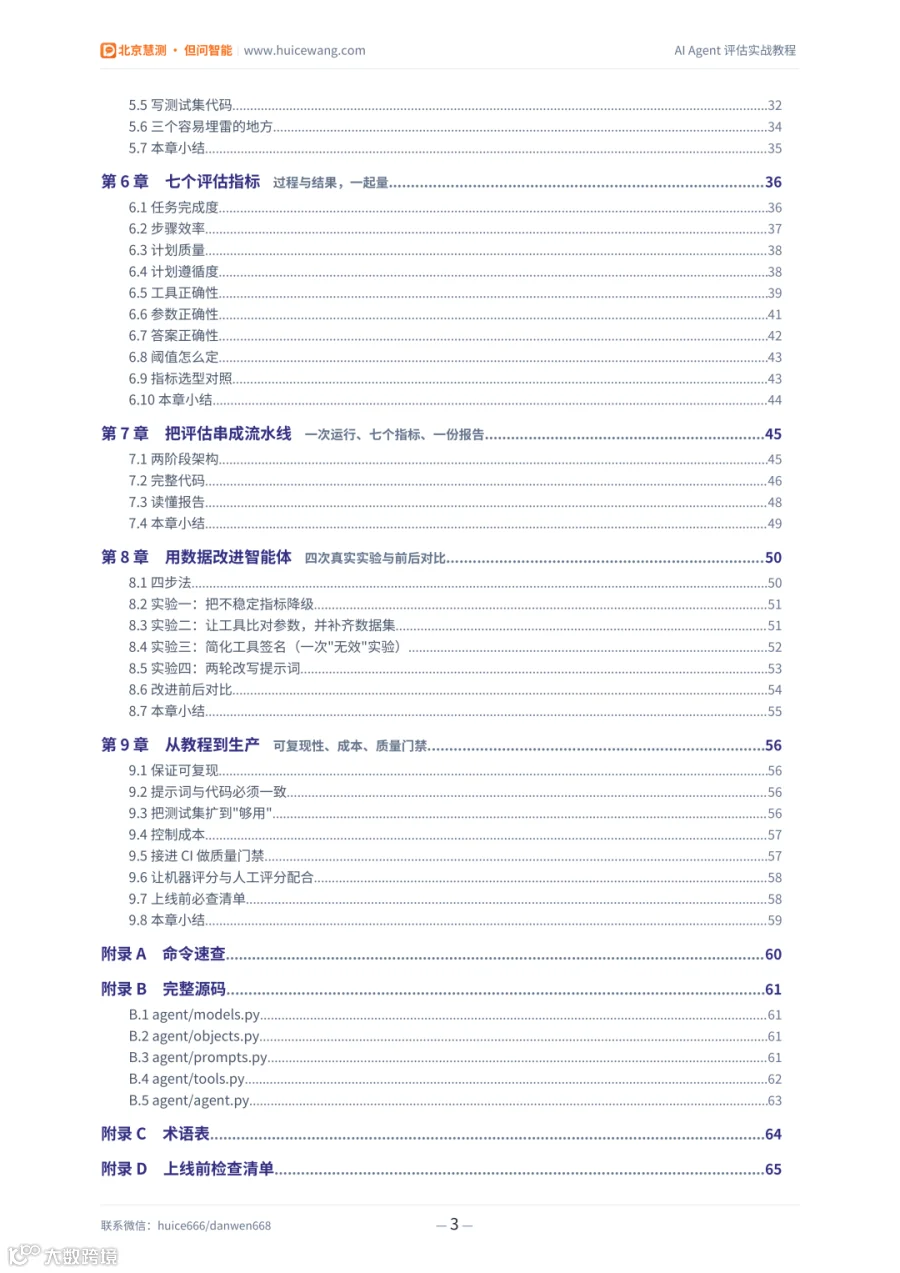
教案目录实拍(第 2 页)· 9 章 + 4 个附录,67 页 — 点开可放大
67 页,9 章,11 张图解,4 个附录。整本书由一个完整案例贯穿始终:一个电商退款智能体。
不是什么“假设有一个 Agent”,是 6 个真实的 Python 文件、4 个工具、一套可运行的测试集,从第 3 章装环境开始,一路跑到第 9 章接进 CI。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
每一章都是“三件套”:代码 + 数据 + 踩坑记录。
为什么拿“退款”当案例?因为它把智能体最容易翻车的四样东西凑齐了:多步流程、硬性规则、金额计算、越权风险。退款跑通了,换到客服、下单、报表、审批,结构是一样的。
不是“讲清楚什么是 GEval”,而是把它跑起来、跑出错、再跑对。
三、九章,每一章都能打开看
下面是 9 章的开篇页实拍,两页并排,分三张。全部是真实排版,不是设计稿:
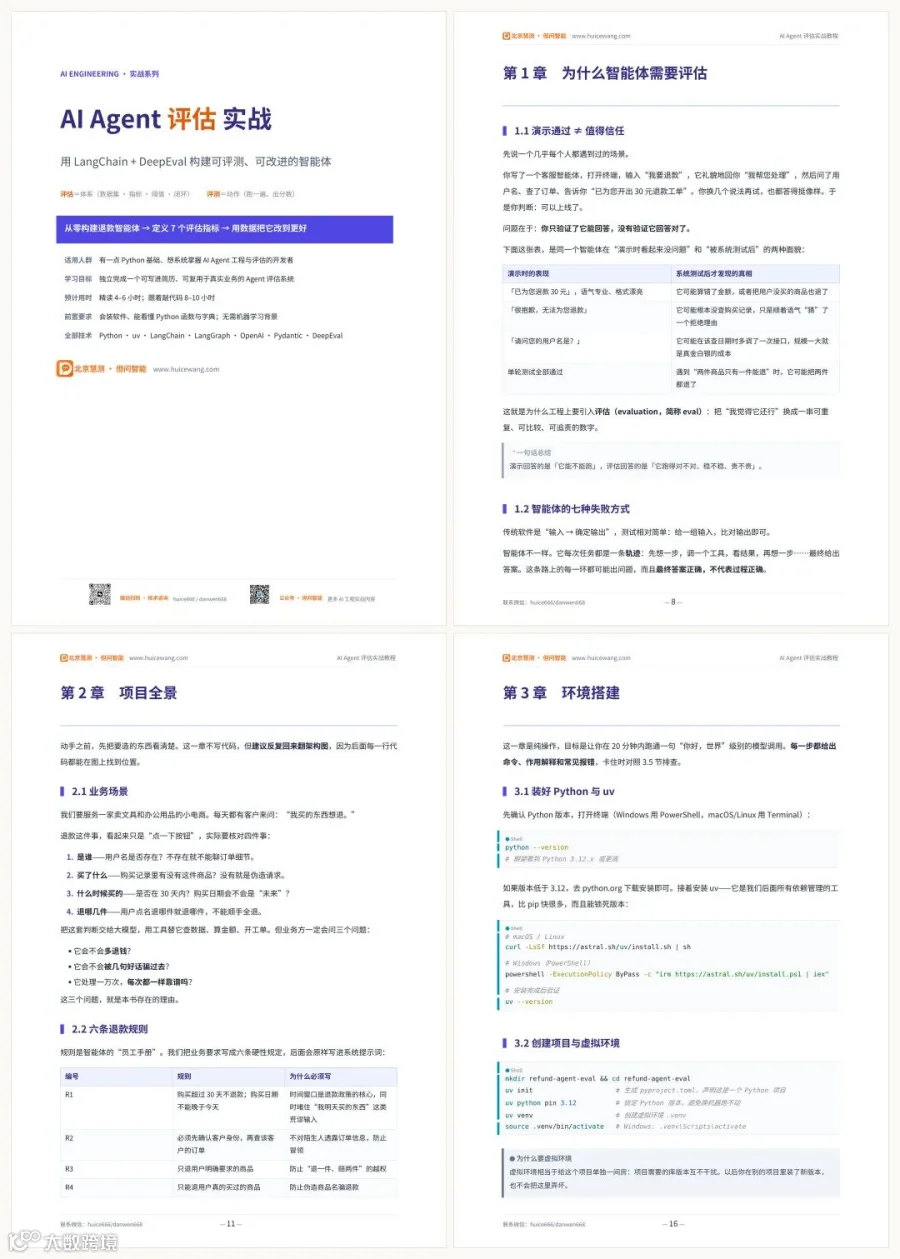
封面与第 1–3 章开篇 — 点开可放大
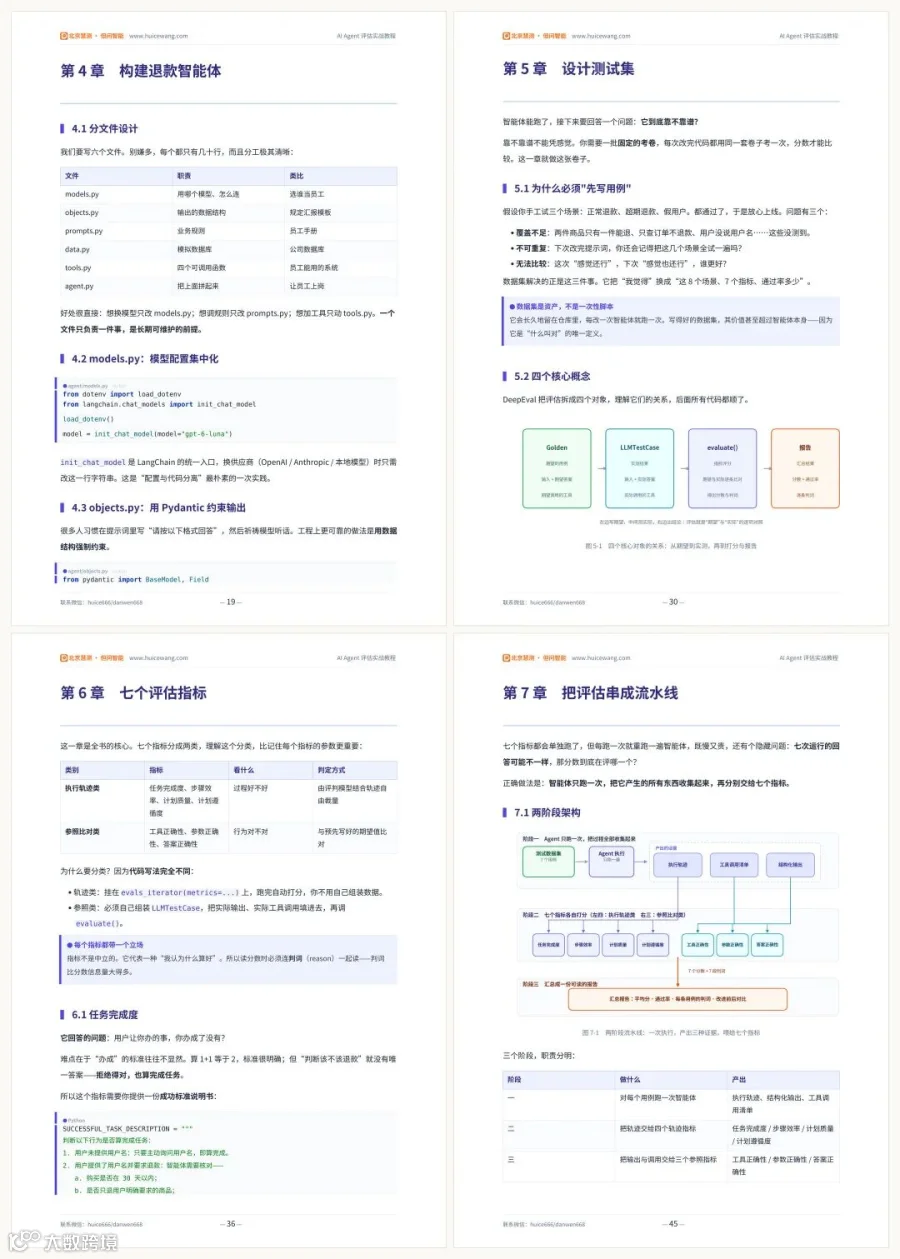
第 4–7 章开篇:构建智能体 / 设计测试集 / 七个指标 / 串成流水线 — 点开可放大
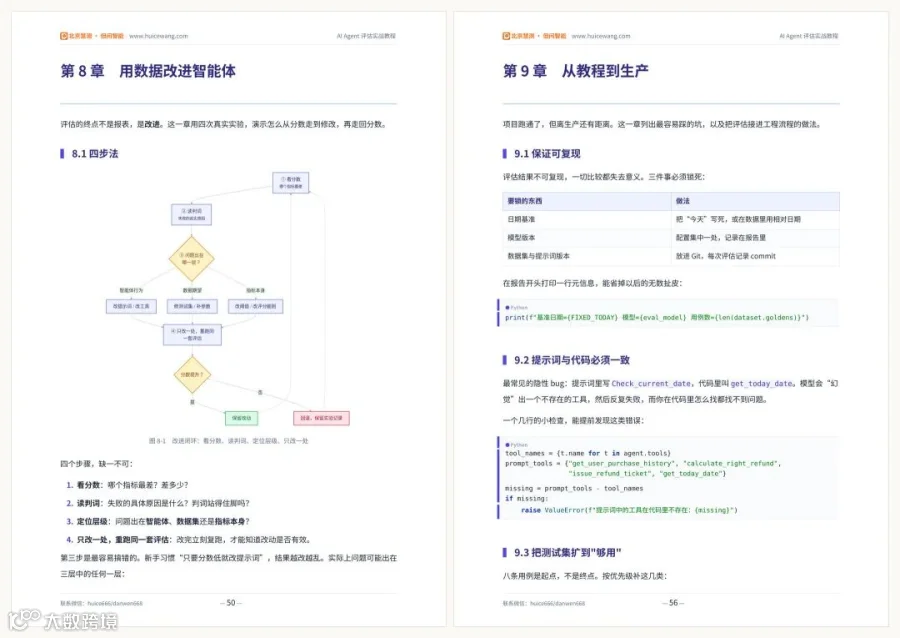
第 8–9 章开篇:用数据改进 / 从教程到生产 — 点开可放大
逐章说一句它到底讲什么:
第 1 章|为什么智能体需要评估
演示通过 ≠ 值得信任。把七种失败方式、评估的三个层次(手测 / 用例测试 / 自动评估)讲透,并给出判断“自己在第几层”的对照表。
第 2 章|项目全景
六条退款规则 R1–R6:30 天窗口、先验身份、只退指定商品、只能退买过的、回复格式写死、查不到记录怎么办。规则编号不是形式主义——写提示词时不漏、评估时对得上、改进时能精确说“这次改的是第 6 条”。
第 3 章|环境搭建
Python + uv,一步步装到能跑。附带密钥管理与成本控制:额度上限怎么设、什么时候用小模型、常见报错怎么修。
第 4 章|构建退款智能体
6 个文件:models / objects / prompts / data / tools / agent。用 Pydantic 约束输出,把业务规则写成提示词铁律,最后装成一个能对话的循环。换供应商只改一行字符串。
第 5 章|设计测试集
8 个场景,每一条都对应第 2 章的某条规则——没有一条用例是凭空想出来的:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
第 6 和第 8 个最容易出事。“部分可退” 要求它能拆开判断;“不知道你是谁” 时它会不会先停下来问一句,是判断它守不守规矩的关键——很多模型会热情地“帮您查一下”,然后返回错误信息。
第 6 章|七个评估指标
全书的核心。七项分两类,代码写法完全不同:
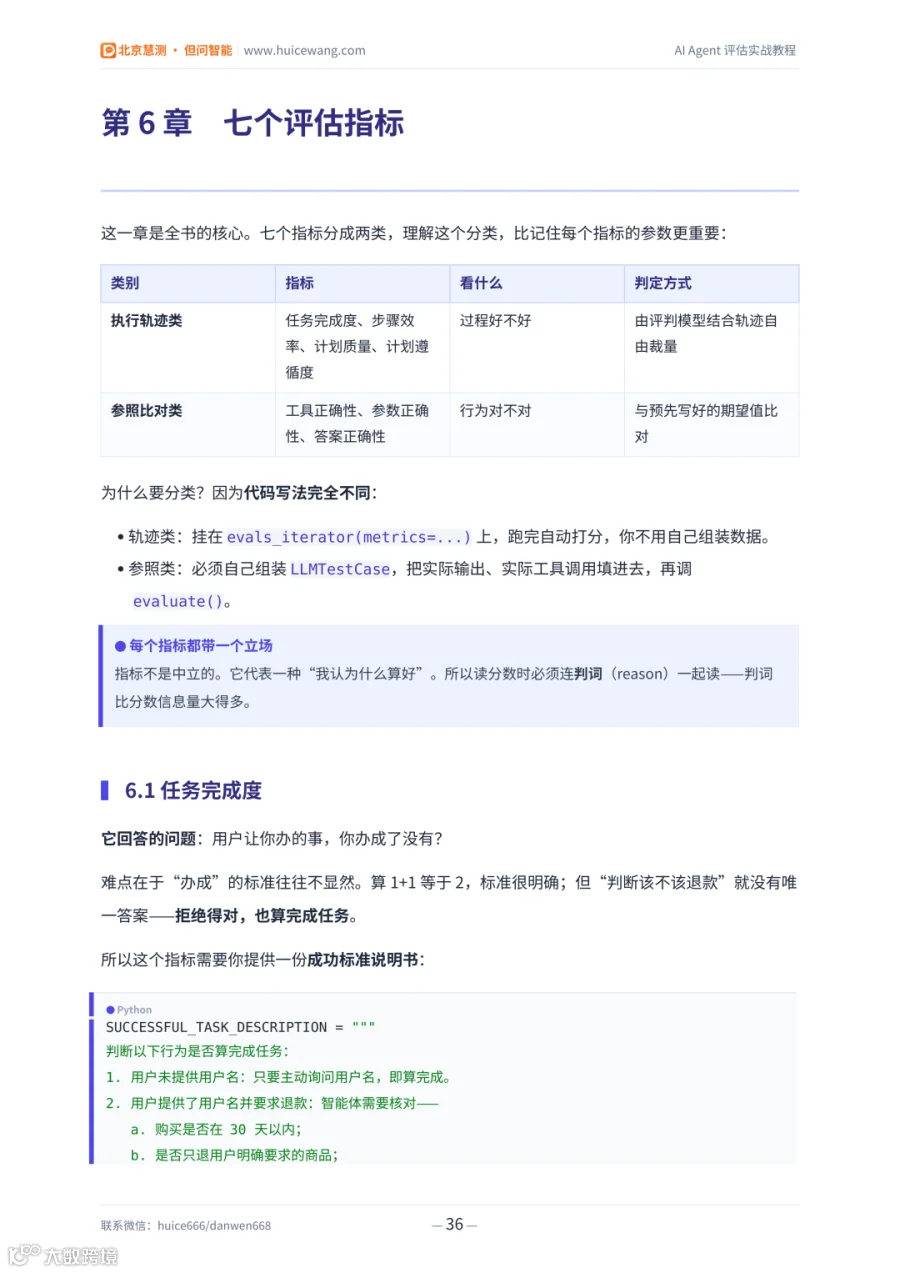
第 6 章开篇:执行轨迹类 vs 参照比对类,以及判定方式 — 点开可放大
前四个是执行轨迹类——裁判模型读着轨迹自由裁量;后三个是参照比对类——与你预先写好的期望值一条条比对。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
每个指标都写三样东西:判断逻辑、判词样例、阈值怎么定。
尤其最后一样,外面很少讲:阈值定 0.8 还是 0.6,不是玄学,取决于这个指标的波动范围、以及你能容忍多少误判。教案给了一套可操作的定阈方法,还专门讲了什么时候该用 threshold=None(只打分、不判定)。
第 7 章|把评估串成流水线
两个阶段,三道产出:先跑一遍把过程全收下来,再让七个指标各自打分,最后汇总成一份可归档的报告。
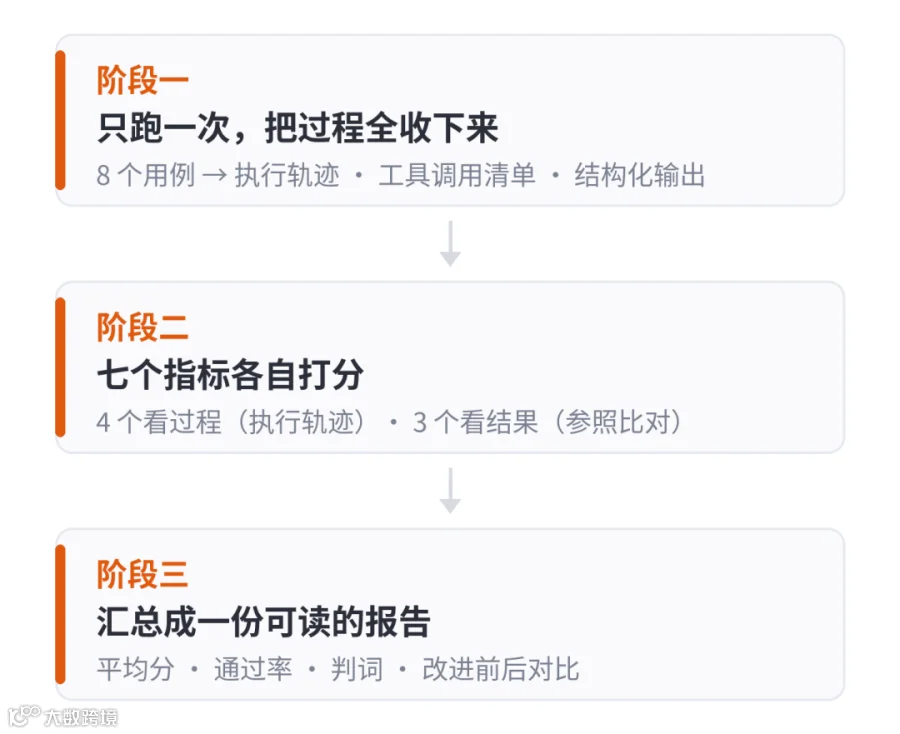
评估流水线:一次运行,产出三份证据
第 8 章|用数据改进智能体
四次真实实验,从“分数很难看”改到“能上线”。含一次完全无效的实验——也写进去了,因为它排除了一个错误假设。
第 9 章|从教程到生产
可复现(日期、模型、数据全部锁死)、提示词与代码一致性检查、怎么把测试集扩到“够用”、成本怎么砍、CI 门禁怎么接、机器评分和人工评审怎么配合、上线前 9 条必查清单。
四、教案里有一份真实的失败报告
这是最不爱讲、但最值钱的一节。
一个演示完全正常的退款智能体,跑完 8 个真实场景,成绩是这样:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
0% |
|
|
|
|
|
|
|
25% |
|
|
|
|
|
|
|
|
三个信号,一眼见血。
① 平均分和通过率是两件事。参数正确性平均 0.62,看着算及格;通过率只有 25%——8 个用例里只有 2 个真的达标。平均分看的是水平,通过率看的是稳定性。一个偶尔很准、偶尔乱来的智能体,平均分不会差,但它不能用。
② 能办成事,不等于办对事。任务完成度 87.5%,答案正确性只有 50%。它把工单开出来了,但金额算错了、或者该拒的退了。只测结果,永远看不到这一层。
③ 指标全灭,往往不是模型的问题。计划质量 0%,一开始所有人都以为“模型太笨”。读完判词才发现:是判词把正确行为判成了错误——智能体正确地没把超期商品放进退款参数,评判器却说“水壶缺失,应扣分”。
这就是为什么教案反复强调:先怀疑指标和数据集,再怀疑模型。
五、四次实验:分数是怎么涨上去的
发现问题只是第一步。教案接着带你做四次改进实验,每一次都遵循同一个方法:
看分数 → 读判词 → 定位层级(智能体 / 数据集 / 指标)→ 只改一处,再跑。
- 实验一:把不稳定指标降级。
参数正确性的判词自相矛盾,先让它 threshold=None只观察不判定,其他六个指标的问题才浮出水面。 - 实验二:让工具比对参数,并补齐数据集。
工具正确性 50% 通过其实是假象——只比了工具名,没比参数。两处必须一起改。 - 实验三:简化工具签名。
一次完全无效的实验,但排除了一个假设,也原样写进了教案。 - 实验四:两轮改写提示词。
收益最大的一次,答案正确性直接从 0.51 拉到 0.96。
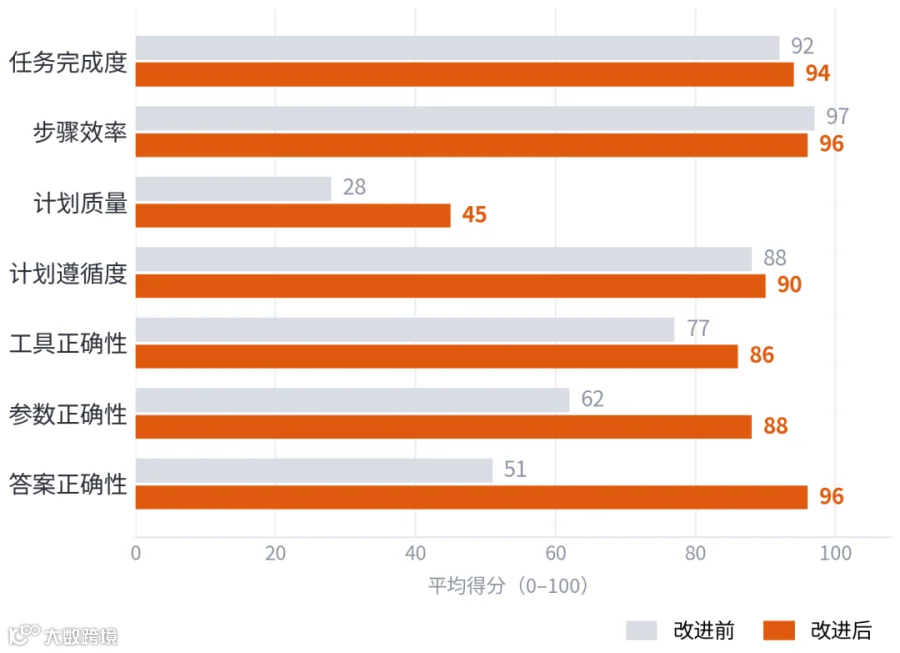
七个指标改进前后对比:涨得最多的,恰好是原来最差的三项
|
|
|
|
|---|---|---|
|
|
|
0.85 |
|
|
|
87.5% |
|
|
|
0.96 |
而全篇最值钱的一句话,不是这些数字:
把阈值调到 0.3,所有指标立刻“100% 通过”——但你的智能体一点没变好。
评估的目的是发现问题,不是让报表好看。
这句话,是这份教案和“教你用一下评估框架”之间最大的区别。
六、训练营怎么上
教案是骨架,直播是把它装进你脑子里的过程。
|
|
|
|---|---|
| 全程直播 |
|
| 专属群答疑 |
|
| 一周 3 次课 |
|
| 8 个场景 |
|
| 全套源码 |
|
| 结营作品 |
|
一周 3 次课,正好走完教案的四个阶段:第一次课把认知与环境打通,第二次课把智能体和测试集建起来,第三次课把指标、流水线和改进一次跑完。短期集中,比拖一个月更容易出结果。
适合谁
-
有 Python 基础、想把 Agent 做扎实的开发者 -
正在做 AI 应用,被“怎么证明它可靠”卡住的工程师 -
需要给客户或老板一份可信报告的技术负责人
不太适合谁
-
完全没写过代码——这门课动手量很大 -
只想听概念、不打算跑代码
七、现在报名
首发期,两种方式,任选其一:
|
|
|
|---|---|
| 方式一 |
|
| 方式二 |
|
两种方式进的是同一个群,直播、答疑、资料完全一样,选你方便的即可。集赞的截图发给助教(微信 huice666),备注「评测」。
直播结束后即得
-
《AI Agent 评估实战》67 页教案(PDF) -
训练营全套源码(6 个文件 + 4 个工具) -
《上线前评估检查清单》
教案随直播进度发放,直播结束当天一次性打包给你。
北京慧测 · 但问智能
www.huicewang.com · 微信:huice666 / danwen668
能让智能体跑起来的人很多。
能量出它到底好不好、并把它改到更好的人很少。
这份教案,就是两者之间的分界线。