输入一句提示词,等待片刻,一段包含人物动作、光影变化和镜头切换的视频便出现在屏幕上。视频生成模型带来的体验越来越丰富,支撑这些画面的计算量也在不断增长。
在这个过程中,Attention承担着关联不同位置内容的重要任务。随着视频序列变长,它需要处理更多数据,计算和数据搬运的压力也随之增加。如何让这部分计算更高效,同时保住生成质量,成为视频生成模型走向实际应用的一道关键问题。
4-bit为此提供了一条值得探索的路径。通过更低位宽的数据表示,MXFP4 能够减少存储和数据搬运的负担,并利用相应硬件执行低比特矩阵计算。但要把这份效率潜力转化为可用的生成能力,还需要跨过一道门槛:数据表示变得更精简,量化带来的误差该如何控制?
MXAttention正是围绕这一问题展开。它是一种面向 MXFP4 Attention、无需校准数据的后训练量化框架,从缩放因子的选择和 Softmax 的计算流程入手,让 4-bit Attention 在视频生成任务中实现接近FP16的生成质量。
理解它的思路,可以先从低比特计算中一把特殊的“标尺”说起。
MXFP4 将每32个元素分为一组,组内数据采用4-bit E2M1格式,并共享一个E8M0缩放因子。这个缩放因子就像一把公共标尺,决定整组数据如何映射到有限的表示范围内。为了适配高效的硬件计算,这把标尺只能按2的整数次幂调整。
这意味着,标尺的选择并不能随意精细调节。缩放因子较小时,小数值能够保留更多细节,但大数值可能超出表示范围,被截断到最大有限值;缩放因子较大时,大数值更容易容纳,小数值却可能因为分辨率不足而丢失信息。
同一组数据里的大值与小值,由此产生了不同的精度需求。共享缩放因子的选择,需要在大值截断和小值精度之间找到合适的平衡。
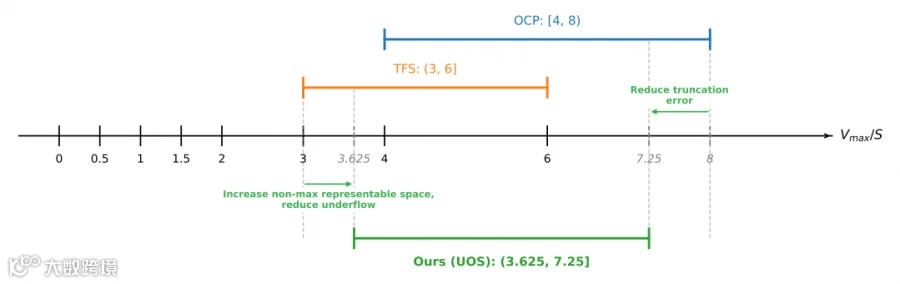
标准OCP缩放规则会将组内最大值映射到 [4, 8) 区间,而 E2M1 的最大有限值为 6。当缩放后的最大值超过 7 时,就近舍入会指向无法表示的数值 8,最终只能饱和到 6。采用更保守的缩放规则,可以减少这类问题,却又可能损失小数值的精度。
如何确定这个平衡点?如果针对不同模型、不同层逐一搜索,就需要引入额外的数据和调试过程。MXAttention 为此引入了 UOS(Universal Optimal Scaling,通用最优缩放),从量化格式本身寻找答案。
UOS 将不同绝对尺度下的量化误差放到统一的分析框架中,利用 2 的整数次幂缩放在对数域中的周期结构,推导出缩放边界:
Qmax = 7.25
在所定义的尺度归一化全局误差目标下,这一最优边界不随数据分布改变,因此无需为不同模型准备校准数据,也无需逐层搜索。
这里的7.25是选择共享缩放因子的边界,E2M1 的最大有限值仍然是6。与更保守的Qmax = 6相比,它为小数值保留了更高的量化分辨率;与标准OCP规则相比,它又收窄了最大值因舍入到不可表示数值8而发生饱和的范围。落实到计算中,UOS只需调整共享缩放因子的选择规则。
选好了标尺,Attention 的精度问题还没有全部解决。另一处容易被忽略的误差,藏在 Softmax 的归一化过程中。
Softmax 会把一组数转换为权重,用来决定不同位置的信息应当占多大比重。它有一个基本要求:每一行权重的总和应为 1。直观地说,将一组非负数分别除以它们的总和,就能得到满足这一要求的权重。
但量化可能打破这个关系。如果用于计算输出的数据已经经过量化,归一化所用的总和却仍由量化前的数据计算,就相当于分子发生了变化,分母还沿用旧值。两条计算路径使用的数据不一致,最终的权重之和便可能偏离 1,进一步影响 Attention 输出。
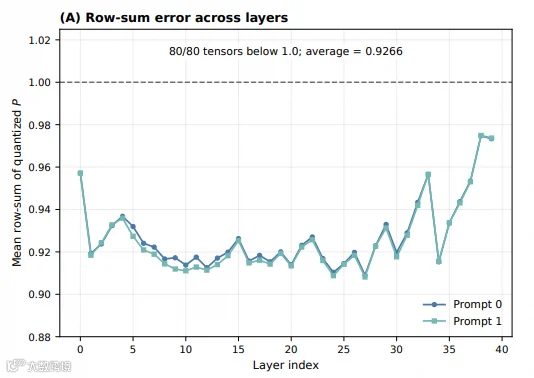
在分块执行、持续更新中间状态的在线 Softmax 中,这种一致性尤其需要关注。仅仅降低矩阵乘法输入的数据位宽,并不能自动保证整个计算流程仍然协调。
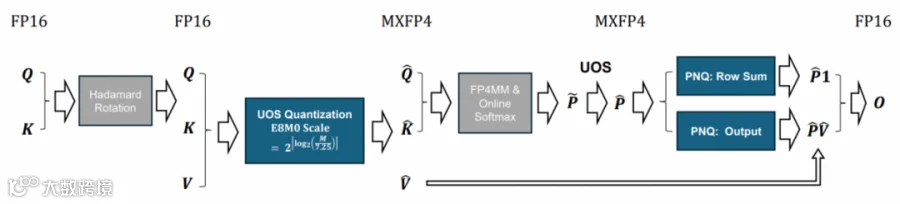
MXAttention的第二个设计PNQ(Pre-Normalization Quantization,归一化前量化),便是从这里入手:先对尚未归一化的指数结果进行MXFP4量化,再使用同一份量化结果,同时计算归一化因子和更新Attention输出。
这样,分子与分母就有了共同的数据基础。PNQ保持了量化后的归一化一致性,避免两条路径混用不同数值表示所引入的偏差。
至此,MXAttention 的两条核心思路便串联起来:UOS负责选好共享的“标尺”,PNQ负责让归一化计算前后一致。完整方案还对 Q/K 引入 Hadamard 旋转,缓解异常值对量化的影响。三者分别处理不同的误差来源,共同改善低比特 Attention 的精度。
这些设计最终能否体现在生成质量上,还需要由模型实验来回答。
在 Wan2.2 和 HunyuanVideo 视频生成模型上,MXAttention 在 4-bit Attention 设置下均取得了接近 FP16 Attention 的生成质量。其中,Wan2.2 在 VBench 等视频生成质量指标上保持了接近 FP16 的表现,实验中关键质量指标的损失控制在 0.01 以内;在 HunyuanVideo 上,MXAttention 同样有效减少了 Attention 量化带来的质量下降。
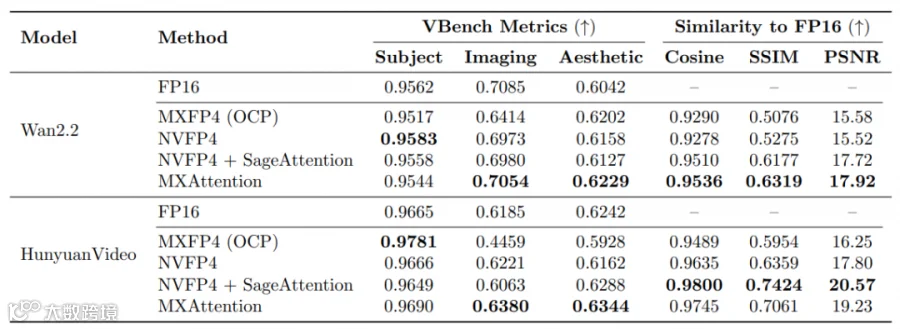
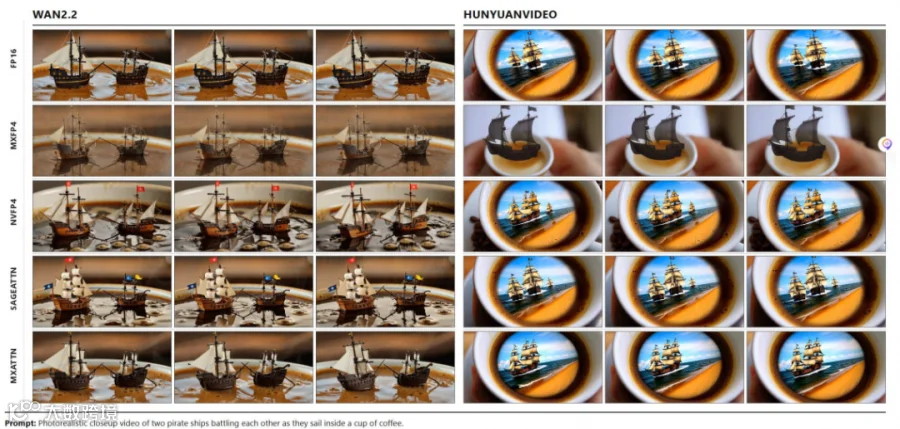
这些结果说明,Attention 的低比特化既需要合适的数据格式,也需要与之匹配的计算方法。共享缩放因子如何选择、量化后如何保持归一化一致,看似是计算流程中的局部问题,却会共同影响最终的生成质量。
从一把共享“标尺”的选择,到分子与分母使用同一份数据,MXAttention 将精度优化落实到了具体的计算环节,为高质量视频生成采用 MXFP4 Attention 提供了一条可行路径。
这条路径也有了面向开发者的实践入口。MXAttention的实现已集成至MindIE SD并开源。MindIE SD(Mind Inference Engine Stable Diffusion)是 MindIE 的视图生成推理模型套件,目标是为稳定扩散系列大模型提供在昇腾硬件及其软件栈上的端到端推理解决方案。
低比特Attention的效率收益,需要数据格式、算子实现与硬件能力三者协同才能真正兑现。MXFP4的E2M1数据格式与E8M0共享缩放因子,对矩阵计算的位宽支持提出了新的要求:MXAttention回答的是“如何量化才能保住生成质量”,而量化后的计算能否在昇腾上高效执行,则取决于算子实现与硬件特性的贴合程度。围绕这一点,MindIE SD已将MXFP4量化Attention 沉淀为可直接调用的算子能力,并配套提供与之匹配的Softmax 布局与模型侧接入配置,使4-bit Attention能够作为模块嵌入现有视频生成推理流程,而不需要改动模型主体结构。
开发者可以通过项目仓库查看实现与使用文档,结合自身模型和运行环境开展验证与适配,进一步探索低比特 Attention 在实际业务中的应用。
从方法设计到在昇腾上的开源实现,MXAttention 希望回答的始终是同一个问题:如何在降低计算与数据搬运成本的同时,尽可能保留视频生成的质量。也欢迎更多开发者参与交流与实践,让这一探索走向更丰富的应用场景。
https://gitcode.com/Ascend/MindIE-SD
MXAttention: Data-Free Optimal Scaling and Pre-Normalization Quantization for MXFP4 Attention
https://arxiv.org/abs/2607.24377