


10 个关键问题 Q&A
-
Q:DeepInfer 是什么? A:DeepSeek 开源、支撑自家线上服务的高性能大模型推理引擎,本次开源版本提供离线推理能力。 -
Q:它是从零开发的吗? A:不是,基于 vLLM 深度二次开发,借鉴了 SGLang、TensorRT-LLM 的设计思路。 -
Q:现在能跑哪些大模型? A:官方当前仅原生支持 DeepSeek-V4.1-Flash,暂不通用适配 Llama、Qwen 等其他模型。 -
Q:支持哪些算力硬件? A:英伟达 SM100 GPU、华为昇腾 950 NPU 两套硬件。 -
Q:EPLB 专家负载均衡解决什么痛点? A:解决 MoE 模型推理时专家流量倾斜,部分卡空闲、部分卡过载的负载不均问题。 -
Q:SWA 前缀缓存有什么用? A:复用重复上下文前缀,Agent 多轮对话、固定系统提示词场景可以显著降低首 token 延迟。 -
Q:什么是批量无关推理? A:同一个 prompt,不管单独推理还是混入大批次,生成结果完全一致,保障可复现性。 -
Q:DSpark 投机解码和普通投机解码差别在哪? A:采用置信度动态调度校验,不是固定策略,更适配 Agent 复杂推理场景。 -
Q:拿到开源代码就能直接上线对外服务吗? A:不能,缺少 KV 缓存集群、Prefill/Decode 分离网关、分布式负载均衡等线上服务组件。 -
Q:这个项目的协议和商用权限? A:Apache 2.0 许可证,允许商用、二次修改。
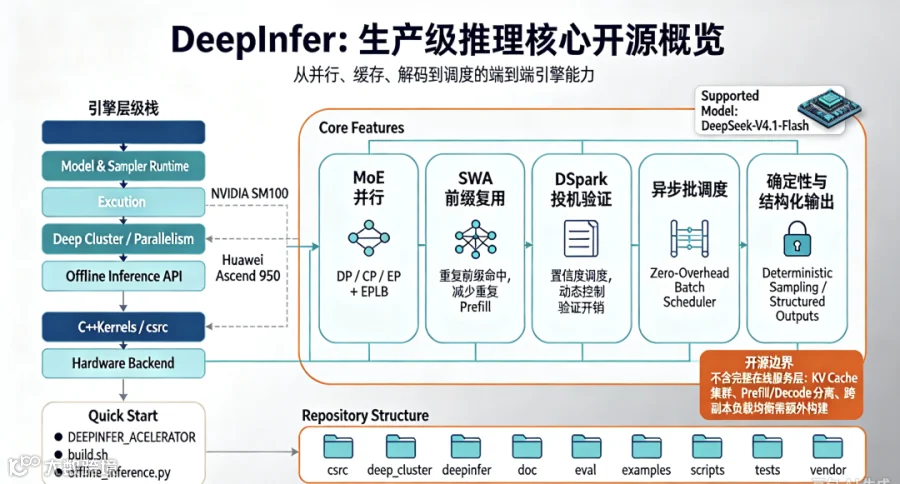
DeepInfer 是 DeepSeek 内部生产级推理引擎,现已开源(Apache 2.0),支撑 DeepSeek 线上大规模服务;本次开源版本放出离线推理核心能力,面向 DeepSeek-V4.1-Flash,原生支持 NVIDIA SM100、华为昇腾 950,是面向 MoE 大模型、长上下文 Agent 流量优化的专用推理栈。
一句话定位:基于 vLLM 二次深度改造,叠加 DeepSeek 自研 MoE 并行、缓存、投机解码、调度能力的生产推理框架。
一、仓库目录结构释义
csrc/                # C/C++ 核心算子、底层 runtime、硬件绑定内核
deep_cluster/        # 集群分布式、并行通信、MoE EP/EPLB 负载均衡相关
deepinfer/           # Python 主引擎:模型 runtime、采样器、调度器、缓存管理
doc/                 # 文档、性能图(prefill / decode pareto 曲线图)
eval/                # 评测脚本、基准评测套件
examples/            # 示例,重点是 offline_inference.py、sweep 压测脚本
scripts/             # 构建、环境、启动脚本
tests/               # 单元测试
vendor/              # 依赖子模块(DeepEP、TileLang 等自研算子库)
根目录文件要点:
build.sh一键编译入口,通过环境变量 DEEPINFER_ACCELERATOR切换nvidia / ascendpyproject.toml / setup.pyPython 包安装 requirements-*.txt分硬件依赖(nvidia /ascend/dev) .gitmodules拉取 vendor 里 DeepSeek 自研算子子模块(DeepEP、TileKernels)
二、能力清单(官方 Feature)
- Optimized kernels, model and sampler runtime
定制融合算子、模型执行 runtime、确定性采样器;支持 deterministic sampling(确定性采样)、structured outputs(结构化输出,JSON / 正则约束生成) - 并行策略(专为 MoE 设计)
-
Attention DP:注意力数据并行 -
balanced CP:均衡上下文并行(长上下文切分) -
MoE EP + EPLB:专家并行 + 专家负载均衡(EPLB,解决 MoE 专家负载倾斜,DeepEP 通信库底层支撑)GitHub - DSpark + confidence-scheduled verification
DeepSeek 自研投机解码:带置信度调度校验的推测解码,不是固定 n-gram / 小模型草稿,根据置信度动态控制校验开销,Agent 场景收益明显 - SWA bounded replay
核心缓存优化:前缀缓存复用,当上下文前缀命中时,跳过重复 prefill 计算;Agent 多轮工具调用、固定 system prompt 场景命中率极高,大幅压低 TTFT - Asynchronous scheduling(zero-overhead batch scheduler)
零开销异步批调度,区别于传统 continuous batching;batch-invariant inference:推理行为不受批大小影响,保证确定性 - Batch-invariant inference
同一 prompt,不管是单独跑还是混在大 batch 里跑,输出 token 序列完全一致;对生产复现、评测、Agent 稳定性非常关键
⚠️ 重要边界:开源包不包含完整线上服务组件(README 明确标注) 缺失模块:独立 KV Cache 集群系统、Prefill/Decode 分离部署(VE disaggregation)、跨 DP 副本负载均衡;这些是 DeepSeek 线上服务层,需要用户自己搭建。引擎内核已经支持 disagg 底层能力。
三、硬件 & 环境约束(硬性)
-
OS:Linux -
GCC ≥13.0 -
Python:3.12(严格锁定) -
NVIDIA:CUDA 13,SM100 GPU -
Ascend:CANN 9.2,Ascend 950 NPU -
模型:当前仅原生支持 DeepSeek-V4.1-Flash(1017 checkpoint)
四、编译 & 运行流程
-
创建干净 Python3.12 虚拟环境 -
导出加速器环境变量,执行编译脚本
# NVIDIA
export DEEPINFER_ACCELERATOR=nvidia
./build.sh

# 昇腾
export DEEPINFER_ACCELERATOR=ascend
./build.sh
-
离线推理
# 自动从 HF 拉取模型到缓存
python examples/offline_inference.py

# 指定本地模型目录,避免重复下载
export DEEPINFER_HF_MODEL_DIR=/path/to/DeepSeek-V4.1-Flash-1017
python examples/offline_inference.py
-
复现性能基准: examples/sweep/run_sweep.sh
Benchmark 测试规模:
-
Prefill:4 张 SM100 -
Decode:64 张 SM100 产出两张帕累托图:吞吐 vs 延迟曲线
五、技术溯源 & 定位对比
Acknowledgments:基于 vLLM 开发,吸收 SGLang、TensorRT-LLM 思路
-
vLLM:底座,继承 PagedAttention、批调度思想,但重度改写调度、并行、MoE、缓存逻辑 -
SGLang:参考前缀缓存、结构化输出思路;DeepInfer 的 SWA Bounded Replay 是同类方向的自研实现 -
TensorRT-LLM:参考极致算子编译优化思路;但 DeepInfer 保留 Python 控制层,面向服务调度而不是纯静态编译
和通用推理引擎最大差异: ✅ MoE-first:EP+EPLB 是一等公民,原生适配 DeepSeek V4.1-Flash 稀疏专家模型 ✅ 面向 Agent 长会话流量:SWA 前缀复用 + DSpark 投机解码,是 Agent 场景优化组合 ✅ Batch invariant + deterministic sampling:优先保证可复现,很多开源引擎不保证 ✅ 双硬件原生同仓支持:NVIDIA + 昇腾❌ 模型支持窄:当前只主打 V4.1-Flash,不像 vLLM/SGLang 百花齐放支持上百模型 ❌ 只是引擎内核,不是开箱即用服务:缺分布式 KV cache、prefill/decode 分离网关层
六、License & Citation
Apache License 2.0,可商用;引用 BibTeX:
@misc{deepinfer2026,
  title = {DeepInfer: High-performance, large-scale inference framework for DeepSeek models},
  author = {DeepSeek-AI},
  year = {2026},
  publisher = {GitHub},
  howpublished = {\url{https://github.com/deepseek-ai/DeepInfer}},
}
七、思维导图
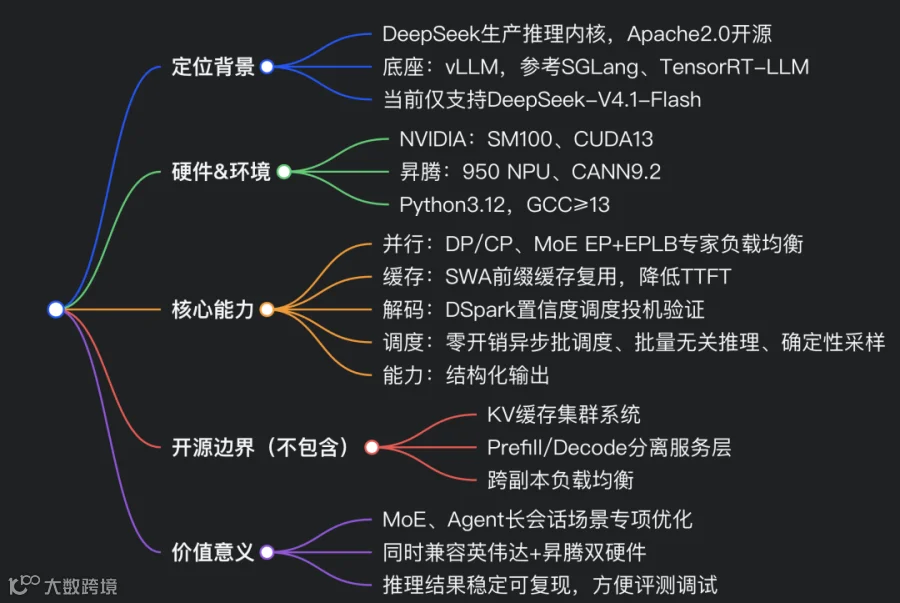
DeepInfer
├─ 定位:DeepSeek 生产推理引擎开源版|离线内核
├─ 底座:vLLM,参考 SGLang / TensorRT-LLM
├─ 模型:DeepSeek-V4.1-Flash
├─ 硬件:SM100 / Ascend950
├─ 核心技术
│  ├─ 并行:DP / CP / MoE EP+EPLB
│  ├─ 缓存:SWA bounded replay(前缀复用)
│  ├─ 解码:DSpark 置信度投机验证
│  └─ 调度:零开销异步批调度、batch-invariant、确定性采样
├─ 能力:结构化输出
├─ 缺失(开源版不含)
│  ├─ KV cache 集群系统
│  ├─ Prefill/Decode 分离服务网关
│  └─ 跨副本负载均衡
├─ 构建:build.sh + DEEPINFER_ACCELERATOR
└─ License:Apache 2.0
八、Q&A 快速清单
Q1:DeepInfer 可以直接拿来做线上 OpenAI 兼容服务吗? A1:不行。开源包只给离线引擎;线上 disagg 服务层、KV cache 集群、负载均衡需要自己补齐。
Q2:SWA bounded replay 和 SGLang RadixAttention 区别? A2:目标类似(前缀缓存复用),实现独立;SWA 是 DeepSeek 为 V4.1-Flash MLA 架构定制的 bounded replay 方案。
Q3:EPLB 解决什么? A3:MoE 推理专家负载不均衡,token 分配不均导致部分卡跑满、部分卡空闲,EPLB 做专家负载调度。
Q4:batch-invariant inference 价值? A4:同一 prompt,无论 batch size 多大,输出完全一致;评测、Agent 调试、故障复现非常重要。
Q5:能不能跑其他模型(如 Llama、Qwen)? A5:当前版本官方只支持 DeepSeek-V4.1-Flash,没有通用模型适配层。