


10 个关键问题Q&A
-
Q:论文核心研究问题是什么? A:验证 GPT‑6‑Astra 是否真正实现具身智能。 -
Q:实验采用什么学习方式? A:ICL 上下文学习,仅利用演示生成知识包,不微调模型权重。 -
Q:仿真环境下最大优势是什么? A:充足交互预算下,在大部分具身仿真基准超越 SOTA。 -
Q:System1 和 System2 分别承担什么工作? A:System2(GPT‑6‑Astra)高层推理规划;System1(VLA)底层运动控制。 -
Q:哪种协同模式效果最好? A:闭环协同,底层输出动作候选,由大模型审核筛选,代价是 Token 消耗高。 -
Q:真机实验有什么有趣的涌现能力? A:主动视觉,自主移动相机获取必要观测,例如利用闲置机械臂拍摄瓶口完成插花。 -
Q:仿真的结论为什么不能直接落地真机? A:真机存在硬件急停、电机限制、推理耗时,不能靠增加步数弥补错误。 -
Q:现有具身基准的主要缺陷? A:为模仿学习设计,提供大量演示,推理暂停世界,仅评判最终状态,不适合大模型 Agent。 -
Q:新一代具身基准三大原则? A:任务来自真实需求、测试阶段无领域演示、推理时物理世界时钟持续运行。 -
Q:论文最终核心结论? A:GPT‑6‑Astra 具备具身能力,但尚未实现实用化具身智能。
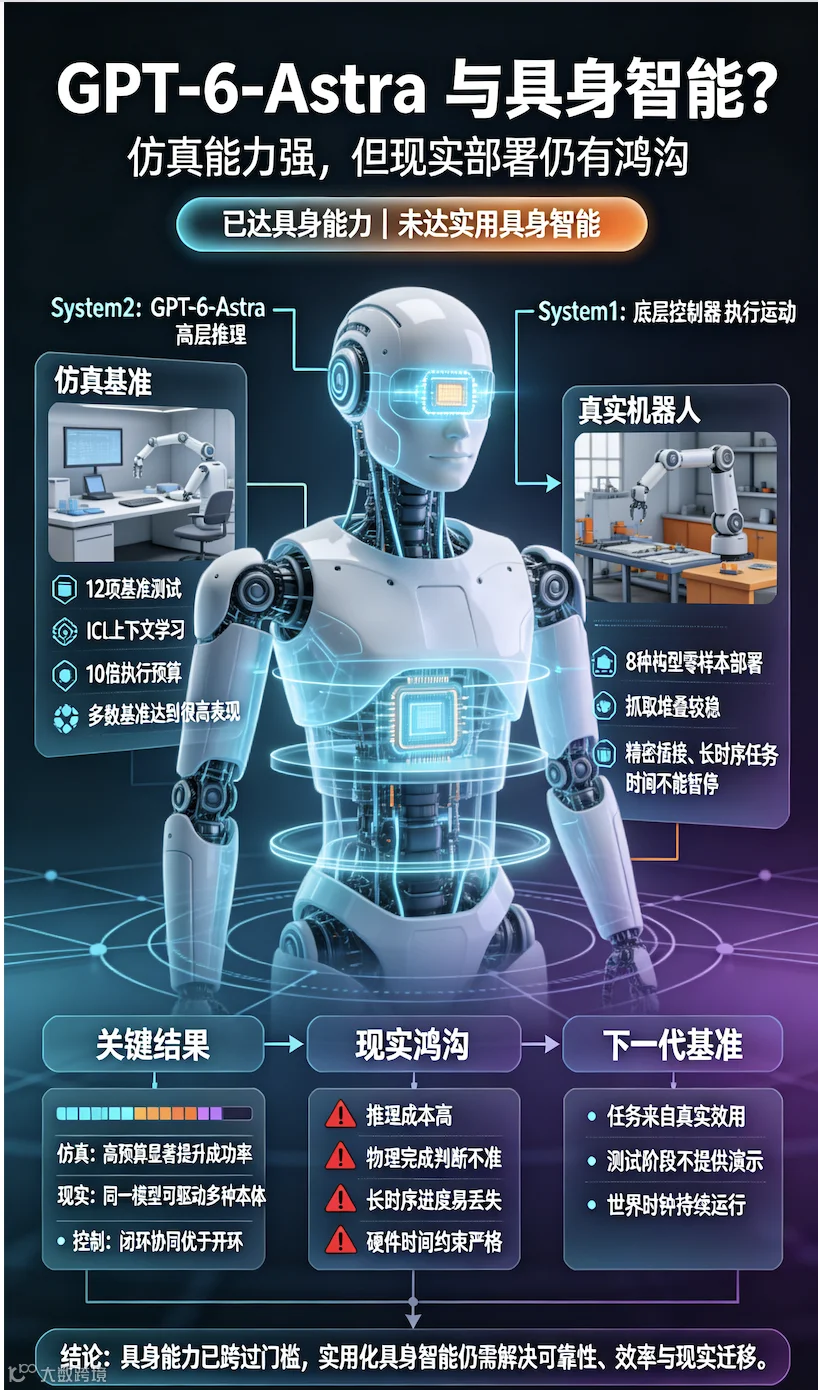
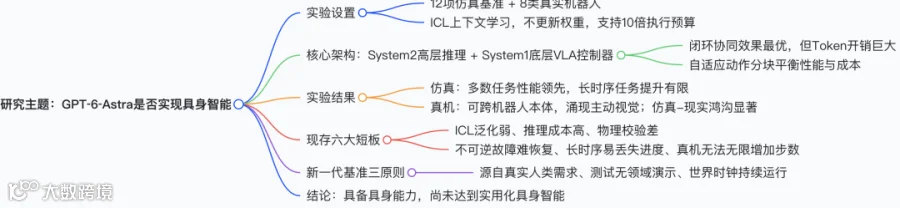
该论文为联合研究团队发布的技术报告,arXiv 编号 2610.22471,核心研究GPT‑6‑Astra 是否真正实现具身智能。通过大规模仿真基准评测、控制框架消融实验、多台真实机器人实物验证,并提出下一代具身智能基准设计思路;核心结论:GPT‑6‑Astra 在仿真基准上已经跨过具身能力门槛,但还未达到实用化具身智能,最大难题是把仿真基准上的优异表现迁移到真实世界,实现可靠、高效、可规模化部署。
一、研究整体框架
论文分为四大研究模块:
-
探测纯模型本身能力上限:在 12 项具身仿真基准开展大规模评测; -
具身控制的代理框架(harness)消融实验:研究高层推理 System2(GPT‑6‑Astra)和底层控制器 System1 的协同机制; -
真实硬件部署验证:8 种不同构型物理机器人开展零样本实验,揭示仿真与现实之间的巨大鸿沟; -
下一代具身基准原型设计:批判现有基准的缺陷,提出三条新的基准设计原则并搭建家庭场景原型。
两个核心实验协议条件:
- 上下文学习 ICL
允许模型从训练集演示中提取知识包(knowledge package),不更新模型权重; - 扩展执行预算
最多放大至官方标准步骤的10 倍,给模型更多机会纠错、从失败中恢复。
二、仿真环境大规模评测(12 个基准)
2.1 评测基准分类
覆盖桌面机械臂、人形机器人、移动平台、灵巧手、家庭任务、视觉语言导航六大方向,包括 LIBERO 系列、RoboDojo、Bench2Dex、DexJoCo、SIMPLE、BEHAVIOR、VLN‑CE、LHPR‑VLN 等 12 个代表性基准。
知识包(Knowledge Package):ICL 准备阶段,GPT‑6‑Astra 分析训练演示生成冻结知识包,测试阶段直接复用,不微调权重。知识包包含 6 部分:任务指引、运动参考、视觉参考、可执行辅助代码、检查与故障恢复策略、元数据与来源记录。知识包不会跨任务泛化,只擅长和训练演示分布接近的任务。
2.2 关键实验结果
- 标准预算 (1×)
GPT‑6‑Astra+ICL 在绝大多数基准超过 SOTA;LIBERO 系列、SIMPLE 接近饱和;RoboDojo 54.2%、DexJoCo 78.2%;但 RoboLab(无训练集,无法做 ICL)、LHPR‑VLN 长时导航、BEHAVIOR 家庭任务表现仍然有限。 - 10 倍扩展预算
大量任务成功率大幅上涨。RoboDojo 从 54.2% 提升至 81.9%,Bench2Dex 从 25.6% 提升至 61.5%;LIBERO 系列接近 100%;导航任务 VLN‑CE 也明显提升;但 LHPR‑VLN 长时序导航提升微弱,单纯增加步数无法解决长时序规划缺陷。BEHAVIOR 不做 10 倍扩展评测。
2.3 仿真下识别出五大核心缺陷
- ICL 泛化弱
知识包高度绑定训练演示,任务分布偏移后性能暴跌;RoboLab 没有训练演示,性能显著受限。 - 高昂推理成本
token 消耗、墙钟时间巨大,部分长时序任务单集耗时数小时,无法商业化落地。 - 物理成功校验能力差
模型主观判断任务完成,但物理世界实际并未达成;视觉上看起来完成不等于真实完成。 - 不可逆失败难以恢复
一旦发生打翻液体、零件掉落等不可逆事故,即便剩余大量步骤也无法挽回任务。 - 长时序进度维护困难
多子任务串行执行时,已经完成的中间状态容易被后续动作破坏,丢失任务进度。
典型失败案例:拼图装配、倾倒液体、存放笔记本电脑耳机等任务,见图 6。
三、控制框架(Harness)消融实验
研究如何搭建 System2(GPT‑6‑Astra 高层推理)与 System1(底层 VLA 控制器,\(\pi_{0.5}\))的协同系统,分为两大实验方向:系统协同模式、动作表示与分块策略。
3.1 System1‑System2 协同模式对比
-
单独 VLA (System1):成功率很低,仅 6.91%; - 开环协同
GPT 输出子目标,VLA 直接执行动作,无复核,性能反而变差 5.83%; - 闭环协同
VLA 生成候选动作,交由 GPT‑6‑Astra 审核、修改或者拒绝,成功率显著提升,但 token 开销巨大; -
增大单次审核动作数量\(L=4\):降低 63.5% token 消耗,同时小幅提升成功率; -
ICL + 闭环 VLA 协同:取得最高成功率 54.17%,但 token 开销暴涨,代价极高。
核心结论:高层推理 + 底层控制器闭环协作效果最好,但推理成本是现实部署巨大阻碍;批量审核多步动作是平衡性能与开销的重要手段。
3.2 动作表示与动作分块(chunking)
-
关节角直接控制:性能最差,存在多模态推理与底层机器人控制之间的表征鸿沟; -
方向运动命令:效果优于关节角控制; - 自适应动作分块
模型自主选择每轮生成多少个动作,对比固定长度分块,在可控 token 开销下获得更高成功率。
启示:动作接口需要匹配大模型语义推理能力,把精细运动交给底层控制器,高层输出语义级目标。
四、真实世界机器人零样本部署验证
使用8 台不同构型真实机器人,全部零样本,没有任务演示;仅提供人类编写的机器人先验信息;评测使用墙钟时间(60 分钟上限),而非仿真的步骤预算,人工评判任务成败。 机器人清单:3 台单臂夹爪机器人、1 台双臂夹爪机器人、1 台灵巧手双臂机器人、2 台轮式移动机械臂、1 台 Unitree G1 人形机器人。
4.1 三大关键发现
- 同一个模型可以驱动多种本体
性能由任务类型决定:刚性物体抓取堆叠效果很好;可变形物体、精密插接、长时序移动搜索任务非常困难。 - 主动视觉涌现能力
模型会主动移动相机,获得完成任务所必需观测。案例:单臂执行插花任务,手腕相机看不到花瓶瓶口而失败;双臂机器人会移动空闲手臂,用它的手腕相机观测瓶口,完成插花。这种行为不会出现在示教数据中,是模型自主涌现。 -
GPT‑6‑Astra(System2,慢速高层推理)可以直接对接底层 System0 电机控制器,完成人形机器人操作;但是高层推理速度远低于机器人运动,只能做到可行,达不到实时高性能。
4.2 仿真假设在现实世界全部失效
- 不能靠增加执行时间换取成功率
-
安全约束:碰撞触发硬件急停,任务直接终止; -
机械硬件极限:电机过热、关节堵转会中断实验; -
真实时间成本:推理占用大量墙钟时间,人形实验 90% 时间消耗在模型思考。仿真环境推理时模拟器可以暂停,现实世界时间持续流逝。 - ICL 依赖的演示数据现实很难获取
现实新任务几乎没有现成演示;模型性能高度依赖人类编写的上下文先验;灵巧手任务,如果没有人类手写抓取脚本,模型完全无法完成抓取。
五、下一代具身智能基准的设计
现有基准大多为模仿学习训练策略设计:提供大量任务演示、环境在模型推理时暂停、评判只看某一个时刻的目标状态;这类基准不适合通用大模型 Agent。论文提出下一代基准三原则,并搭建一室一厅家庭仿真原型(NVIDIA Isaac Sim)。
5.1 三大设计原则
- 任务源自人类真实需求,而不是机器人现有能力
用普通人自然语言描述需求;评价看任务效用,而不是单一固定目标状态;同时还要处理隐含义务(比如做完早餐必须关上冰箱、关掉灶台),用效用函数打分,而不是二元成功 / 失败。 - 测试阶段不提供领域内演示
智能体必须依靠部署过程中的自主探索来理解环境、物体、器具,不能依赖现成示范。 - 世界时钟持续运行
模型思考推理的时候,物理世界持续演化;推理延迟本身成为评价指标;评价要看完整轨迹,而不是某一帧最终状态。
5.2 家庭原型实验暴露 GPT‑6‑Astra 短板
- 只关注当下对象,遗忘全局环境状态
整理桌面时碰掉周边物体;拿牛奶打开冰箱后,转头做别的事情,冰箱门长时间敞开; - 没有演示就很难理解陌生器具与自身身体位姿约束
打开冰箱门之后,不知道调整机器人底座位置,释放的冰箱门直接挡住自己手臂;面对水龙头只会反复推,不会旋转开关,造成水漫水槽。 - 观测信息随推理时间过时
观察鸡蛋已经煎好,但是思考消耗大量世界时间,等输出动作,鸡蛋已经煎焦。
5.3 实现新一代基准现存工程挑战
-
评判系统难题:如何可靠评判复杂物理任务;视觉‑语言评判器准确率有限; -
仿真保真度: household 长时序家庭任务,仿真物理和真实世界存在差距; -
世界时钟运行带来的计算开销巨大; -
真实机器人 / 高保真仿真实验成本高昂,复现对比实验代价大。
六、局限总结
汇总 GPT‑6‑Astra 现存六大技术短板:
-
ICL 上下文学习跨任务迁移能力有限; -
推理 token 与时间成本过高,距离商业化部署差距大; -
物理任务完成状态校验机制缺失; -
很难从不可逆的故障场景恢复; -
长时序任务难以维护已经完成的子任务进度; -
现实硬件中,不能依靠无限增加交互步骤来修复错误。
七、最终结论
GPT‑6‑Astra 代表具身智能领域重要跃迁。借助 ICL 上下文学习与充足交互预算,它可以在大量仿真基准达到接近饱和的性能。但仿真上的好结果不能直接迁移到现实机器人。
已经达成:具身能力(embodied competence);尚未达成:实用化具身智能(practical embodied intelligence)。 未来研究重点不再仅仅攻克更多孤立仿真任务,而是解决真实部署场景下可靠性、效率、泛化、成本等现实约束。
补充附录要点
附录提供完整评测数据:12 个基准详细成功率、token 消耗、耗时;Harness 消融全部表格;8 台真实机器人完整任务、失败案例;同时综述相关工作:VLA 视觉语言动作模型、世界动作模型 WAM、现有各类具身基准、前沿大模型用于机器人的实证研究。