


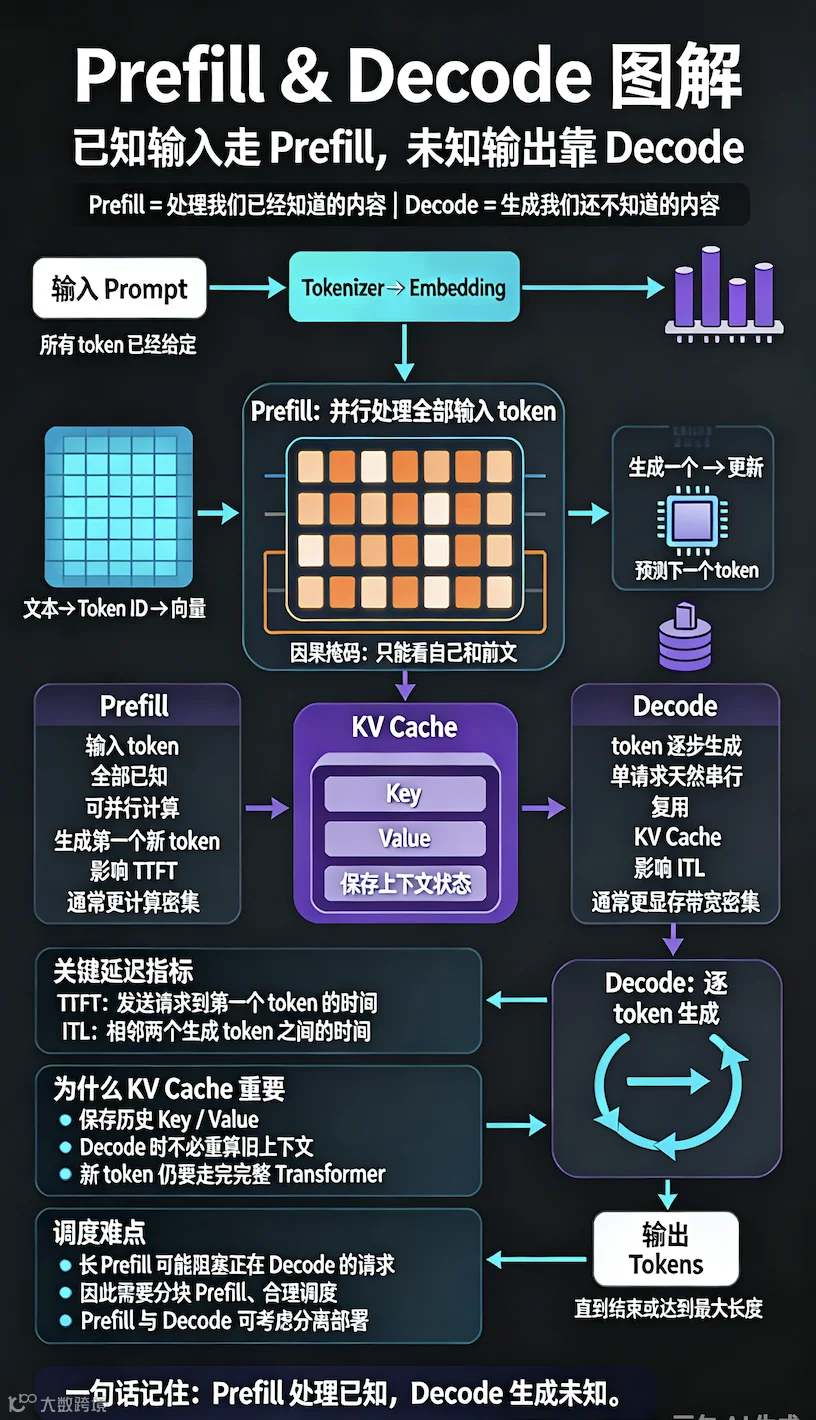
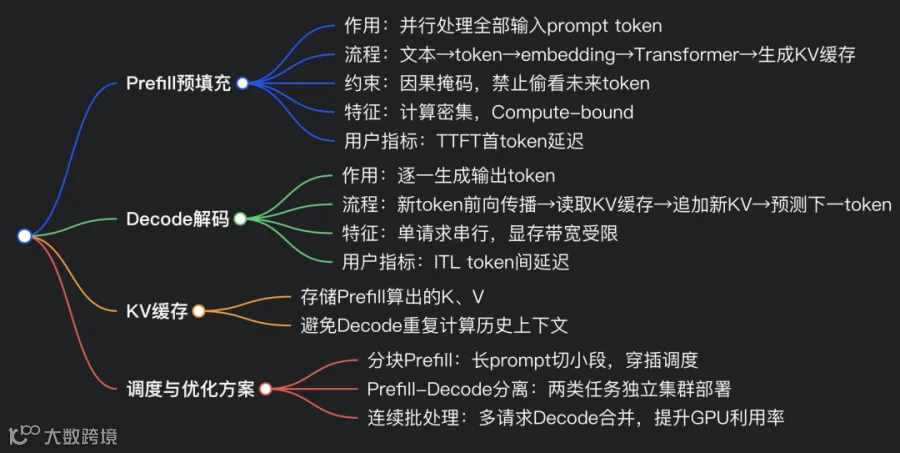
编者摘要:Prefill(预填充)与 Decode(解码)是 LLM 推理两大核心阶段。Prefill 处理用户完整提示词,所有输入 token 已知,可在 GPU 上并行计算。文本先分词、转嵌入向量,送入 Transformer,每层计算 QKV,同时保存 K、V 至 KV 缓存;因果掩码阻止 token 偷看后续位置信息,避免自回归模型作弊。Prefill 结束产出首个输出 token,这段等待时间即 TTFT 首 token 延迟。Prefill 属于计算密集型任务,瓶颈多为 GPU 算力。
Decode 是逐 token 生成阶段。单条请求每轮仅处理 1 个新 token,新 token 做前向传播,直接复用 KV 缓存里历史上下文的 K、V,仅把新 token 的 KV 追加进缓存,循环生成直到终止。Decode 单请求天然串行,瓶颈一般是显存带宽。衡量指标为 ITL,即 token 间延迟。
两者负载差异带来调度难题:长 prompt 的大 Prefill 任务容易抢占 GPU 资源,拖慢正在运行的 Decode 请求。因此衍生出分块 Prefill、Prefill-Decode 分离部署等优化方案。分块 Prefill 将长提示词切小段,穿插调度 Prefill 与 Decode;分离部署把两个阶段放在不同算力集群,可独立扩资源,但存在 KV 缓存传输开销。KV 缓存是两阶段桥梁,保存注意力状态,避免 Decode 重复计算历史上下文,是推理加速核心。
10 个关键问题 Q&A
-
Q:Prefill 和 Decode 最本质区别是什么? A:Prefill 处理已知的输入提示词,支持并行计算;Decode 生成未知输出 token,单请求逐 token 串行。 -
Q:什么是 KV 缓存,在哪个阶段创建? A:KV 缓存保存各层 Transformer 的 Key、Value 向量,Prefill 阶段生成,Decode 复用以节省算力。 -
Q:为什么 Prefill 可以并行处理 prompt 的所有 token? A:提示词全部 token 提前输入模型;搭配因果掩码,保证 token 不能读取后续位置,不破坏自回归约束。 -
Q:TTFT 是什么,主要由哪个阶段决定? A:首 token 延迟,从发请求到返回第一个 token 的耗时,主要由 Prefill 耗时决定。 -
Q:为什么 Decode 不能一次性并行生成全部回复? A:输出 token 未知,下一个 token 依赖上一步生成结果,单条请求只能逐个生成。 -
Q:Prefill 是计算受限,Decode 是显存带宽受限,原因? A:Prefill 大量 token 做大规模矩阵运算,瓶颈在 GPU 算力;Decode 每次仅 1 个新 token,大量时间用来读取模型权重与 KV 缓存,瓶颈在 HBM 带宽。 -
Q:KV 缓存会跳过 Transformer 的 MLP 层计算吗? A:不会。新 token 依然完整走完 Transformer 所有层;缓存仅省去旧上下文 token 的重复计算。 -
Q:什么是分块 Prefill,解决什么问题? A:超长提示词切分成小块执行,让 Prefill 任务和 Decode 任务交替调度,防止长 prompt 抢占 GPU 拖慢流式输出。 -
Q:Prefill-Decode 分离部署是什么,优缺点? A:用独立集群分别跑 Prefill、Decode,可以独立扩容;缺点是 KV 缓存跨节点传输带来网络开销,调度更复杂。 -
Q:连续批处理主要优化哪个阶段?原理? A:优化 Decode。收集多条请求的单 token 打包成 batch 并行处理,提升 GPU 利用率。
说明:译文尽量保留原文叙事风格,专业术语采用国内大模型推理领域通用译法
Prefill(预填充)与 Decode(解码)彻底讲明白
这两个术语十分常见。你大概率听过,甚至自以为懂它们的含义。但我发现,就算我以前听说过 prefill 和 decode,其实并没有真正理解。
我刚接触模型推理时对这两个概念的理解,和它们真实的工作机制相差很远。
所以我认为,一份清晰准确的解释,能帮你避开很多错误认知、脑补误解,防止后续因为理解不到位而套用错误逻辑。
我不会直接抛出 prefill、decode 的定义,随便搜一下或者问 AI 都能查到。我只想让你搞懂:这两个阶段在整个 LLM 推理链路里到底出现在哪个环节。只要这点想通,你自然就明白它们是什么。
免责声明:本文篇幅较长,我会从第一性原理一步步拆解,不赶进度,希望你做好心理准备。
好,我们从一个简单场景开始:和 Grok、ChatGPT、Claude 或者任意大模型聊天(下文统一简称 GPT 简化描述)。
打开对话页面,新建对话,输入提示词:
Hi, my name is X.(你好,我叫 X)
按下回车。短暂等待 1 秒、1.5 秒或者 2 秒,模型开始返回结果,输出前几个 token:
Hello X...(你好 X……)
接着持续生成剩余内容,全部输出完成后停止。我们和大模型聊天基本就是这个流程:输入指令,稍作等待,然后接收模型回复。
接下来深入看看背后发生了什么。正式深入前,先铺垫基础概念,方便理解。
GPT、Llama、Claude 这类现代大语言模型,属于自回归模型(autoregressive model)。
自回归是什么意思? 简单说:模型基于已经生成好的 token预测下一个 token。
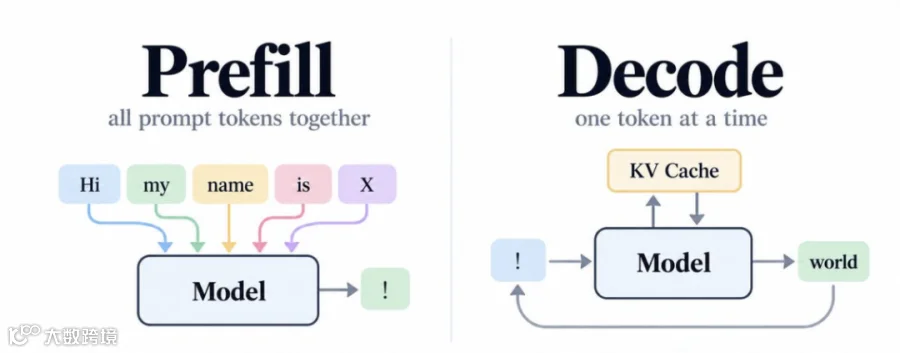
举个极简例子,模型当前读到:Hello基于这个内容,预测下一个 token,假设是world。 序列变成:Hello world。 模型再用Hello world预测下一个 token,比如!。这个过程不断循环。
前面说的整段回复生成过程,本质就是反复执行这个逻辑:
-
接收你的提示词输入 -
预测第一个新 token -
上下文 = 原始提示词 + 刚生成的 token,基于这个新上下文预测下一个 token -
不断追加新 token,直到输出序列终止符、达到最大输出长度,生成结束。
基础概念看完,回到 ChatGPT 的例子。你输入:Hi, my name is X.按下回车,提示词发送到模型服务器。直观感受是模型 “读懂” 了这句话,但这里有个关键点:
提示词是文本字符串,模型并不能像人一样直接读取文字。模型内部本质是海量矩阵与数值。
第一步:文本分词。文本被切分成 token,每个 token 对应一个 token ID。你可以去 OpenAI 的 tokenizer 网页亲自测试。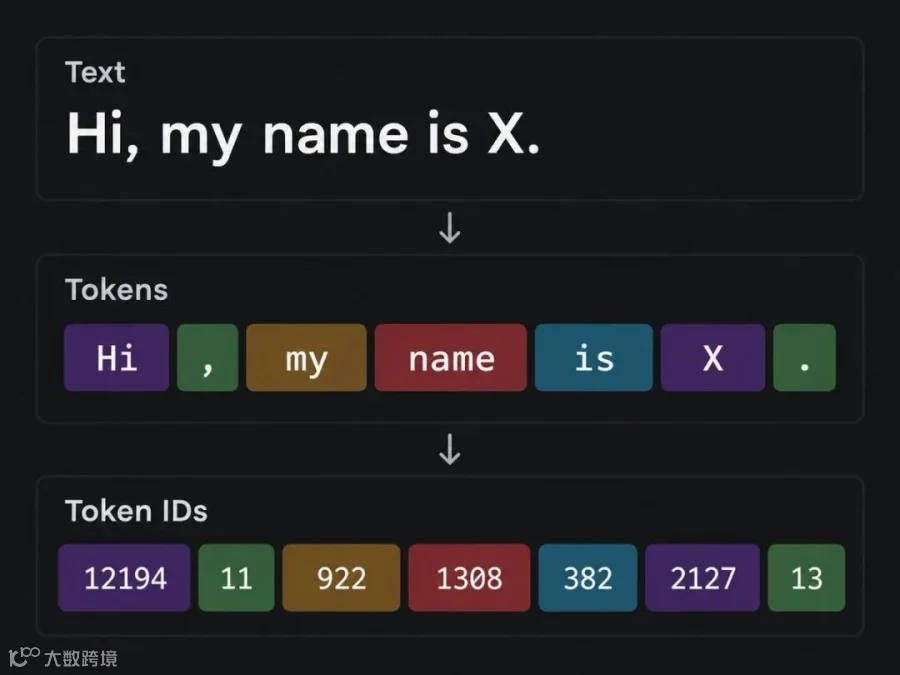
拿到 token ID 之后,依然不能直接送入 Transformer 层。 每个 token ID 会映射为嵌入向量(embedding),也就是一串数字构成向量。向量可以理解为包含多个维度数字的数学数组。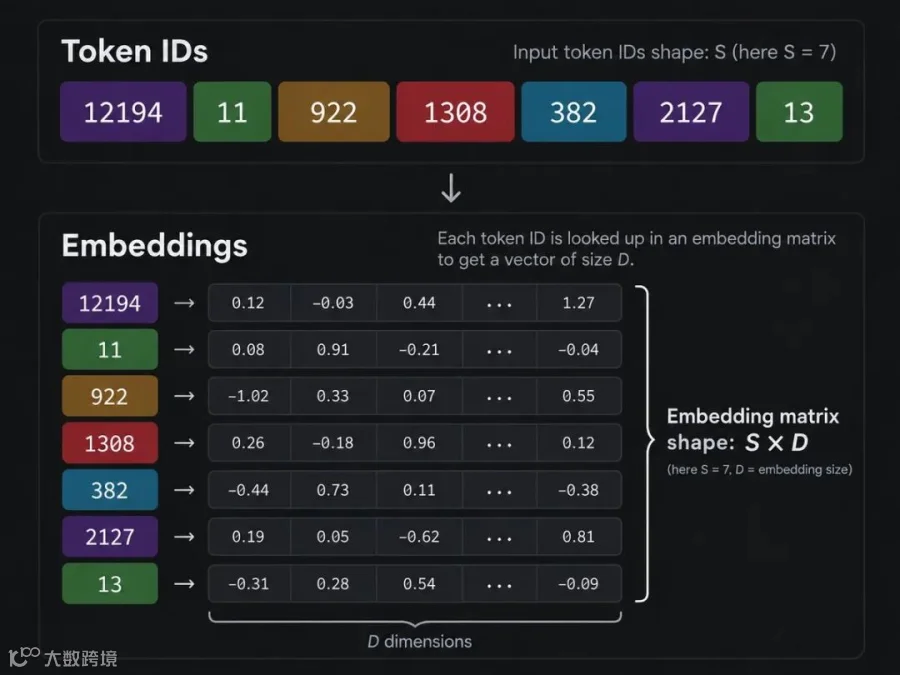
假设提示词一共有 S 个 token,模型嵌入维度为 D。 每个 token 转化成 D 维向量;把 S 个 token 的向量堆叠在一起,输入就变成矩阵: \(X ∈ R^{S × D}\)
-
S = 输入序列 token 总数 -
D = 模型隐藏层 / 嵌入维度
文本流转链路: 文本 → token 分词 → token ID → 嵌入向量矩阵。
得到这个 S×D 数值矩阵,Transformer 计算正式启动,Prefill(预填充)阶段也就从这里开始。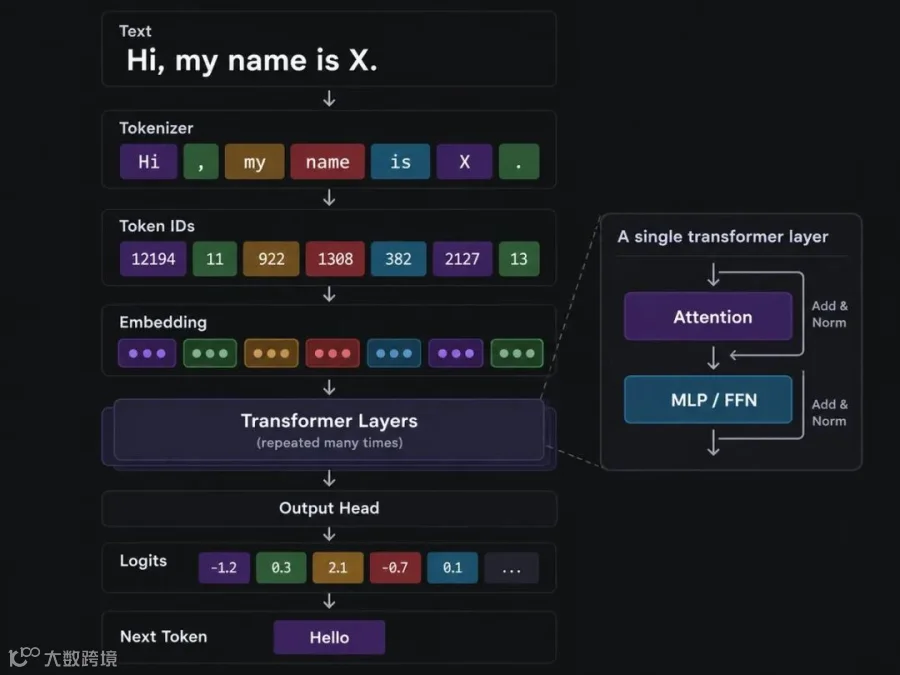
矩阵送入 Transformer 层。如果你了解基础 Transformer 架构,就知道每个 Transformer 模块内部两大核心模块:注意力机制、MLP 前馈网络。
本文不深入讲解注意力底层原理,不然文章重心就跑偏了。但有一点至关重要。
假设输入一共 10 个 token。很多人会下意识以为模型依次处理 token1、token2、token3…… 毕竟它是自回归模型,不是吗?
我最开始也是这么想,但这个理解是错的。 处理输入提示词阶段,并不是逐个串行处理 token。
原因很简单:提示词所有 token 已经全部给到模型。 你的提示词Hi, my name is X里所有 token 都是已知的。那为什么要逐个串行计算?完全可以并行一次性处理,速度快得多。
模型不需要先算出my,才能读到name; 也不需要算出name,才能读到Abhinandan。 所有 token 都已经提供给模型。一次性并行处理全部输入提示词的这个阶段,就叫做 Prefill 预填充。
简单概括:Prefill 就是模型处理提示词内全部已知 token 的阶段。
你可能会问:全部 token 并行计算,那 token1 岂不是能看到后面的 token10? 我们先解释为什么这会是个问题: 自回归模型的规则,是只能使用当前位置之前的 token 预测下一个 token。 比如句子:The sky is blue。 当读到The sky is,要预测下一个 token 时,模型只能看到The sky is,不能提前看到blue—— 这正是它要预测的目标。
如果预测的时候就提前看到答案,相当于考试时题目旁边直接标好了正确选项,模型自然能答对,这就是 “作弊”。
所以,Prefill 阶段并行计算 ≠ 每个 token 能看到后面未来位置的 token。 并行运算可以同时执行,但每个 token 能访问的信息必须遵守自回归约束: token 只能看到自身以及它前面的 token,不能偷看后面的 token。 这个约束就是因果掩码(causal mask)。
token1 只能看到 token1; token2 可以看到 token1、token2; token3 可以看到 token1、token2、token3,以此类推。
GPU 依然可以一次性并行算出所有位置,因果掩码只是屏蔽未来 token 的信息。 一句话区分:允许并行计算,但禁止读取未来信息。
很多人有一个误区:
“自回归模型就必须一个 token 接一个 token 串行跑。” 这个说法,在生成输出阶段成立,但处理提示词阶段不成立。 提示词内容是预先存在的,输出内容还没有生成。 这个微小差异,正是 Prefill 和 Decode 成为两个完全不同阶段的根源。
继续深入 Prefill 内部。注意力层会对每个 token 计算三组变量:Query 查询向量、Key 键向量、Value 值向量,简称 Q、K、V。这里默认你有注意力基础认知。
如果提示词有 S 个 token,每一层 Transformer 都会为每个 token 算出 K 和 V。 重点来了:算出 K、V 之后,不会直接丢弃,而是保存下来。 这一组持久存储的 K、V,就是KV 缓存(KV cache)。
为什么要保存?当下看只是保存计算结果,进入 Decode 阶段你就会明白它的巨大价值。
记住这个要点:Prefill 阶段处理全部提示词 token(注意力 + MLP),同步计算每个 token 的 K、V 并存入 KV 缓存。
提示词依次经过第 1 层、第 2 层直到最后一层 Transformer。模型末端通过 LM 头输出 logits,也就是词汇表上原始预测分值,基于分值选出下一个 token。
回到我们的例子:提示词Hi, my name is X.完成 Prefill 之后,模型选出第一个输出 token:Hello。
这里很关键:第一个输出 token,是 Prefill 阶段结束之后才产生的。这就是为什么你在 ChatGPT 按下回车之后,要等待一段时间,才会看到第一个文字。模型先要完整处理你的提示词,之后才能产出第一个新 token。
这段等待时间,行业称为 TTFT(Time To First Token,首 token 延迟)。 发送请求 → 等待一段时间 → 第一个 token 出现。
TTFT 同时受调度、网络、批处理、服务器负载等很多因素影响;但从模型执行角度,Prefill 是造成这段等待的核心环节之一。 也很容易理解:提示词越长,Prefill 要处理的数据越多,看到首 token 等待时间就越长。
到这里为止,模型处理的内容全部来自你的输入,token 都是预先给定的。 现在模型生成了第一个 token:Hello。 自回归模型接下来要基于Hello预测下一个 token,假设是X。
但这里和提示词阶段完全不同:X是未知的,必须先生成Hello,才能用它预测X;等X生成,再用X预测下一个 token。 输出侧的 token 事先不存在,无法一次性并行算出全部输出。这个阶段,就是 Decode 解码阶段。
Decode 就是生成阶段:生成 1 个新 token,用它预测下一个;再拿新生成的 token 继续预测,循环往复直到回复结束。
最简一句话区分两个阶段:
-
Prefill:token 全部已知 -
Decode:token 正在被创造
但还有一个疑问:Prefill 结束,上下文是Hi, my name is X.,模型输出Hello。 预测下一个 token 的时候,难道要把完整序列Hi, my name is X. Hello全部重新跑一遍 Transformer 吗?每新增一个 token,就从头到尾重算全部上下文?
如果这么做,算力浪费极其严重。原始提示词已经算过一遍,没必要每生成一个 token,重复计算相同内容。 这就是 Prefill 阶段保存 KV 缓存的意义。
Prefill 阶段,我们已经把提示词所有 token 的 K、V 保存在 KV 缓存。 现在新 tokenHello送入模型,只需要单独计算这个新 token 的 Q、K、V;历史所有旧 token 的 K、V 直接从 KV 缓存读取,无需重算。 新 token 的 Query,读取缓存里历史的 K、V 做注意力计算。 然后把这个新 token 的 K、V 追加写入 KV 缓存。 现在 KV 缓存 = 原始提示词 + Hello。
下一个 token 到来时,流程不变: 单独处理新 token,它的 Query 读取缓存内全部历史 K/V;生成当前 token 的 K、V 追加进缓存;计算 logits,输出下一个 token,循环往复。这就是 Decode 循环。
这里澄清一个极易混淆的误区: 很多人听说 “KV 缓存帮 Decode 节省算力”,就误以为 Decode 阶段只跑注意力层,跳过 Transformer 其他部分。并不是这样。
新 token 依然完整走完整个 Transformer 链路:注意力层 → MLP → 下一个 Transformer 层,逐层走完。 节省算力的本质:旧上下文 token 不再重复经过所有层计算。新 token 本身仍然完整执行一次前向传播。
举例子:上下文一共 2000 个 token,Decode 阶段不会为 2000 个旧 token 重复跑 MLP,只把新生成的单个 token 送入 MLP。 注意力计算上,新 token 依然要读取全部历史上下文,KV 缓存让我们不用重复计算旧 token 的 K、V。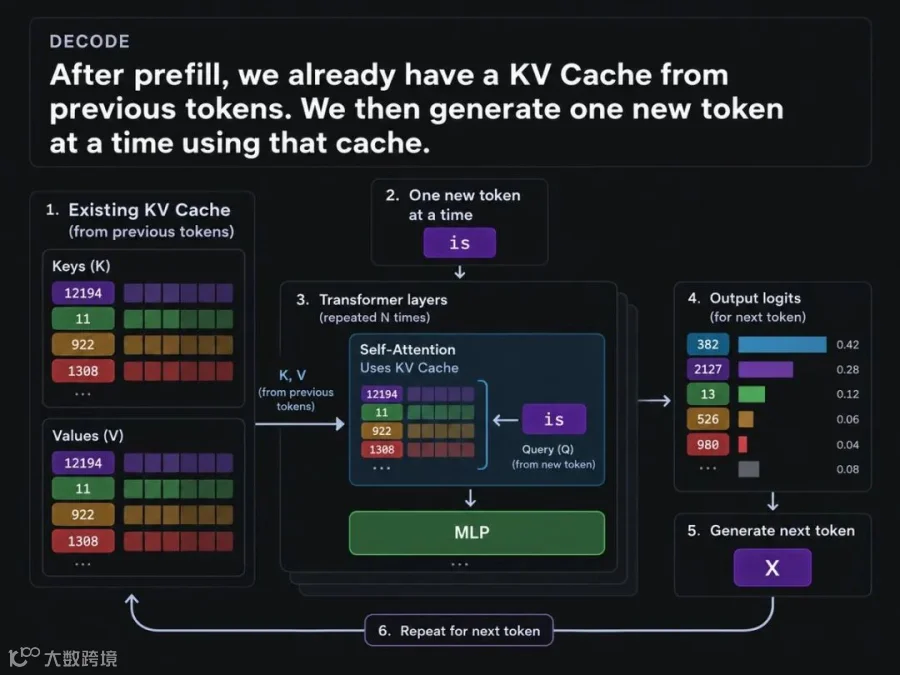
理解这点,才能建立正确的 KV 缓存认知。
有意思的一点:Prefill 和 Decode 使用完全同一个模型,相同 Transformer、相同权重、相同注意力、相同 MLP。 但站在 GPU 视角,两个阶段的负载特征天差地别。
继续举例:提示词共 2000 个 token。Prefill 阶段,输入是包含全部 token 表征的矩阵。注意力、MLP 内部线性计算可以执行大规模矩阵乘法,大量计算任务并行执行。
GPU 天生擅长这类任务,海量 CUDA 核心与张量核心,大规模矩阵运算可以充分把所有计算单元占满。 Prefill 阶段并行度很高:大量 token 同时执行多层 Transformer 的注意力 + MLP,单次运算量巨大,可达数十亿甚至上万亿次运算。 所以行业常说:Prefill 一般是计算受限(compute-bound)。
什么叫计算受限? 任务瓶颈是 GPU 算力。有足够多数据让 GPU 保持满载,待完成的数学运算量巨大。提升算力,就能直接加快 Prefill 速度。
再看 Decode。单条请求,每一步只有1 个新 token。 单个向量送入这个参数规模可达千亿甚至万亿的大模型。每一步 Decode,GPU 仍然需要读取全部模型权重,但仅单个 token 带来的计算量很小。相比需要搬运的数据量,计算工作量很少。 所以 Decode 通常是显存带宽受限(memory-bandwidth bound)。
显存带宽受限含义:GPU 算力足够完成运算,瓶颈在于数据搬运速度 —— 把模型权重、KV 缓存数据从高带宽显存(HBM)读取到计算单元。 Decode 场景下,GPU 大量时间都在等待数据从内存载入计算核心。HBM 带宽越高,权重与缓存数据送入 GPU 核心越快,Decode 速度越高。
简单总结:
-
Prefill:大量 token,海量矩阵运算 → 瓶颈一般是算力(compute-bound) -
Decode:每次仅 1 个新 token,大量权重读取 → 瓶颈一般是显存带宽(memory-bound)
当然真实生产系统还有批处理、内核优化、不同硬件架构等各种变量。但这就是两者在 GPU 上负载差异的底层原因。
这也解释了为什么推理引擎非常重视 Decode 批处理。 假设只有 1 条请求在做 Decode,每一步仅 1 个新 token,对庞大 GPU 来说并行任务太少,资源浪费。 如果同时有 100 个用户在生成回复,每一轮 Decode,就可以拿到 100 条请求各自的 1 个新 token,打包成一批同时处理。GPU 一次性拿到更多计算任务。 这是 LLM 服务中批处理至关重要的原因。现代推理引擎还有连续批处理(continuous batching),请求可以动态加入、退出批次,不用等整批全部跑完。这个话题可以单独展开。
重点:单条请求的 Decode 天然串行;推理引擎通过多请求合并,在请求之间创造并行度。
回到 ChatGPT 的用户体验:输入提示词,回车,页面短暂空白。这段时间正在执行 Prefill 处理提示词。 随后第一个 token 出现,之后 token 逐个流式输出,反复执行 Decode 循环。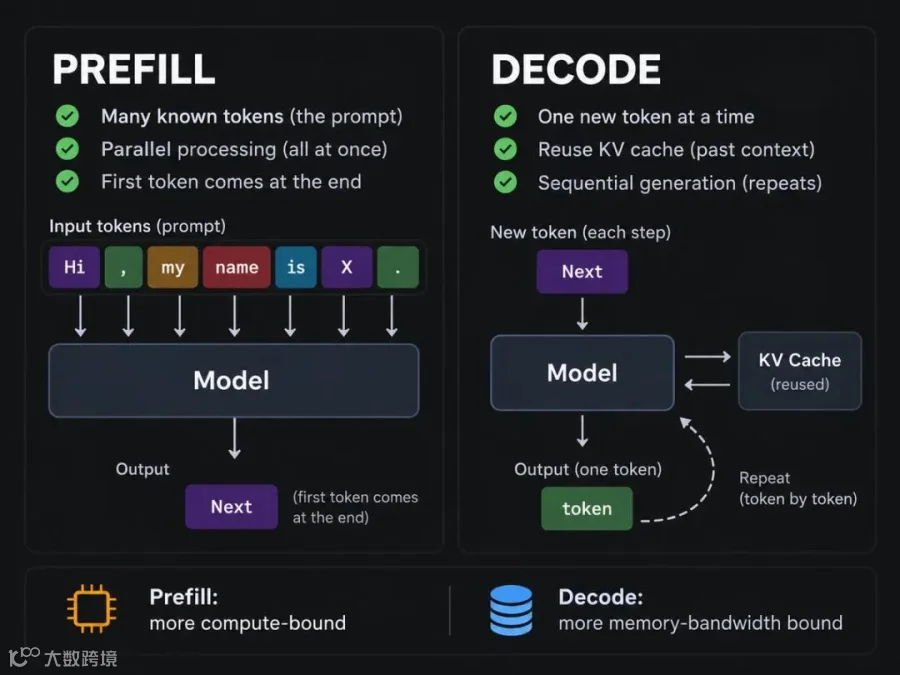
由此引出推理领域两个核心延迟指标:
-
TTFT(首 token 延迟):发送请求到返回第一个 token 耗时 -
ITL(Inter-Token Latency,token 间延迟):Decode 阶段,相邻两个生成 token 之间的间隔。
TTFT 差 = 等很久才看到第一个字; TTFT 很好,但后续输出很慢,代表 Decode 的 token 间延迟差。 用户体感上,就能区分这两个阶段。
举两个极端例子,进一步强化理解: 请求 A:输入 20000token,只需要输出 20token。 Prefill 工作量巨大,Decode 只需要跑 20 轮。
请求 B:输入 20token,需要输出 2000token。 Prefill 工作量极小,首 token 出得很快,但后续要执行数千轮 Decode 循环。
哪怕总 token 数量相近,输入 token 和输出 token 属于不同阶段,负载完全不一样。理解 Prefill 和 Decode 之前,很多人简单把所有 token 看成一类;但在模型服务侧,二者完全不同。
Prefill 与 Decode 负载差异,也给推理引擎带来难题。 想象 GPU 上已经跑了若干 Decode 请求,流畅输出 token。 这时突然来了一条 50000token 超长提示词的新请求。 如果直接让这个超大 Prefill 任务独占 GPU 很久,正在运行的 Decode 请求就会被抢占,token 输出延迟飙升,用户会明显感觉到流式回复卡顿。
这就是推理引擎调度器存在的意义。调度器持续做资源决策:
-
分配多少 GPU 资源跑 Prefill? -
并发运行多少 Decode 请求? -
一次性跑完这条超长提示词吗? -
还是切分成小块分段执行,穿插调度 Decode 任务?
分块 Prefill(chunked prefill)的思路由此诞生:不再一次性跑完超长提示词,拆成多个小块执行,让 Prefill 任务和 Decode 任务更平滑地穿插调度。 这不是凭空的优化手段,根源就是 Prefill、Decode 负载特性不同,两者争抢同一块 GPU 资源。
业界更进一步思考:既然 Prefill 和 Decode 负载差异这么大,是否必须放在同一张 GPU 上运行? 不一定。由此引出 Prefill-Decode 分离部署(prefill-decode disaggregation)。
核心思路:一部分机器 / 显卡专门跑 Prefill,另一部分专门跑 Decode。 请求流程:提示词送入 Prefill 节点 → 处理提示词生成 KV 缓存 → KV 缓存传输到 Decode 节点 → Decode 节点持续输出 token。
架构链路:提示词 → Prefill 计算节点 → KV 缓存传输 → Decode 计算节点 → 输出 token。
这样可以独立扩容两类资源:
-
如果业务大量超长提示词,扩容 Prefill 算力; -
如果业务需要生成长文本回复,扩容 Decode 算力。
当然这种方案也带来新问题:KV 缓存体量巨大,跨机器 / 跨卡传输 KV 缓存对网络要求极高,调度逻辑更复杂,存在很多取舍权衡。但你现在可以理解这个方案的起源:处理已知输入 token,和生成未知输出 token,本质是两种完全不同的计算任务。
回到文章开头,我们重新看整个对话流程: 输入Hi, my name is X.按下回车,大模型并不是直接开始生成。生成之前还有 Prefill 阶段。 文本转为 token,转为嵌入向量,全部提示词 token 送入 Transformer,计算并保存 K、V,存入 KV 缓存。这就是 Prefill。 Prefill 结束,模型预测第一个新 token。任务性质切换。 模型拿到新生成 token,送入 Transformer;读取 KV 缓存访问全部历史上下文;把新 token 的 K、V 追加进缓存,预测下一个 token。循环往复。这个逐 token 生成过程就是 Decode。
一句话记住核心图景:
Prefill = 处理我们已经知道的内容 Decode = 生成我们还不知道的内容
Prefill 阶段完整输入全部就绪,拥有极高并行度; Decode 阶段,单条请求的后续 token 依赖上一步生成结果,天然串行; KV 缓存则处在两个阶段中间,把已经处理完的注意力状态,传递给后续生成过程。
这就是 Prefill 和 Decode。 当我不再死记硬背定义,而是这样理解之后,LLM 推理领域很多其他概念一下子就通顺了。希望你读到这里,觉得有所收获。
术语对照表
表格
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|