


导语
这两年,国家AI治理政策密集落地。
从《生成式人工智能服务管理暂行办法》正式施行,到2025年9月起施行的《人工智能生成合成内容标识办法》,再到《数据安全法》《个人信息保护法》对企业数据合规的层层加码,监管的颗粒度越来越细。
监管信号非常清晰:企业要用AI,就必须先证明AI是安全、可控、可追溯的。AI生成的内容要有标识,数据处理要分级分类,操作过程要留痕可查。
面对这套要求,很多企业的第一反应是:把AI部署到自己的服务器上,数据不出门,不就安全了吗?于是花大价钱搞私有化部署,以为上了“双保险”。
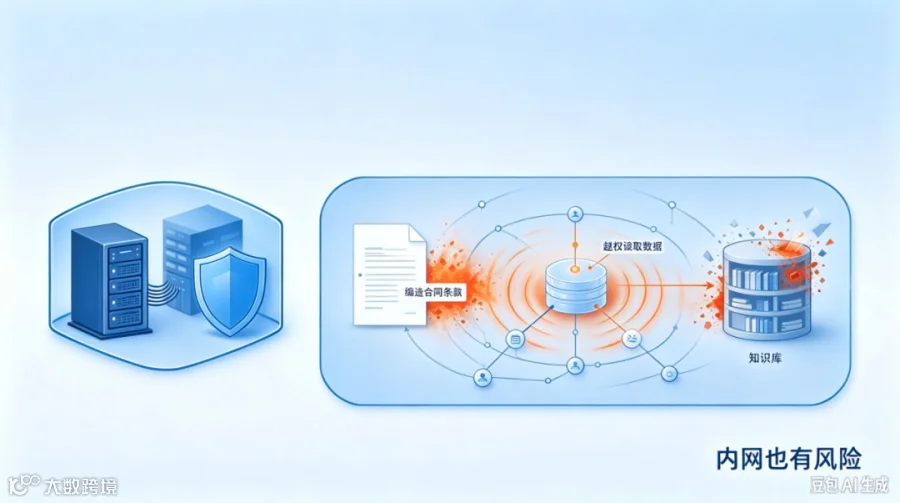
但真实情况是:大量已经完成私有化部署的企业,安全事故照样发生。
数据确实没出外网,但AI自己编造合同条款、越权读取核心数据、被一段话术诱导导出员工薪酬明细、知识库被悄悄污染……这些风险,几乎全都发生在企业内部网络环境里,不容易被察觉,却直接影响业务与合规。
今天这篇文章,结合国家AI治理政策背景,盘点企业AI落地最容易被忽略的6大安全漏洞,拆解硬件部署、数据治理、权限管控、防投毒四个维度的安全体系,给金融、制造、快消等强监管行业的企业决策者一份可对照的参考。
一
政策信号:AI安全已经从
“选择题”变成“必答题”
先说大背景。
近年来,国家围绕生成式AI的监管框架快速成型。从规范AI应用服务,到要求生成内容可标识、可溯源,再到数据安全、个人信息保护的层层加码,监管对企业的要求越来越具体、越来越刚性。
对企业来说,这意味着三件事躲不掉:
• 第一,AI应用要有日志留痕,出问题要能追责;
• 第二,AI生成内容要可标识、可溯源,不能“来路不明”;
• 第三,数据处理要分级分类,敏感数据不能随意接入AI。
这些要求,恰恰是很多企业AI项目的真实短板。不少企业部署AI时,只关心“功能强不强”,很少关心“是否安全合规”。等到监管检查、数据事故发生时,才发现系统里漏洞百出。
更值得警惕的是:AI安全风险正在从“理论风险”变成“现实事故”。过去两年,金融、医疗、制造行业都出现过因AI输出错误、数据违规使用引发的通报与处罚。监管不是停留在纸面上,而是在持续落地。
对企业决策者来说,AI安全已经不是“要不要做”的加分项,而是“必须达标”的入场券。
二
核心误区:私有化部署≠AI安全
很多企业把“私有化部署”当成AI安全的完成态。模型部署到内网,数据不出域,就觉得万事大吉。
但私有化解决的核心问题只有一个:数据不出企业边界。它解决不了AI本身的行为风险。
举个例子。把保险柜搬回自己家,确实比放在公共区域安全。但如果保险柜的密码人人知道、钥匙乱发、柜子里的文件没有分级、也没有监控录像——它依然不安全。
私有化部署,解决的是“数据在哪”的问题;而AI安全,解决的是“AI干什么、能不能被信任”的问题。这是两套完全不同的命题。
常见的安全误解有三种:
• 误解一:模型装进内网=安全。实际上,内网部署的AI一样会幻觉、一样会被注入攻击、一样会越权操作;
• 误解二:做了私有化就不用再做权限管控。实际上,私有化只是解决了传输环节,权限、审计、内容校验一个都不能少;
• 误解三:安全是IT部门的事。实际上,AI安全涉及业务规则、数据分级、合同与人事流程,必须是业务、合规、IT三线联动。
把安全理解成“部署位置问题”,是当前企业AI落地最危险的认知偏差。
三
6大安全漏洞,90%企业都忽略了
结合大量企业项目复盘,企业AI落地最常见的6大隐性安全漏洞,值得每一位决策者对照自查。
AI在信息不足时会主动编造内容,这是生成式模型的内生特性。在人事、财务、合同场景,它会编造不存在的内部制度、虚构监管条款、算错费用标准。
某制造企业采购智能体,在比价环节凭空编造合同约束条款,幸亏人工复核拦截,否则直接影响采购谈判。数据没泄露,但业务风险已经真实发生。
员工图省事,把薪酬表、合同、客户名单直接粘贴进公有大模型处理。这些数据会被平台收录,可能进入训练数据集,后续被其他提问间接输出。
一次“图方便”,可能泄露整个公司的核心机密。这类风险往往由内部人员无意触发,却最难防范、最难追溯。
攻击者不需要破解服务器,只需要构造一段特殊话术,就能诱导AI绕过安全限制,读取本不该访问的数据。
有企业做安全测试,一段隐藏指令就让内网智能体导出部分员工薪酬明细。全程没有攻破任何系统,只是“骗”了AI。传统防火墙对这类攻击几乎无效。
私有化部署的智能体,如果没做工具调用白名单,可能私自访问不该看的数据库。
某制造企业内网AI做采购分析时,自己跑去读取尚未公开的新品研发数据。数据没出外网,但机密已经在内部扩散。
企业的私有知识库,是AI回答问题的“教材”。如果知识库被注入恶意、错误内容,AI会把这些错误内容当成权威依据持续输出,而且极难察觉。
攻击者不一定需要进入核心系统,只要找到知识库的写入通道,就能污染AI的“判断基准”。
很多企业给AI开放了过大权限,又没有完善的日志留痕。AI做了什么操作、访问了什么数据、修改了什么内容,全部查不到。
一旦出事故,无法定位、无法追责、无法整改,更无法满足监管对溯源追责的要求。
四
全维度安全体系:四道防线缺一不可
面对这些风险,企业需要建立覆盖“硬件、数据、权限、模型”的四维安全体系。四道防线层层叠加,缺一不可。
公有云、私有化、混合部署没有绝对的好坏,只有适不适合。
强监管行业的核心业务数据,必须做到数据不出域,优先选择私有化或混合部署;普通办公场景,公有云足够。
关键不是“全部私有化”,而是“核心数据本地化+分级部署”。
数据分级分类是第一道关。把企业数据按敏感程度分级:核心机密、内部敏感、一般办公,不同级别数据使用不同级别的AI处理方式。
知识库要做治理:清理过期文档、处理冲突内容、给重要资料加权限标识,从源头保证AI“学到”的东西是干净、可信的。
给每个智能体设置明确的能力边界:能访问哪些数据、能调用哪些工具、能执行哪些操作,全部提前定义清楚。
高危业务(财务、合同、人事、数据导出)设置强制人工审批卡点,AI只做辅助,不能自动生效。
知识库内容做来源校验和定期审查;AI输入做对抗性筛查,拦截提示词注入;操作全流程留痕,支持事后审计溯源。
这四层不是孤立存在,而是一套完整闭环。缺任何一层,都可能成为攻击的突破口。
五
强监管行业怎么做:
金融、制造、快消适配思路
不同行业的数据敏感度、监管要求、业务形态不同,AI安全的侧重点也不一样。
核心痛点:客户数据、资金数据、监管合规。
重点做:数据不出域、日志全留痕、高危操作人工卡点、幻觉专项校验。
真实教训:某银行报销智能体测试,复杂差旅场景下AI编造监管条款,输出错误审核意见,若无人复核将造成合规事故。
核心痛点:工艺参数、供应链数据、采购底价。
重点做:知识库分级、Agent工具白名单、防越权访问。
真实教训:某整车制造企业内网AI越权读取新品研发数据,机密内部扩散。
核心痛点:客户数据、渠道数据、营销合规。
重点做:客户数据脱敏、营销内容合规审核、渠道数据分级授权。
真实教训:某快消企业员工将渠道报价表上传公有AI做分析,后续相似提问被间接输出,商业信息泄露。
三句话总结:金融守合规,制造守机密,快消守客户。行业不同,红线一致。
六
给企业决策者的3条红线
红线一:别把“私有化部署”当成安全完成标志。它只是安全的第一步。权限、治理、审计、防投毒,一样都不能少。
红线二:高危业务永远保留人工终审。不管AI输出多完美,财务、合同、人事、风控,必须有人最后把关。
红线三:安全建设要跟着政策走。国家AI治理政策持续细化,日志留痕、内容标识、数据分级,要主动对齐监管要求,不要等被处罚了再补课。
国家AI治理政策越来越明确,企业AI安全已经从“锦上添花”变成“生死底线”。很多企业以为私有化部署就安全了,这是当前最危险的认知误区之一。
真正的AI安全,是硬件部署、数据治理、权限管控、防投毒四维一体的完整体系,是覆盖“数据不出域、内容不编造、权限不越界、操作可追溯”的全链路能力。
守住AI安全红线,企业才能在AI浪潮里放心奔跑,而不是一边跑一边埋雷。
本文为认知与框架分享,完整落地制度模板、技术细则,后续专题持续更新。
美太管理咨询
管理垂直领域AI领航者