


Googlebot 仅遵循特定指令,忽略表单和 Cookie,并且只抓取编码正确的链接。因此,网站构建中的错误和疏忽会影响其被抓取和索引的能力。
人们常误以为人类在网站上看到的内容都能被搜索引擎访问,但事实并非如此。
尽管 Googlebot 理论上可填写表单、接受 Cookie 并抓取各类链接,但这会消耗大量抓取与索引资源。因此,它仅遵循特定指令,忽略表单和 Cookie,且只抓取包含正确锚标签及 href 编码的链接。
以下是七种阻碍 Googlebot 及其他搜索引擎机器人抓取和索引网页的因素:
1. 基于地理位置的页面
具有本地自适应功能的网站会根据访客 IP 地址显示内容,但这并不精准。例如,访客实际住在纽约,IP 却显示为波士顿,导致收到错误的本地内容。
由于 Googlebot 的默认 IP 位于加利福尼亚州圣何塞地区,它只能看到与该区域相关的内容。
首次访问时基于地理位置展示内容尚可接受,但后续内容应基于用户点击的链接而非 IP 地址加载。这种阻碍自然搜索成功的隐形障碍往往最难被发现。
2. 基于 Cookie 的内容
网站通过 Cookie 个性化用户体验(如语言偏好或面包屑导航路径)。若内容仅因 Cookie 存在而显示,而非通过点击链接触发,搜索引擎机器人将无法访问。
例如,部分网站根据 Cookie 提供多语言内容。当用户在英语在线商店切换至法语模式后,URL 保持不变但内容已变。虽然站长希望法语内容获得排名以吸引目标用户,但由于 URL 未随内容变化,搜索引擎无法抓取或索引其他语言版本。
3. 不可抓取的 JavaScript 链接
对 Google 而言,有效链接必须同时包含锚标签和指向特定 URL 的 href。此外,使用锚文本有助于确立被链接页面的相关性。
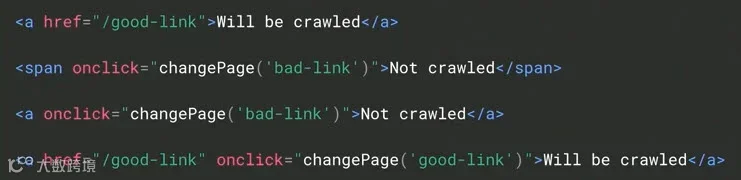
Google 要求链接必须同时包含锚标签和指向特定 URL 的 href。在此示例中,Googlebot 将抓取第一行和第四行,但不会抓取第二行和第三行。
电商网站常使用 onclick(如鼠标悬停下拉菜单)替代标准锚标签编码链接。这种方式虽对人类用户友好,但 Googlebot 不将其识别为可抓取链接,可能导致相关页面出现索引问题。
4. 哈希符号 URL
AJAX 技术可在不刷新整个页面的情况下更新内容,并在 URL 中插入哈希符号(#)。然而,哈希符号在后续访问时未必能正确重现预期内容。若搜索引擎索引了带哈希符号的 URL,用户搜索结果可能与实际需求不符。
尽管 SEO 专家普遍了解哈希符号 URL 的索引缺陷,但营销人员仍常惊讶于这一基础 URL 结构问题竟会导致自然搜索排名异常。
5. Robots.txt 禁止规则
robots.txt 是位于网站根目录的文本文件,通过 disallow 命令告知合规机器人哪些内容不应抓取。
Disallow 指令虽不能直接阻止索引,但因机器人无法确定页面相关性,可能导致排名下降。
该指令可能在网站改版上线时被意外添加,从而阻止机器人抓取全站。若有机搜索流量突然下滑,检查 robots.txt 文件中是否存在 disallow 应是首要排查步骤。
6. Meta Robots 不索引
URL 元标签中的 noindex 属性指示搜索引擎不要索引该页面。与通过单一文件管理全站的 disallow 不同,noindex 是逐页应用的。
Noindex 比 disallow 更彻底,因为它会直接终止索引过程。
与 disallow 类似,noindex 也可能被意外推送上线,成为极难察觉的阻碍因素。
7. 错误的规范标签
规范标签用于从多个相似版本中指定应索引的页面,是防止重复内容的关键工具。所有非规范页面会将链接权重传递给规范 URL,自身则不会被索引。
由于规范标签隐藏在源代码中,错误往往难以察觉。若期望被索引的页面未被收录,很可能是规范标签配置有误所致。