

一段第一视角视频可以告诉模型:手拿起了杯子。
但什么时候真正接触?握力是否足够?杯子即将滑落时,下一步该做什么?这些问题,单靠视觉仍难可靠回答。
2026 年的研究正在给出更清晰的方向:触觉不仅用于机器人执行时的反馈,也开始进入世界模型的训练、未来状态预测,以及人类操作向机器人技能迁移的全过程。
01|让世界模型“看到”接触之外的变化

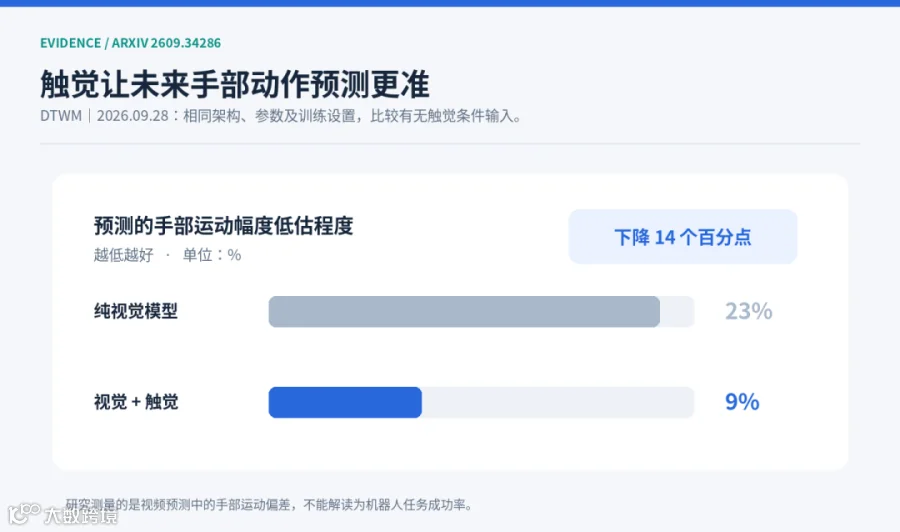
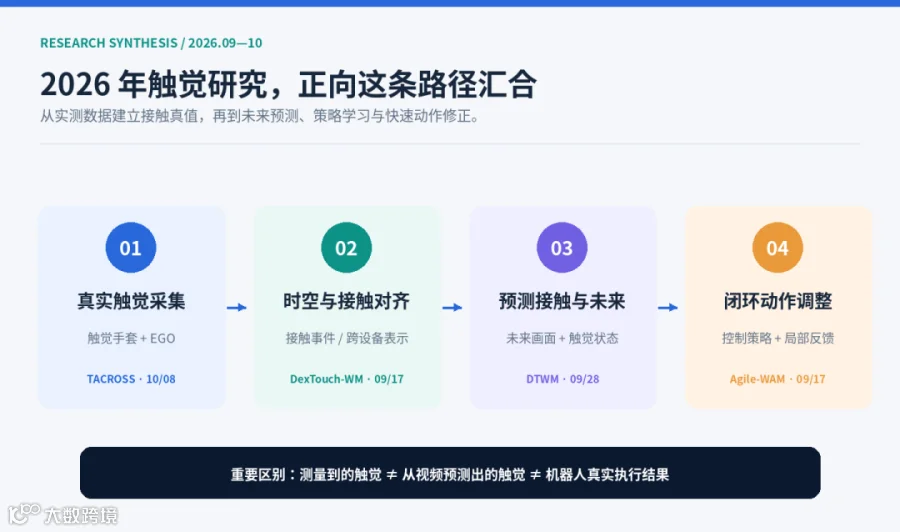
9 月 28 日的 DTWM,把双手触觉手套信号与第一视角视频按手的位置对齐,预测后续画面。与匹配的纯视觉模型相比,预测时对手部运动幅度的低估从23% 降至 9%;对触觉做消融还发现,接触在哪里、压力多大,比一个简单的“碰到/没碰到”标签更有信息量。[1]
这里证明的是视频世界模型的预测能力改善,不是机器人任务成功率直接翻倍。
02|人类触觉数据,正在变成模型的训练资源
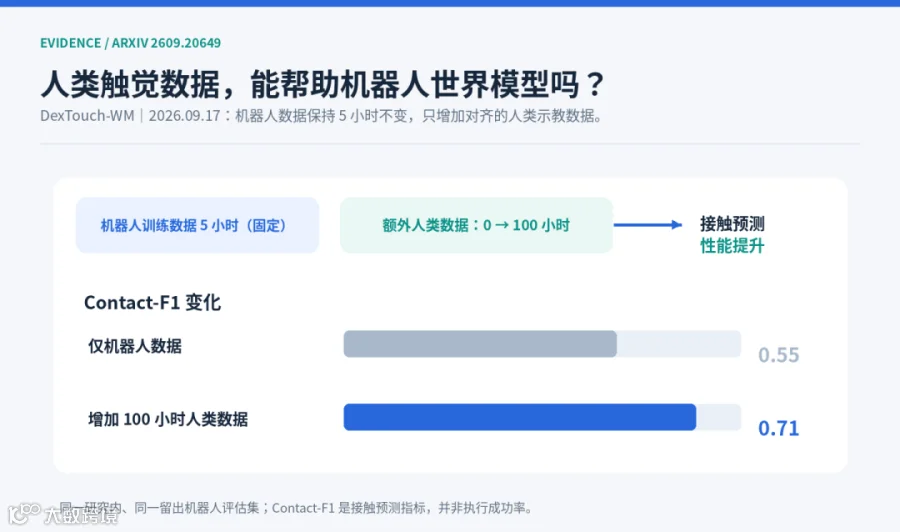
9 月的 DexTouch-WM:在机器人数据始终只有5 小时的条件下,引入100 小时经过动作与传感器对齐的人类触觉示教,留出机器人测试集上的Contact-F1 从 0.55 提升至 0.71。[2]
同月的TouchSight更进一步:利用500 小时压力手套记录训练模型,尝试从第一视角视频估计全手接触力。[3] 这意味着未来部分无手套视频或许可被补充估计的触觉标签;但预测标签不等于真实测量,训练初期仍需要可信的实测触觉数据。
03|从预测世界,到及时修正动作
9 月的 Agile-WAM将视觉与触觉放到不同预测时间尺度中:视觉关注较长时距变化,触觉关注接触瞬间。在其5 项真实机器人任务中,论文报告整体成功率相对最强基线提升29.4%,模型推理延迟为11.9 ms。[4]
10 月 8 日的 TACROSS则提醒行业另一件事:不同触觉手套与机器人传感器不能简单按原始通道数值一一对应。更有意义的是对齐接触事件和共享表征;在其采集实验设置下,人类示教的最高记录速率约为传统机器人遥操作的3.5 倍。[5]
04|对具身数据基础设施意味着什么?
我们认为,下一代有价值的操作数据,不只要知道手怎么动,还应尽量知道哪里发生接触、压力如何变化、动作如何修正。
对于AWEAR 多模态手套与 EGO 第一视角采集系统,方向也因此更加清晰:把手部运动、可测的触觉/压力信号和视频放在统一时间轴上,记录可用于训练与验证的真实物理交互过程。
但这需要严格解决传感器标定、接触事件定义、时空同步、跨手型映射等工程问题。压力值不能未经标定就宣称为精确三维力,人类示教也不会自动变成机器人动作。
视频帮助模型学习世界的外观,触觉则为学习真实接触补上关键证据。
参考文献(按正文引用顺序)
[1] Zeng et al.Dexterous Tactile World Model, 2026-09-28.https://arxiv.org/abs/2609.34286
[2] Qin et al.DexTouch-WM: Learning Action-Conditioned Tactile World Models from Human Touch for Dexterous Robot Manipulation, 2026-09-17.https://arxiv.org/abs/2609.20649
[3] Zhou et al.TouchSight: Bare-Handed Tactile Prediction from Egocentric Video via Generative Visual Augmentation, 2026-09-17.https://arxiv.org/abs/2609.20414
[4] Zhou et al.Agile-WAM: An Agile Tactile World Action Model for Contact-Rich Robot Control, 2026-09-17.https://arxiv.org/abs/2609.20761
[5] Chen et al.TACROSS: An Efficient and Low-Cost Scalable Human Touch System Across Heterogeneous Tactile Sensors for Dexterous Robot Learning, 2026-10-08.https://arxiv.org/abs/2610.11945
注:上文的数字均为论文报告的特定实验结果,不同论文的指标和任务设置不可直接横向比较。
注 芯动力AI,我们会继续分享 大模型、Agent 和具身智能等方面的相关信息。