

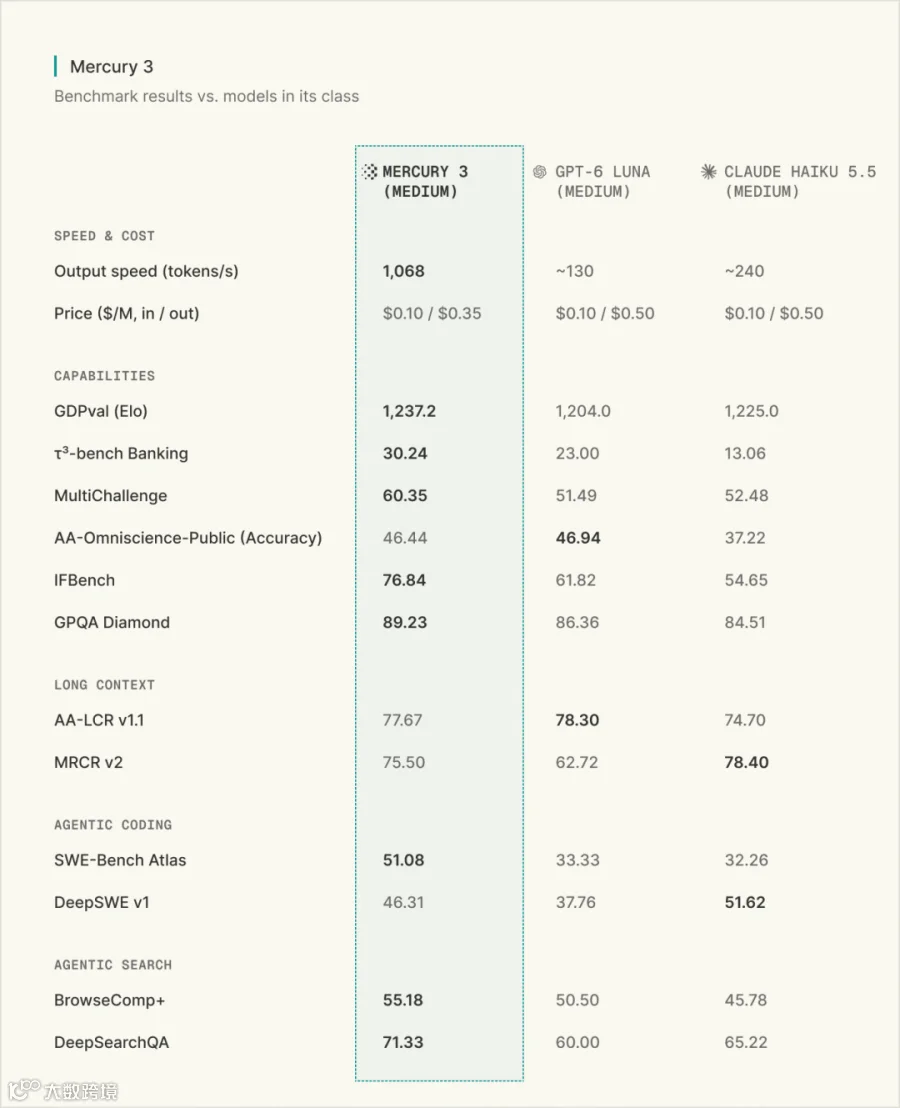
10月19日,AI公司Inception发布了新一代扩散语言模型Mercury 3。按照官方公布的数据,它在NVIDIA GPU上的生成速度达到每秒1068 Token,拥有100万Token上下文,首发期间每百万输入Token只收0.10美元、每百万输出Token收0.35美元。
Inception还宣称,相比GPT-6 Luna、Claude Haiku 5.5等注重速度的模型,Mercury 3快了4至8倍。
数字相当抢眼。但比速度和价格更值得关注的是,它不再完全依赖传统语言模型逐个Token向后生成的方式,而是利用扩散技术,并行生成和修订文本。
问题来了:每秒1068 Token,实际用起来真有这么快吗?扩散语言模型,究竟能给现有的AI应用带来什么变化?
01|不再逐字生成,扩散语言模型是怎么工作的?
我们熟悉的多数大语言模型,采用自回归生成方式。简单理解,就是根据已经写出的内容预测下一个Token,再把它接到后面,继续预测下一个。
这种方式效果已经得到广泛验证,但有一个明显特点:生成过程具有顺序依赖。特别是回答很长时,即便硬件很强,也要经历许多轮连续生成。
Mercury走的是另一条路。

它采用扩散语言模型路线:不是简单地从左到右把整段文字一个个写完,而是对一批文本位置进行并行生成,再经过多轮细化,逐步形成结果。
可以把两者理解为两种写稿方式:一种是从第一句话写到最后一句;另一种先生成一部分草稿,再同时修改其中多个位置。这个比喻并不等于模型的精确计算过程,但能解释扩散路线为什么有机会提高生成吞吐。
当然,并行不意味着一整篇文章一次计算就能完成。模型仍然需要反复处理和修订,速度与质量之间也存在取舍。
值得注意的是,Mercury 3虽然改变了底层生成方式,却没有要求用户完全改变使用习惯。它依旧支持聊天中常见的流式返回:一段内容处理好就先发出来,用户不必一直等到全文结束。开发者也可以开启额外的扩散展示模式,看到中间文本如何被逐步修订。
这次发布还有一个容易被速度数字掩盖的变化。
Inception称,Mercury 3的总参数规模已经超过第一代Mercury的40倍,但生成速度依然与第一代处于相近水平。 公司还称,模型能力在其选定的一组基准测试上明显提高。
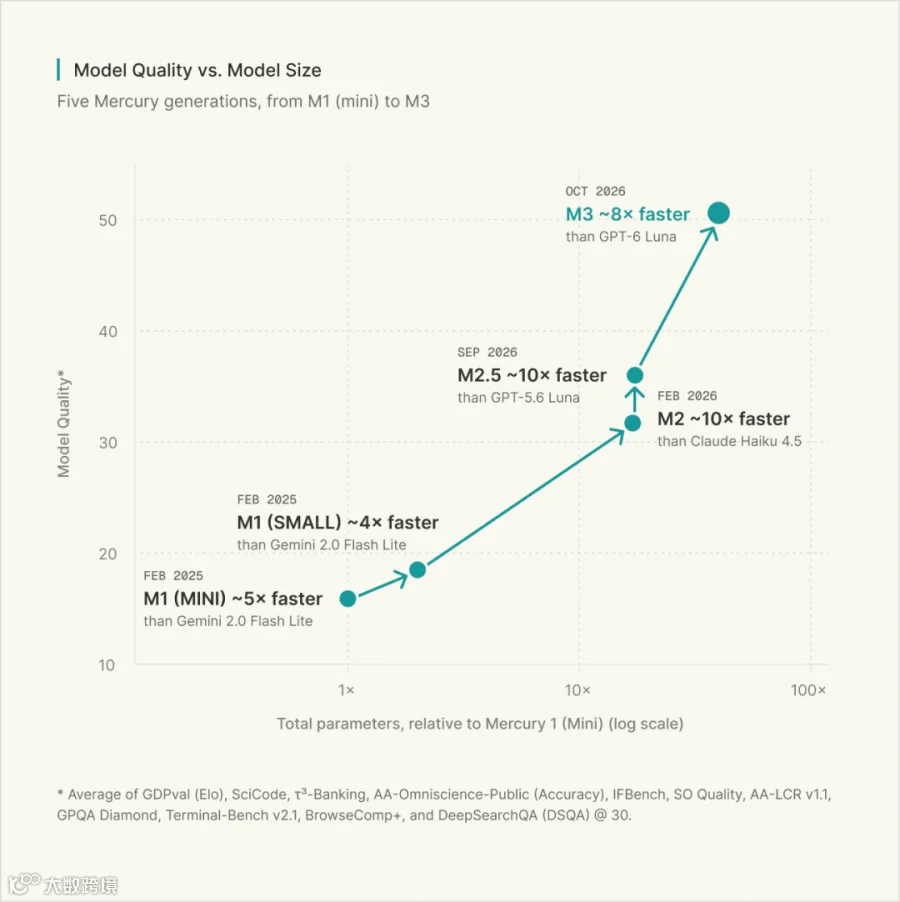
这意味着,扩散语言模型不只是试图解决“写得快”,还在尝试回答另一个问题:模型规模变大之后,能否在提高能力的同时,仍然保持高速生成?
这是Mercury 3真正值得关注的技术看点。不过,参数规模、质量提升和速度保持的对照目前主要来自厂商披露,仍需要更多公开、可复现的评测验证。
02|每秒1068 Token,实际使用到底有多快?
官方给出的1068 Token/秒,是Mercury 3在特定NVIDIA GPU条件下的生成速度,并不意味着所有用户、所有任务都能达到这个数字。
10月19日,技术博客explainx.ai曾记录OpenRouter上Mercury 3单一服务端点的早期数据:中位吞吐约254 Token/秒,中位延迟约1.91秒。
1068和254看起来差距很大,但不能直接拿来判断谁对谁错。
前者是厂商公布的性能指标;后者是第三方文章在当时观察到的聚合平台数据,受到服务端点、请求组成、实际负载及统计方式等因素影响。它既不是与官方同条件的复测,也不代表模型此后一直保持这个水平。
真正需要区分的,其实是三个指标:每秒生成多少Token、多久开始返回内容,以及整个任务多久完成。
比如让一个AI Agent上网查资料。它可能先思考,再打开网页、等待加载、提取信息,最后才生成答案。即使最后一步写得飞快,前面的网络和工具等待也不会自动消失。
假设一项任务原来需要10秒生成文字,另外30秒都花在工具调用和等待上,合计40秒。就算文字生成部分提速8倍,整个任务也只会降到31.25秒,而不是5秒。
这是一个假设算例,不是Mercury 3的实测结果,却说明了为什么“模型快8倍”和“工作效率高8倍”完全不是一回事。
另一方面,如果某个应用要连续调用模型很多次,比如实时搜索、交互教学或浏览器Agent,单次响应缩短带来的收益就可能不断累积。
因此,比单看1068更重要的,是模型在真实工作负载里能节省多少等待时间。
03|百万上下文,首发价格到底有多低?
除了速度,Mercury 3的价格也颇有竞争力。
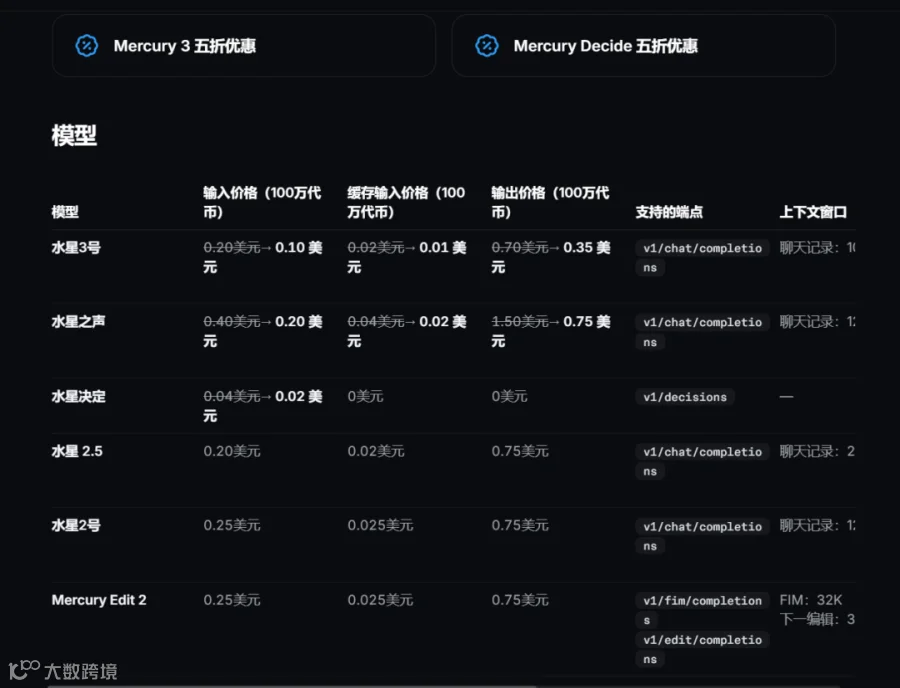
根据10月20日的官方模型文档,它的收费分成三档:
-
普通输入:首发每百万Token 0.10美元,常规价格0.20美元; -
缓存输入:首发每百万Token 0.01美元,常规价格0.02美元; -
输出:首发每百万Token 0.35美元,常规价格0.70美元。
简单算一笔账:一次或多次调用累计消耗100万普通输入Token、100万输出Token,不考虑缓存及其他费用,按首发价格合计0.45美元;按常规刊例则是0.90美元。
需要强调的是,这属于首发五折优惠,官方尚未在模型价格页明确写出优惠结束日期,不能把它当成永久价格。 缓存输入也必须实际符合缓存计费条件,不能只因为材料以前发过,就默认按缓存价收费。
Mercury 3的上下文窗口也从上一代Mercury 2.5的26万Token,扩大至100万Token,最大输出上限为131072 Token。
上下文变大,意味着模型可以在单次请求中容纳更多代码、文档和对话历史,但不是一次就能输出100万Token。更大的窗口也不保证模型一定能准确找到长材料中的每一处关键信息。
对于经常处理长资料的Agent来说,低输入价格和大上下文窗口是一种很有吸引力的组合。但最终账单仍取决于调用次数、真实Token用量、缓存命中和失败重试情况。模型便宜,不等于做完一项工作就一定便宜。
04|速度快了,Agent就一定更好用吗?
Mercury 3支持工具调用和JSON结构化输出,可以接入现有的聊天与Agent应用。开发者仍然需要负责执行工具、验证参数和管理任务状态,模型不会因为能生成工具调用请求,就自动完成网页操作或数据库修改。
它还提供instant、low、medium、high四档推理设置。这里有个容易忽略的细节:Mercury 3默认使用low,而Mercury 2.5默认使用medium。
这意味着,如果开发者只是把旧模型替换成新模型,却没有显式设置推理档位,得到的速度变化可能既来自模型本身,也来自不同的默认推理预算。要判断是否真正进步,最好在相同任务、相近设置和一致的验收标准下测试。
官方发布时,还展示了几项合作方的早期应用结果。
比如智能眼镜搜索服务商Octen称,在其测试中,Mercury 3的中位模型生成时间为0.9秒,端到端响应时间为2.2秒。前者反映模型生成环节,后者则更接近用户实际等待一次答案的时间。
另一家合作方TinyFish称,在50个实时网页导航任务中,Mercury 3完成了其中50%的任务,并在该测试环境中优于它比较的部分前沿模型。
这两组数字都有参考价值,但也都需要看清范围:它们是合作方在各自任务环境中的测试结果,不是对所有Agent的通用性能承诺。尤其是50%的完成率,既说明模型具有一定能力,也意味着仍有一半任务没有完成。
对于真实应用来说,回答快只是第一步,结果是否正确、工具是否用对、失败后要重试多少次,同样重要。
05|Mercury 3适合用在哪里?
从目前公开的信息看,Mercury 3最值得尝试的不是所有AI任务,而是那些需要频繁生成内容、反复调用模型,并且对等待时间比较敏感的场景。
比如,搜索助手需要快速读完材料并给出总结;编程Agent需要在多个步骤中生成或修改代码;实时辅导应用需要尽快回应用户;浏览器Agent则可能在一个任务里接连做出多次判断。
在这些环节中,模型生成速度确实可能影响整项工作的节奏。
但对于特别复杂的推理、长链条任务或者准确率要求很高的业务,不能仅凭速度和价格就认定它一定优于其他模型。应该拿自己的任务来测试:同样的输入、同样的推理设置、同样的工具和质量标准,比较首次响应时间、任务完成时间、成功率和每个成功任务的成本。
目前,Mercury 3可以通过Inception官方API,以及OpenRouter、Baseten、Vercel等渠道接入。普通用户也可以从Mercury Chat官方体验入口直接尝试;开发者则可以查看Inception API平台和模型文档。
从这次发布来看,Mercury 3最重要的意义,不只是把生成速度推到每秒上千Token,而是让扩散语言模型在规模扩大之后,依然展示出高速生成的潜力。
不过,速度不等于能力,低单价也不等于低任务成本。 厂商的性能宣称、第三方早期观察和合作方案例,都还需要更多独立测试补充。
当AI开始越来越多地替人操作工具、处理资料和完成连续任务时,市场最终比较的,恐怕不只是模型一秒能写多少字,而是它能不能用更短时间、更低成本,把一件事真正做对。
这才是Mercury 3接下来需要证明的价值。
参考来源
-
Inception:Diffusion at Scale: Introducing Mercury 3(2026年10月19日) -
Inception官方模型规格与价格 -
Inception:Streaming & Diffusion -
Inception:Reasoning Efforts -
explainx.ai:Mercury 3厂商指标与早期平台数据比较(2026年10月19日) -
OpenRouter:Mercury 3模型信息