

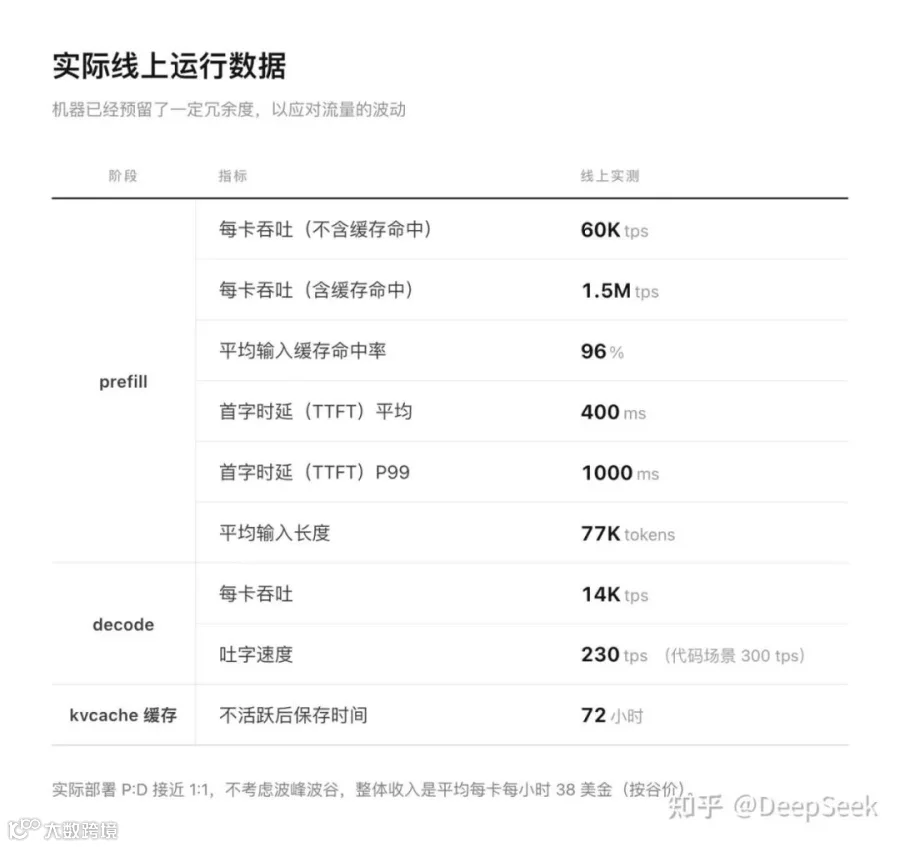
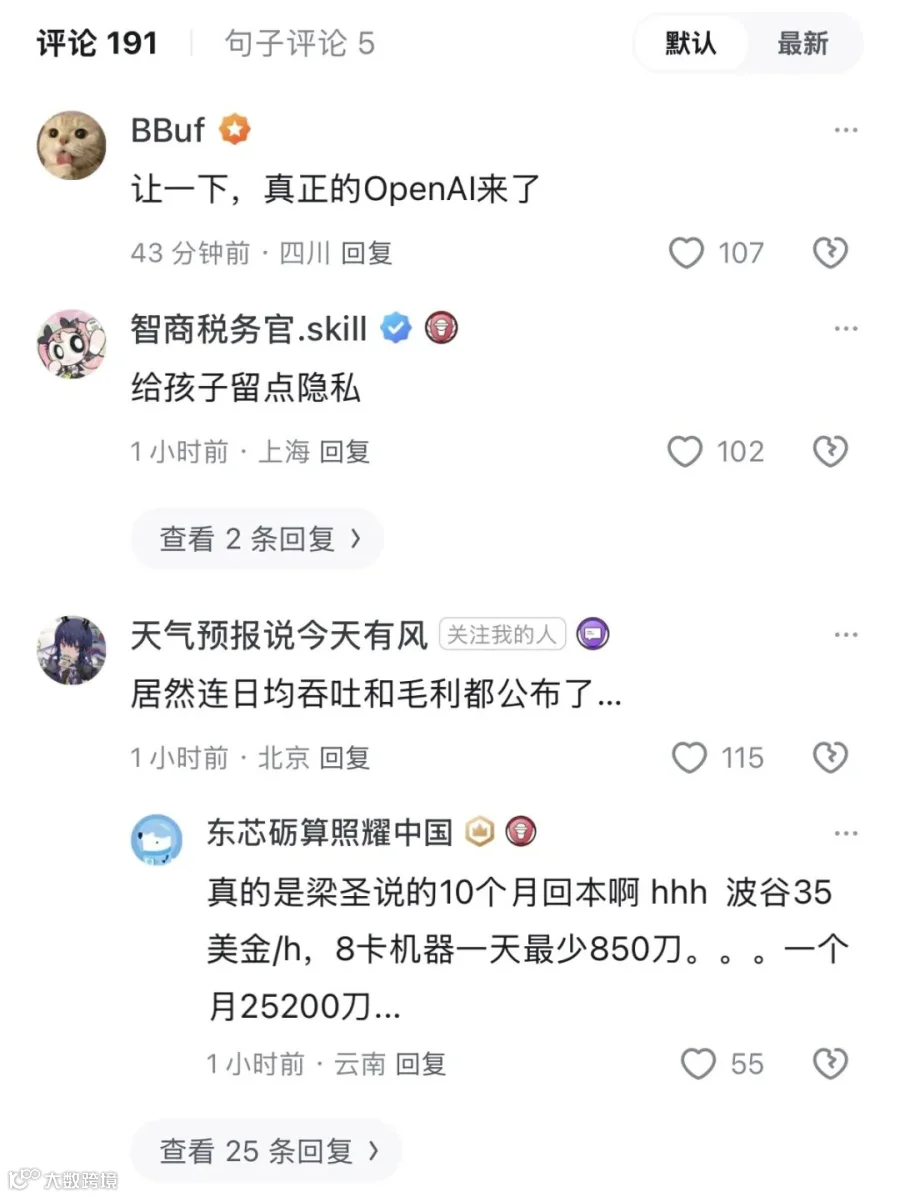
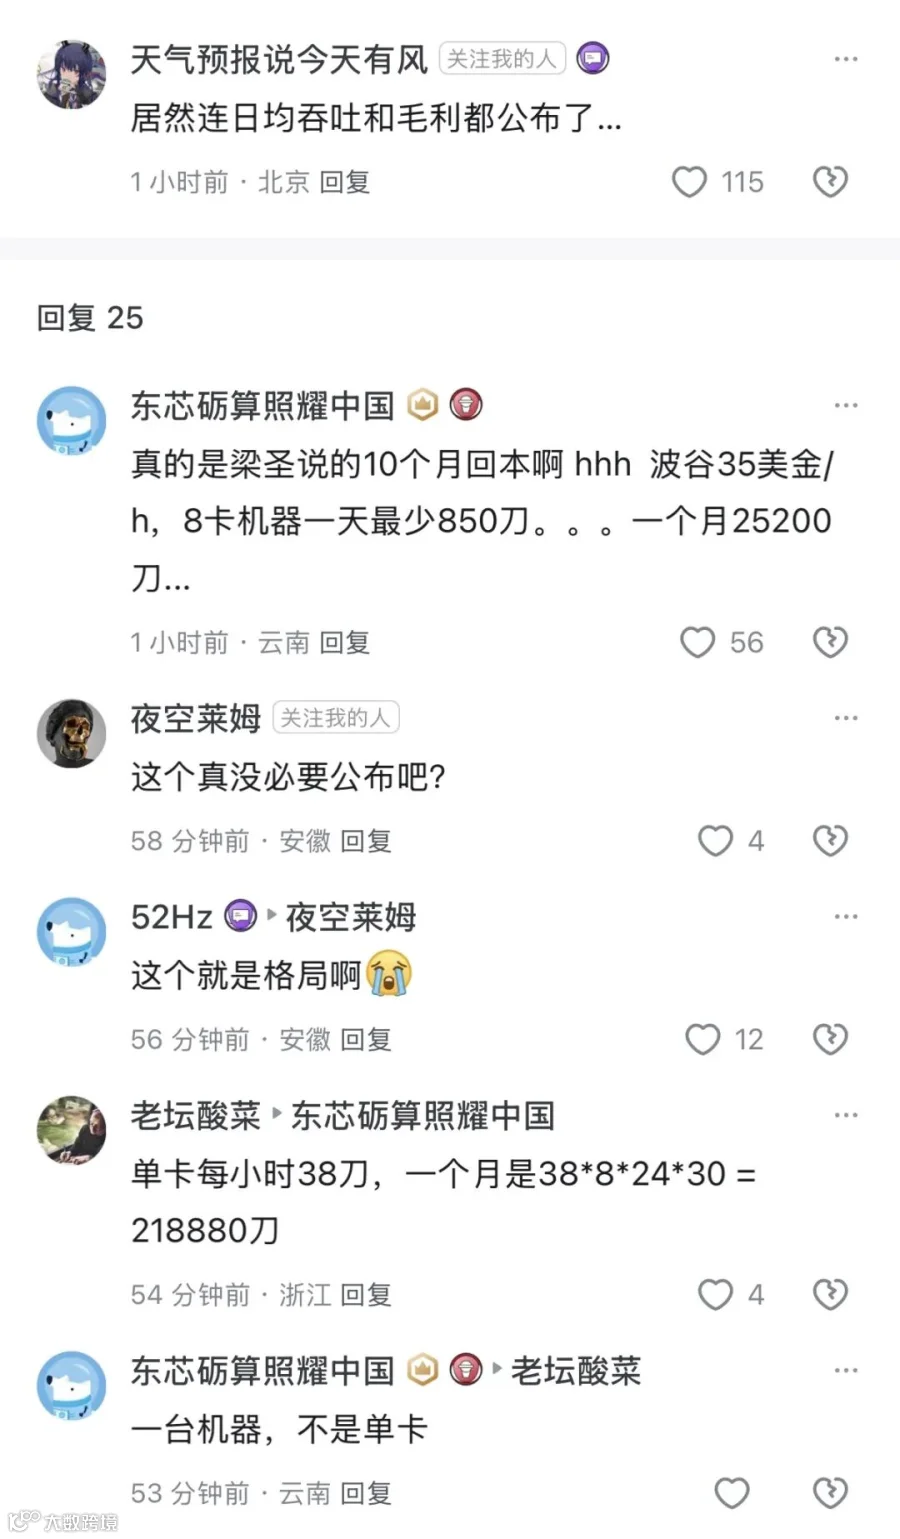
目前单一集群的服务吞吐是 155 万亿 Tokens/天,整体收入是每卡每小时 38 美金(按谷价)
刚才,DeepSeek 正式开源大规模云服务推理框架 DeepInfer。
并且在知乎上发布了技术报告《DeepSeek V4.1 Flash 大规模推理部署实践》。
不但手把手教学背后的技术方案,还公布了开头这组数据。
让社区里的大家直呼这才是真正的开源精神。
把赚钱的账本晒出来了,这下不得不读了:
@DeepSeek
《DeepSeek V4.1 Flash 大规模推理部署实践》10.20发布于知乎
大模型的能力边界由模型本身划定,而如何让这些能力以合理的成本服务海量用户,则是推理框架要解决的核心问题。
面对大规模的 AI 调用需求,推理框架已经从单机服务程序演变为跨集群协同的复杂系统。算子、通信、调度与缓存管理相互影响,共同决定端到端性能。对于大规模在线服务,性能优化需要落实到具体的部署条件中:使用什么芯片、如何组织硬件、如何分配计算,以及如何复用已有的计算结果。
DeepSeek V4.1 Flash 推理系统从设计之初,就确立了三个目标:
兼容多种厂商的计算芯片:支持在不同硬件平台上部署,并充分发挥各平台的性能。
基于常见硬件组织 Prefill 和 Decode:用常见的 8 卡机器做 Prefill,用常见的 64~128 卡超节点做 Decode,围绕两个阶段的负载特征设计计算、通信与调度。
支持将 KVCache 保留 72 小时以上:为上下文复用提供更长的时间窗口,在缓存命中时减少重复的 Prefill 计算,并将长时间保留缓存所需的容量与管理开销纳入系统设计。
围绕这些目标,我们持续优化计算、通信、调度与存储,在满足延迟要求的前提下提高系统的有效吞吐,用更少的算力与能源支撑更多请求,让智能服务以更低的价格触达更多用户。
此前,我们已开源用于开发高性能算子的 TileLang 以及一系列推理算子库。今天,我们正式开源大规模云服务推理框架 DeepInfer。 基于这一框架,我们已实现 DeepSeek V4.1 Flash 的高吞吐、低延迟大规模推理服务。目前单一集群的服务吞吐是 155 万亿 Tokens/天,整体收入是每卡每小时 38 美金(按谷价)。
DeepInfer 集成了高性能算子和深度优化的推理引擎,支持分布式推理、推测解码、SWA Bounded Replay、结构化输出等能力,可在英伟达与华为昇腾平台上运行。同时,我们还开源了生产级 Token 编解码组件 deepseek-recipe,支持主流大模型 API 协议与模型 Tokens 之间高效、准确的编解码,处理逻辑与 DeepSeek 官方 API 完整对齐,以确保第三方部署能获得与官方部署一致的 API 体验。未来,DeepSeek 新模型的推理代码及后续性能优化也将在 DeepInfer 中持续开源。
推理系统中的 KVCache 管理与负载均衡组件因与内部基础设施耦合较深,相关代码目前尚未完整开源。本文将从上述设计目标出发,介绍 DeepSeek V4.1 Flash 推理系统的整体架构与关键实现,以及这两部分的设计细节。
推理系统设计概览
DeepSeek V4.1 Flash 推理系统的优化目标是:更大的吞吐,更低的延迟。
为了实现吞吐和延迟的两个目标,我们使用:
(超)节点内 MoE 部分专家并行(EP):增大 batch size,提高 GPU 矩阵乘法效率,从而提高吞吐。
Vision Encoder / Prefill / Decode 分离部署:解耦各阶段资源分配,独立控制并分别优化 TTFT 和 TBT。
继承 DeepSeek-V3 / R1 推理系统,ATTN 部分使用数据并行 DP (#DP=#EP),不同的 DP / EP 之间需要进行负载均衡,为此我们开发了 Prefill Load Balancer、Decode Load Balancer、Vision Encoder Load Balancer、Expert-Parallel Load Balancer;为了节省重复 Prefill 的成本,我们开发了 KVCache Storage。
在用户请求进入推理前后,需要进行 API 协议与 token 序列之间的转换,DeepSeek Recipe 支持主流大模型 API 协议与模型 token 序列之间高效、准确的编解码,通过 special token 分段和并行的策略,避免 special token 注入的同时,降低长文本 tokenize 的处理时延。
可参考以下架构示意图:
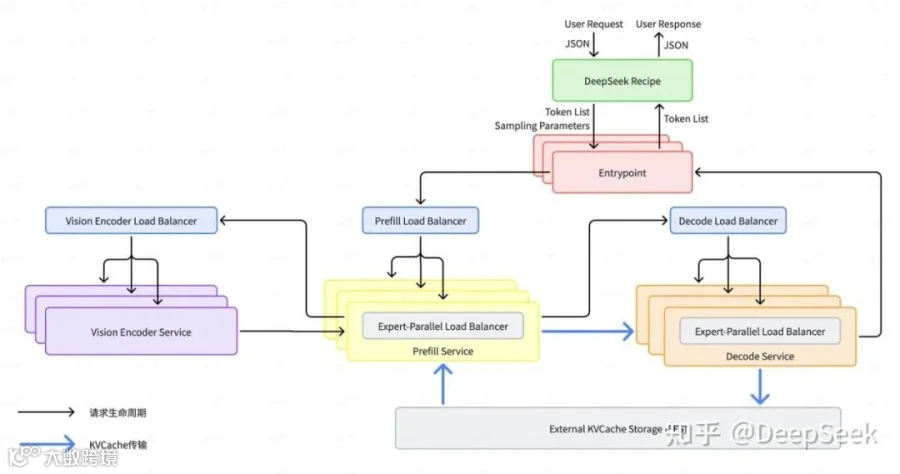
并行策略:
Prefill: EP2~8/DP2~8; 在显存足够的情况下用尽可能小的 EP/DP
Decode: EP64~128/DP64~128 (Wide-EP); 在显卡可用的情况下用尽可能大的 EP/DP
Vision Encoder: 一般单卡部署就可以,建议用可用范围内最便宜的卡部署。
DeepSeek-V4.1-Flash 线上系统的实际统计数据
离线性能基准测试数据
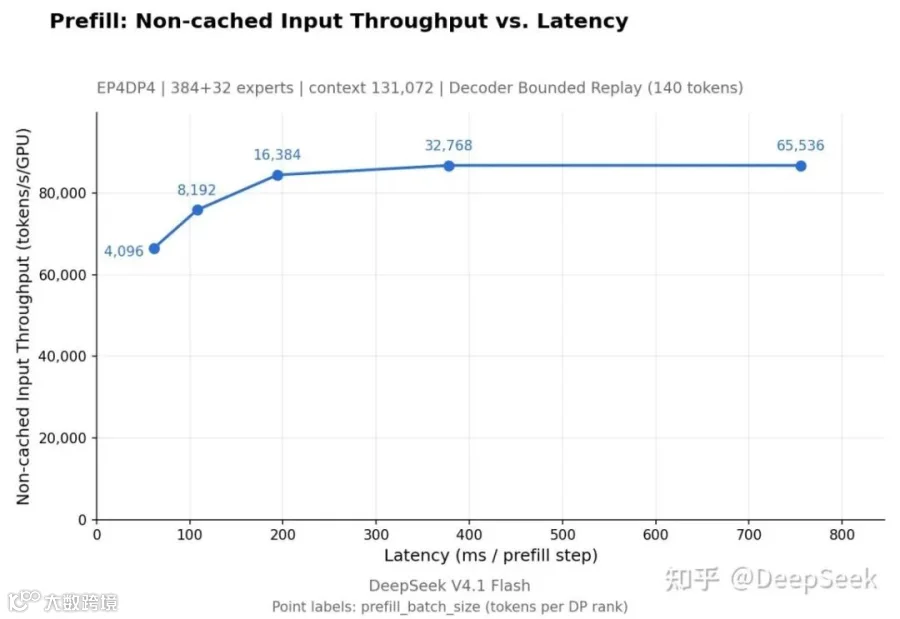
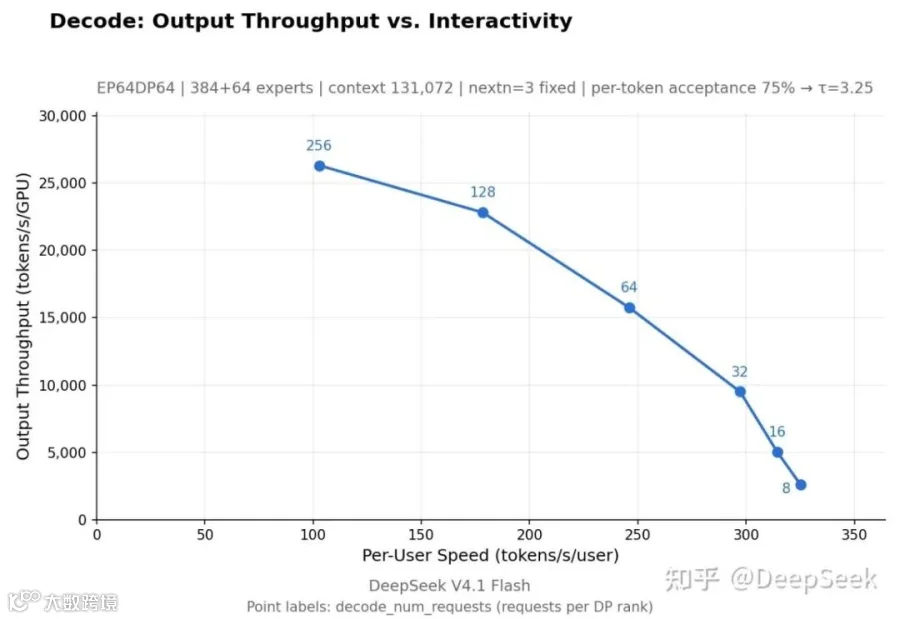
DeepSeek Recipe
API 多协议适配
DeepSeek Recipe 将 Chat Completions API、Responses API 和 Messages API 的请求转成同一种对话格式,共用模型模板和编码逻辑,按模型版本生成 prompt 和 token 序列。
模型输出经解析后,形成正文、思考内容和工具调用等事件,再转换为各协议的流式响应。请求转换、prompt 编码和输出解析都由 Rust 实现,以实现高效处理,同时支持 Python 绑定调用,以提升易用性。
Tokenizer 处理与加速
实践中,Tokenizer 面临两个比较棘手的问题:(1)随着模型上下文变长,线性 tokenize 的方法会引入较大的延时,影响 TTFT,且显著增加了服务的 CPU 开销;(2)special token 用于标记消息角色、思考边界和工具调用等结构,但这些标记也可能作为普通文本出现在对话当中,在处理请求时,需避免用户输入中携带的 special token 文本对模型推理效果产生不良影响。
针对这两个问题,我们在 DeepSeek Recipe 中实现了基于 special token 边界匹配的解决方案。
输入编码:构建 prompt 时记录显式插入的 special token 及其位置,编码时直接映射到对应的 token ID,普通文本按基础词表编码。用户输入、工具返回和工具调用参数中的 <|User|> 和 <|image|> 等字符串会被编码为相应的普通 token 序列,防止通过文本注入控制 token 影响模型行为。
输出解析:在处理响应 token 流时,我们根据 token ID 识别思考结束标记 </think> 和 DSML 标签中的 |DSML| special token。模型用普通 token 拼出的相同文本会被正确保留为原始内容,不会获得 special token 触发思考结束或工具调用的能力。
分段加速:构建 prompt 时,已经能够确定 special token 的位置和边界。根据 BPE tokenizer 的编码原理,可以发现 special token 之间的各段普通文本可独立编码。因此,我们在编码时首先跳过普通文本当中 special token 的匹配与切分,然后并行地编码各段普通文本,最后再按原顺序拼接结果。这样能降低超长上下文请求的分词耗时,优化请求延迟。
流式输出解析
推理后端按 token 粒度返回 chunk,一个 UTF-8 码点、DSML 标签或工具调用参数都可能被拆分到多个 chunk 中。为了正确 decode 模型的输出,并尽早解析出其中的结构以降低返回时延,我们需要实现一套跨 chunk 流式解析的状态机,在内存中保留尚未完成的处理进度和状态,并及时返回已经确定的内容。
跨 chunk 解析:解码遇到不完整的 UTF-8 码点时,状态机会先缓冲相关 token,待后续 token 到达、能够补齐状态后,再交给解析器。解析器按思考、正文和工具参数等阶段维护状态,使用 KMP 算法增量地匹配分隔标记。若发现 chunk 末尾只有标记的一部分,就暂时保留匹配进度,在下一个 chunk 到达时继续增量识别;已确定的内容则随解析进度输出,无需反复扫描此前的文本。
工具参数转换:工具名解析完成后即可返回,后续根据 DSML 参数边界直接生成 JSON 片段。字符串值逐段做 JSON 转义,数组、对象等非字符串值按原始 JSON 文本输出,无需构造完整参数对象,省去反复解析和序列化的开销。即使参数较长,也可以在生成过程中逐段返回,缩短首个参数片段的等待时间。
负载均衡
数据并行和专家并行都需要尽可能地为每张卡分配均衡的负载,从而降低卡间不同步造成的空转和等待开销。其中 Prefill/Decode Load Balancer 通过请求路由和调度来分别控制 prefill 和 decode 阶段不同卡上注意力子层的负载均衡,Vision Encoder Load Balancer 控制不同 vision encoder 之间的负载均衡,Expert-Parallel Load Balancer 通过冗余专家和动态调整来控制 MoE 子层的负载均衡。
Prefill Load Balancer
Prefill Load Balancer 的实现机制可分为 4 层,思路是围绕拟合的注意力子层计算量(记为 compute-quota,是预先拟合的二次代价模型cost(q, c),q = 序列中未命中的 token 数,c = 这条序列已经算完的前缀长度)来进行请求的路由和分布调度。
分桶:按输入总长分桶为 4 档:<16K / 16-64K / 64-256K / ≥256K,每档分到的引擎台数按该档上一轮的 compute-quota 需求占比动态重分;
DP 组间:按目前剩余的 compute-quota 拉取,由于任何引擎都能命中任何前缀,不做前缀亲和路由;
DP 组内:一批请求给到引擎后,每收到一个,就分发到当前 compute-quota 负载最低的 DP rank;
单卡内:请求 FIFO 出队,chunk size 不固定,由预算反解。每步有一个时间预算(单位是纳秒),调度时用拟合的二次代价模型 cost(q, c) 预测这一步要花多久,对 q 反解这个二次方程,取正好满足剩余时间预算的最大 q。
Decode Load Balancer
Decode Load Balancer 对所有decode实例的所有卡进行统一路由,原则是同时均衡请求数和 KVCache 总长度两个维度,前者决定每步批大小,后者决定注意力部分的代价。Decode Load Balancer 启发式地将短请求发给并发较小且 KVCache 总长偏大的卡,长请求发给 KVCache 总长较小的卡,具体可参考DualPath的组内调度算法 [1]。
Vision Encoder Load Balancer
对于图片的路由以单台机器为单位,由 prefill 机器随机选中一台部署有卡数个 vision encoder 的机器,在这台机器上,将图片交由当前处理图片 patch 数目(由宽高直接算出,(width/patch_size) × (height/patch_size))最少的卡的处理生成 embedding。
Expert-Parallel Load Balancer
专家并行负载均衡的实现方法可概括为:每卡在常驻专家之外多备若干冗余专家,用来放热门专家的副本。通过统计最近 N 步各专家的负载,每 M 步根据统计结果重新分配专家到卡实现动态调整,其中专家权重在 scale-up network 里经 symm_mem 在并行组内转移。
Prefill 的策略:每卡 4 个冗余专家起步(向上填充至总专家数为 ep_size 的倍数);统计窗 100 步,每 1000 步重排,线上数据实测 moe_lb(最慢 rank / 均值)= 1.0320(EP2/DP2)/ 1.0618(EP4/DP4)。
Decode 的策略:每卡 1 个冗余专家起步(向上填充至总专家数为 ep_size 的倍数),例如 EP64 取整后每卡共 7 个专家(不包括共享专家);统计窗 1000 步,每 10000 步重排一次,线上数据实测 moe_lb = 1.090。
自动扩缩容
PD 分离后两者的资源需求比例随流量动态发生变化,静态配比下的资源错配导致排队和空转的发生,因此需要通过自动扩缩容在集群层面跟随流量调整 Prefill/Decode 实例的比例。
实现方式:Prefill 通过统计未命中 token 数判断所需实例数目,decode 通过在计算的请求数判断所需实例数目,调整有限速和上下界。其中,针对大 EP 部署时长尾请求导致资源浪费的问题,decode 实例收到下线通知后进入宽限期(1 min),宽限期结束后仍未完成的请求及其 KVCache 一次性全部转发给其他实例继续 decode 计算。
冗余配额:部署时留冗余配额来应对流量变化引发的冲击,包括两方面:一是池子里留有尚未被占用的 ready 机器作为扩容库存;二是永远比算出来的需求多的实例在线,具体来说,配额占用率高于 0.8 时禁止缩容。
容错机制:错误重启在分钟量级,容错依赖配额冗余 + 请求级重新路由的组合机制,而不是靠缩短实例重启时间。大 EP 部署下,一个实例的全部卡构成单一通信域,任意一张卡故障即导致整个实例不可用。重启时为了把该实例其余健康的卡继续用起来,平台按当前健康的所有卡重新确定EP大小,实例以实际拿到的卡数作为 EP 规模。
KVCache Storage
随着对话上下文的增长和 agent 的广泛使用,KVCache 前缀缓存复用能够极大减少 prefill 重算,从而显著降低成本。DeepSeek-V4.1-Flash 模型的 KVCache 存储分为两个部分:Block KVCache 和 State KVCache,分别存储于 3FS 集群和本机内存中。
Block KVCache:以 128 tokens 为一个 block 进行分页式管理,根据模型架构设计,存储 4 层的 main KV 和 indexer K。
SWA KVCache:前 20 层各一个 134 token 的 ring(窗口长度=128 + 投机回退=6),不存储压缩中间态。

Block KVCache
Block KVCache 落盘于独立的 3FS 存储集群,不使用本机内存存储。相比多级存储系统,独立的存储集群使得所有 prefill 机器能命中任何前缀,避免前缀亲和和负载均衡路由策略冲突,也使得存储和计算节点自动扩缩容解耦、KVCache 缓存不受计算节点故障的影响(计算节点故障率比存储高数量级以上)。KVCache 系统设计考虑两方面因素:扩大存储容量来提升命中率,提升带宽来降低读取延时。
容量方面,3FS 分布式文件系统[2]为 KVCache 提供约 100 PiB 的 SSD 存储,agent 流量 KVCache 的 TTL(Time-To-Live)达到 3 天,chatbot 流量达到 7 天。对于 chatbot,其长尾命中更严重,少量 KVCache 会极多次读取,缺失后对整体命中率损失较大。根据经验,3 天左右的 TTL 会造成 chatbot 流量的 KVCache 命中率下降 0.5%-1%;带宽方面,3FS 存储集群针对 KVCache block 粒度(约 112 KiB)的随机读写进行优化,峰值聚合读带宽达到 10 TiB/s,峰值聚合写带宽约 850 GiB/s。
推理框架层面,Block KVCache 由 decode 实例落盘存储,使得 prefill 和 decode 输出均被复用。对于 KVCache 命中开销,命中路径分为三段,只有第一段在关键路径上:匹配由 Entrypoint 在本机 CHECK 角色的 kvcache-store 上做哈希链前缀匹配,只查元数据,但命中长度需在路由前进行计算,无法掩盖;取 KV 在独立进程里异步做,把 KVCache 从 3FS 搬进宿主机 shm;换入从 shm 到 HBM 在 engine 进程内的线程里做,目标是实现逐层 H2D (Host-to-Device) 传输与前向计算重叠,由于 CUDA copy engine 对于 KVCache Block 细粒度的拷贝性能不佳,换入使用 GDR 实现,用 RDMA 网卡就能打满 PCIe 带宽,并且不占 SM。
SWA KVCache
SWA KV 不进持久化缓存,而是留在产生它的那台机器的内存里,由一个逻辑上统一、实际按 key 分开存放在各台 Entrypoint 上的内存目录记录在哪台机器,命中时本机没有就跨机取回。由于 SWA KV 只在会话内的分钟级窗口里被复用,池子总容量虽小但周转快,足以覆盖同时活跃的会话,线上数据显示,其TTL约 180 秒,命中率在 98% 以上。被驱逐造成的未命中由上述的 Encoder SWA Bounded Replay[3] 重算。
SWA KVCache 只在 128 tokens 的整数倍位置上存储。Prefill 阶段结束后存储:位置取序列末尾留出一个 token 后向下对齐到 128 所得的位置,不足一个 128 tokens 则本轮不存储;chunked prefill 中途不存储,只有最后一个 chunk 才存储。Decode 阶段在显存中另开一块副本区,每跨过一个 128 tokens 边界就把该请求当前的窗口在显存内拷入副本区,请求结束时从副本区中最近一次完成拷贝的位置存储,附着点向下对齐到 128 边界,拷贝位置最多越过边界 5 个 token,由 ring 比窗口多出的 6 个位置吸收。
命中策略
命中的原则是:命中长度由 Block KVCache 决定,最后一个 block 是否需要重算由 SWA KVCache 决定,若 SWA KVCache 未命中,就退一块重算。具体地,根据YOCO截断要求,对于输入长度 L,最大的命中长度最多为 L - 134(窗口 128 + 投机回退 6)。在这个上限下,首先查询 Block KVCache 命中情况,假设命中长度为 L1(L1为block size=128的整数倍),再查询SWA KVCache命中情况。假如在 L1 - 128 至 L1 长度范围内,存在 SWA KVCache 则命中长度为 L1,否则命中长度为 L1 - 128,其中 128 为重算窗口。
3FS 分布式文件系统
如上所述,Block KVCache 数据量巨大,依赖 3FS 分布式文件系统存储。为应对节点宕机或网络抖动,需要兼顾高可用与高性能。
数据以纠删码(10+2 Erasure Coding)存放在 3FS 上,每个 EC 组可容忍 2 节点同时故障。
读取时同时向组内 11 台 Storage 节点发起请求,任意 10 个响应即可解码返回。
GC Worker 组件负责清理过期缓存:每个 Storage 节点部署一个实例,按 LRU 策略周期性淘汰最久未访问的 KVCache,将磁盘占用控制在水位线以下。
SWA Bounded Replay
SWA KVCache 不进行持久化存储,缺失时以重算恢复,这是 V4.1 相对 V4 在 KVCache 管理上的主要变化,具体可参考 V4.1 技术报告[2]。V4 的做法是落盘加精确重算:SWA KVCache 在两个位置写入持久化存储,未命中时重算“层数 × 窗口”个 token 做完整前向,逐层精确恢复窗口状态。这条路径代价很高,必须用足够大的 SSD 容量把未命中率压到极低,代价是 SWA KVCache 占去持久 KVCache 近一半容量,且未能带来相应的命中收益:Block KVCache 呈长尾复用,一段前缀可在数天内被反复命中;SWA KVCache 只在活跃会话内被分钟级复用,会话结束或进入下一轮即失效。以数天留存的 SSD 容量承载分钟级生命期的数据,在多轮短对话场景下尤其不划算。因此,V4 技术报告提出的 Zero SWA Caching(即完全不落盘、仅依赖精确重算)因其代价在生产部署中过高,在V4.1推理系统中未实际采用。
V4.1推理系统采用 SWA Bounded Replay,只重算最近 128 个 token,并把注意力窗口截断在重算段内:从位置 s 起回放,位置 i 的 query 只和 max(s, i − 127) 到 i 区间的 key 计算,重算得到近似的 SWA KVCache。重算代价由此降为与上下文长度和层数无关的常数。该机制用在两处:
Encoder SWA Bounded Replay:前缀缓存命中长度从此只依赖 Block KVCache。SWA KVCache 缺失时,重算命中前缀的最后 128 个 token,与未命中后缀一同前向;重算段只重建 SWA KVCache,Block KVCache 原样复用、不重算不覆写。
Decoder SWA Bounded Replay:prefill 计算仅在 encoder 层进行。CED 架构下 decoder 层的 Block KVCache 由 encoder 末层 hidden state 投影得到,仅 decoder SWA KVCache 需各层自算,精确重建要 20 个 decoder 层跑最后 2560 个 token;改为每次 prefill 在 decoder 层只重算 prompt 末尾 128 个 token,产出仅供 decode、不进前缀缓存,总 prefill 计算量近乎减半。
DSpark投机解码
DSpark 是 DeepSeek 提出的投机解码算法框架,相比 DFlash 在输出的 base logits 上叠加只依赖前一 token id 的低秩 logit bias,用极轻量的串行修正补回相邻 token 的局部条件化信息,提升 draft 准确率,具体可参考 DSpark 论文[4]。
在推理系统层面,DSpark 采用变长验证。由于不同请求、不同位置的 draft-token 接受概率不同,固定长度验证会浪费验证算力在低概率 token 上。DSpark 通过 Confidence Head 预测每个 draft token 的接受率,调度时把验证算力分配给边际收益最高的 token。线上部署时,draft 一次生成 5 个 token,根据 profile 出来的硬件吞吐曲线和每个请求的每个 draft-token 的接受率,把各 draft-token 按预期接受率排序,选取有效吞吐最大的前缀子集进行验证。经过对比,相比于固定验证 5 个 token,变长验证在线上部署场景吞吐提升 6%。
与 Asynchronous Scheduling 的配合:schedule(N+1) 执行时第 N 步的 confidence 尚未回传,因此 CPU 调度时只确定总预算,逐请求长度在 GPU 上由一个 tilelang kernel 重算(累乘、全局排序取 top-k,并融合 remap scatter),结果回写 pinned buffer。
Asynchronous Scheduling (Zero-Overhead Batch Scheduler)
Decode 第 N 步流程为:schedule(N) → forward(N) → sample(N) → post-process(N),其中 schedule 和 post process 是纯 CPU 逻辑,在 post-process(N) 之前,需要 GPU-CPU 同步拿到 sample(N) 的结果。这就导致 post-process(N) 和 schedule(N+1) 的时候,GPU 是空闲的状态。
参考已有实现[5][6],我们通过 GPU 和 CPU 之间的异步调度,将流水线重叠:GPU 执行 forward(N) → sample(N)时,CPU 同步执行 schedule(N+1)→ launch_forward(N+1)→ post-process(N-1) → launch_sample(N+1),GPU 全程无空闲。
结构化输出
结构化输出(Structured Output, SO)用于约束模型输出严格符合指定格式(JSON schema、正则表达式、EBNF 等)。
工作流程:
编译阶段(独立 SO 机器):将格式约束编译为语法自动机。
运行时:每步 decode 时,更新自动机,判断合法 token 集合,生成 mask 作用于采样逻辑,强制输出符合目标结构。
编译与推理解耦,SO 编译异步进行,请求在进入 engine 前取回编译结果。
知友讨论
阅读更多
🤝 知乎 AI Researcher Club 招募:
知乎联合 10+ 家媒体、创投孵化合作伙伴发起「AI Researcher Club」共创计划,长期支持支持 AI 前沿研究者,让重要的研究被看见、被讨论,让研究者找到彼此,也让新的合作由此发生。点击了解 >> AI Researcher Club
🚀 知乎 AI 社群:
如果你对 AI 共识、AI 活动感兴趣,欢迎扫码加入知乎社群↓,我们将每周送上知乎 AI 周报,分享社区内的 AI 讨论与共识,并不定时送上 AI 各类活动报名。
知乎AI情报站
让一部分开发者先走起来
🚀 知乎科技账号 @ZhihuFrontier 正式登陆 X
👉🏻 https://www.zhihu.com/project-square,上传你的 Vibe Coding 项目,在知乎遇见更多可能。