


监控竞争对手的价格和产品线,有助于在线零售商赢得价格战、优化促销策略并追踪产品趋势。然而,对许多小型电商企业而言,人工跟踪竞品既痛苦又低效。
幸运的是,借助易用的应用框架 Scrapy,几乎任何人都能创建网络爬虫抓取竞品网站并收集定价数据。只要具备基础的 HTML 和 CSS 知识,即可上手使用。
在深入演示前需说明,市面上已有 Wiser、Price Trakker、Upstream Commerce 等优秀服务可帮助卖家跟踪竞品甚至制定动态定价策略。若预算充足,这些现成方案可能更省心;但对于觉得此类服务昂贵的小型零售商,Scrapy 是一个高性价比的替代选择。
Scrapy 应用框架简单易用
尽管使用 Scrapy 需要编写代码,但构建网页抓取机器人实际上比多数常见网页开发任务简单得多,初学者也能快速掌握。
Scrapy 是一个用于创建网络爬虫的应用框架。
实际操作中,最困难的部分往往是识别页面上需要抓取的元素,这要求熟悉 HTML 结构和 CSS 选择器。
此外,Scrapy 易于上手还有三个原因:其一,它基于 Python,语法简洁且普及度高;其二,支持 Mac OS X、Linux 和 Windows,无需额外搭建服务器;其三,作为成熟框架,所需编写的代码量相对较少。
寻找漫画价格
为演示 Scrapy 的使用,我们设定一个案例:Al 是一位漫画零售商。该领域竞争激烈,新版漫画发行初期封面价通常代表主流定价,但旧版或收藏版价格波动较大。
Al 希望确保其在实体店、网店及 eBay 上销售的旧版和收藏版漫画定价符合市场行情。同时,由于采购量大,他还需追踪价格随时间的变化以发现趋势。
Al 计划监控的目标网站之一是 Things From Another World (TFAW),一家知名漫画零售商。我们将通过 Scrapy 抓取 TFAW 上 Dark Horse Comics《质量效应》系列漫画的价格。
构建的爬虫将首先在 TFAW 的《质量效应》分类页面定位产品链接,随后跟随链接进入详情页,提取定价信息。
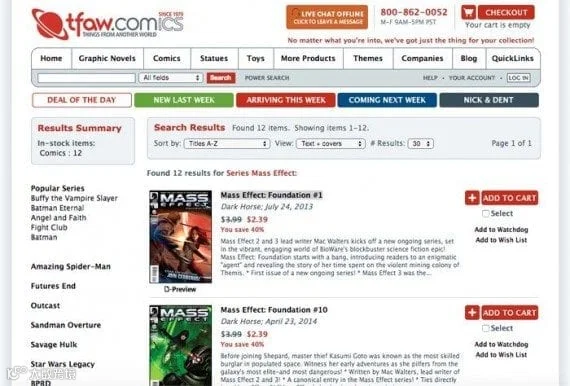
爬虫将从 TFAW 的一个产品类别页面开始抓取。
安装 Python 和 Scrapy
使用基于 Python 的 Scrapy 框架前,需确保计算机或服务器已安装以下组件:
- Python 2.7 及以上版本
- pip 包管理器
- Python setuptools
- lxml Python 库
- OpenSSL 库
若使用 Mac OS X 或 Linux 系统,安装过程极为简便。以 Mac 为例,Python 已预装,只需下载 pip 并在终端执行几条命令即可。
可从 https://bootstrap.pypa.io/get-pip.py 获取 pip 安装包。下载后打开终端,进入文件所在目录运行:
sudo python get-pip.py输入登录密码后,系统将自动安装 pip 和 setuptools。
接着升级 six 包以避免与 Scrapy 冲突:
sudo pip install --upgrade six最后安装 Scrapy:
sudo pip install ScrapyWindows 用户需额外步骤,详见 Scrapy 官方文档:http://doc.scrapy.org/en/1.0/intro/install.html。
创建 Scrapy 项目
在终端中导航至目标目录,使用 startproject 命令创建新项目:
scrapy startproject tfaw该命令包含三部分:scrapy 指定框架,startproject 表示新建项目,tfaw 为项目名称(可自定义)。
执行后,框架自动生成如下目录结构:
tfaw/
├── scrapy.cfg
└── tfaw/
    ├── __init__.py
    ├── items.py
    ├── pipelines.py
    ├── settings.py
    └── spiders/
        └── __init__.py
创建 Item 定义
在项目文件中,items.py 用于定义待抓取的数据字段。初始内容如下:
# -*- coding: utf-8 -*-
import scrapy

class TfawItem(scrapy.Item):
    # define the fields for your item here like:
    # name = scrapy.Field()
    pass
类名 TfawItem 由项目名称首字母大写生成,符合 Python 命名规范。
根据需求,假设 Al 需抓取产品标题、UPC 和价格,可将字段添加如下:
class TfawItem(scrapy.Item):
    title = scrapy.Field()
    price = scrapy.Field()
    upc = scrapy.Field()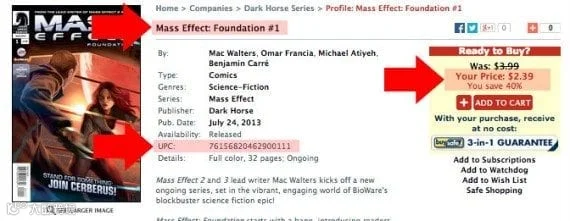
一个重要的步骤是决定你想从页面中抓取哪些内容。
为便于排查错误,建议同时记录详情页 URL。最终 items.py 如下:
class TfawItem(scrapy.Item):
    title = scrapy.Field()
    price = scrapy.Field()
    upc = scrapy.Field()
    url = scrapy.Field()
注意:Python 对缩进敏感,请使用代码编辑器(如 VS Code、Sublime Text)修改文件,切勿使用 Word 等文字处理器。
创建你的 Scrapy 爬虫
在终端中运行 genspider 命令生成爬虫:
scrapy genspider massEffect tfaw.com其中 massEffect 为爬虫名称,tfaw.com 为目标域名。生成的爬虫文件位于 spiders/massEffect.py,初始内容为:
import scrapy

class MasseffectSpider(scrapy.Spider):
    name = "massEffect"
    allowed_domains = ["tfaw.com"]
    start_urls = ('http://www.tfaw.com/',)

    def parse(self, response):
        pass
定位起始 URL
默认起始 URL 与允许域名相同,需修改为实际目标页面:
start_urls = [
    'http://www.tfaw.com/Companies/Dark-Horse/Series?series_name=Mass+Effect',
]
注意将元组改为列表格式。
解析产品分类页面
爬虫启动后会调用 parse 函数。首先需从分类页提取各漫画详情页链接。
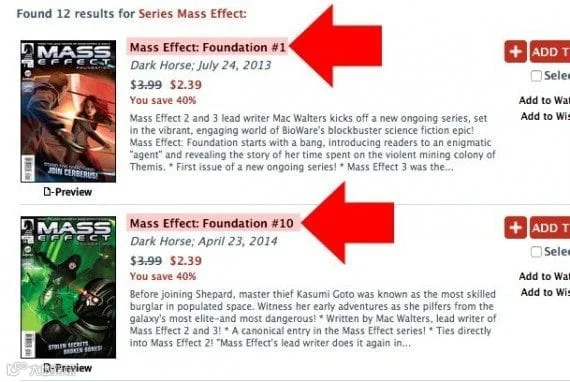
在 TFAW 分类页面上,漫画书标题是指向特定产品详情页面的链接。
可通过 CSS 选择器或 XPath 定位元素。以下为更新后的 parse 函数:
def parse(self, response):
    for href in response.css('div a.boldlink::attr(href)'):
        url = response.urljoin(href.extract())
        yield scrapy.Request(url, callback=self.parse_detail_page)
关键行解释:
for href in response.css('div a.boldlink::attr(href)')::遍历所有 class 为 boldlink 且位于 div 内的 a 标签的 href 属性。response.urljoin(href.extract()):将相对路径转换为完整 URL(因 TFAW 使用相对链接)。yield scrapy.Request(url, callback=self.parse_detail_page):请求详情页并指定回调函数。
HTML 示例结构如下:
<div style="margin-bottom: 3px; margin-top: 0px;">
  <a class="boldlink" href="..." name="427354">Mass Effect: Foundation #1</a>
</div>
可使用 Chrome 开发者工具(右键 → “检查元素”)辅助定位。
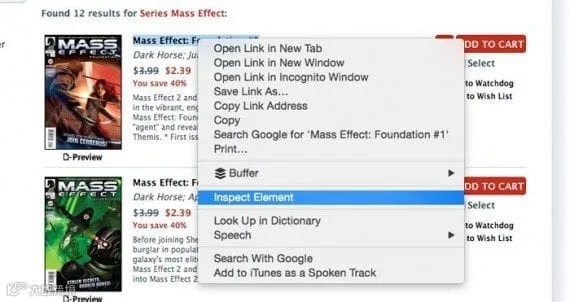
Web 浏览器通常包含开发工具,可帮助你识别页面上的元素。在 Google Chrome 中,右键单击要检查的元素。
测试时可临时注释后续两行并添加 print(href),运行 scrapy crawl massEffect 验证是否正确获取链接。
解析产品详情页
爬虫已能访问详情页,接下来编写 parse_detail_page 函数提取具体数据:
def parse_detail_page(self, response):
    comic = TfawItem()
    comic['title'] = response.css('div.iconistan + b span.blackheader::text').extract()
    comic['price'] = response.css('span.blackheader ~ span.redheader::text').re(r'[$]\d+\.\d+')
    comic['upc'] = response.xpath('//td[contains(.,"UPC:")]/following-sibling::td[1]/text()').extract()
    comic['url'] = response.url
    yield comic
要点说明:
::text:仅提取元素内部文本而非整个标签。.re(r'[$]\d+\.\d+'):使用正则表达式过滤“Your Price:”等前缀,仅保留价格数值。- XPath 用于定位 UPC 字段,例如
//td[contains(.,"UPC:")]/following-sibling::td[1]/text()。
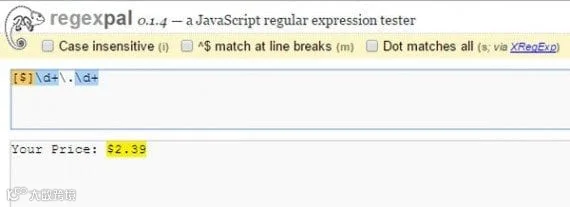
正则表达式可以在文本中定义选择范围。
推荐使用 RegexPal 等工具调试正则表达式。XPath 也可通过浏览器开发者工具辅助生成,但需注意部分工具可能包含不存在的 tbody 元素。
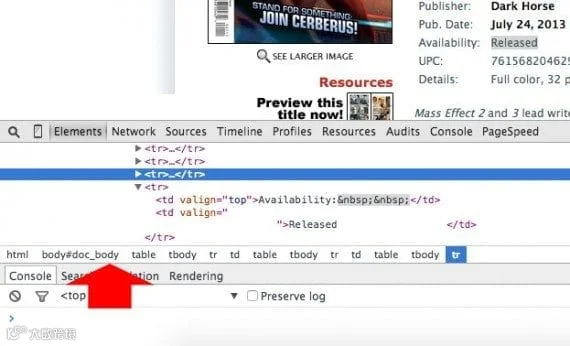
Web 浏览器的开发工具通常会显示 XPath 或可从中识别 XPath 的元素列表。
开始监控价格
爬虫完成后,在终端运行以下命令导出数据为 CSV 文件:
scrapy crawl massEffect -o results.csv生成的 results.csv 可直接用 Excel 或 Google Sheets 打开,内容示例如下:
url,price,upc,title
http://www.tfaw.com/.../Mass-Effect-Foundation-4___433370,$2.39,76156820462900411,Mass Effect: Foundation #4
http://www.tfaw.com/.../Mass-Effect-Foundation-12___450605,$2.39,76156820462901211,Mass Effect: Foundation #12
...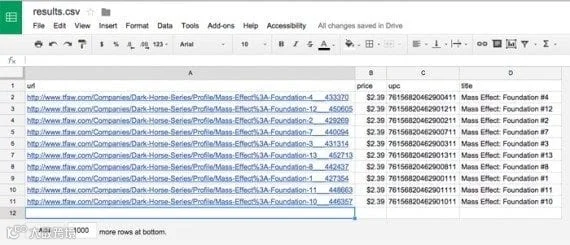
生成的 CSV 文件可以作为电子表格打开。
总结
即使是最小的电商企业,也能利用 Scrapy 高效采集竞品定价信息。店主 Al 只需每周运行一次爬虫,即可获得结构化数据。若目标网站改版,仅需微调爬虫规则,远比手动巡检高效可靠。批量部署多个爬虫,更能显著提升市场响应速度。