


电商业务所有者和经理爬取自身网站有诸多理由,包括监控页面、跟踪性能、确保无障碍访问及寻找优化机会。
虽然市面上有专门的工具和服务可供购买,但通过少量开发工作,您完全可以创建定制化的网站爬虫和监控系统。构建此类应用的第一步是获取网站所有页面的列表。本文将介绍如何使用 Python 语言及 Scrapy 框架轻松生成该列表。
Scrapy 框架使得创建网络蜘蛛变得相对容易。
您需要一台服务器、Python 和 Scrapy
这是一个开发项目,需要一台已安装 Python 和 Scrapy 的服务器,并通过终端或 SSH 客户端获得命令行访问权限。
关于在 Linux 或 OS X 上安装 Python 和 Scrapy 的详细步骤,可参考 Python.org 文档部分及 Scrapy 官方安装文档。本文假设您的服务器环境已准备就绪。
创建 Scrapy 项目
使用 SSH 客户端(如 Putty)或终端导航至目标目录,利用内置命令 startproject 快速生成基础文件。以爬取“Business Idea Daily”网站为例,将项目命名为“bid”:
scrapy startproject bid
执行后,Scrapy 将自动生成所需的文件和目录结构。
生成新的 Scrapy 网络爬虫
Scrapy 提供了命令行工具用于自动生成网络爬虫:
scrapy genspider -t crawl getbid businessideadaily.com
命令解析如下:
- scrapy:引用 Scrapy 框架;
- genspider:指示生成新的网络爬虫(抓取器);
- -t:指定模板类型。genspider 支持 basic、crawl、csvfeed 和 xmlfeed 四种模板,此处选用 CrawlSpider;
- getbid:爬虫名称,可自定义;
- businessideadaily.com:目标网站域名,框架将据此填充爬虫参数。
定义 Items
在 Scrapy 中,Item 是组织爬虫收集内容的小型模型。虽然获取页面列表可以不使用 Item,但为了便于后续扩展爬虫功能,建议定义 Item。
打开项目生成时创建的 items.py 文件,找到基于项目名称生成的类(如 BidItem),将 pass 替换为名为 url 的新字段定义:
class BidItem(scrapy.Item):
    url = scrapy.Field()
保存文件即可。
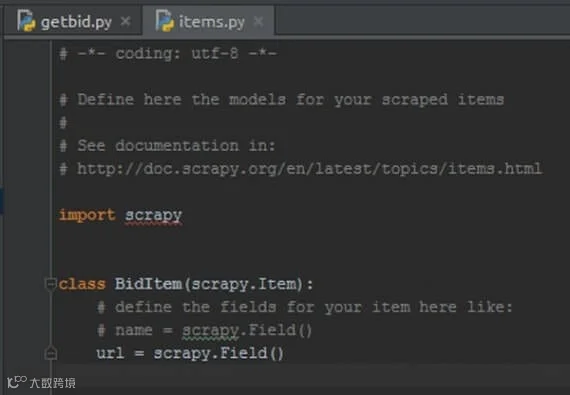
该条目在编辑器中的显示效果。
构建网络爬虫
在项目目录的爬虫文件夹中找到新生成的爬虫文件(本例为 getbid.py),其初始代码如下:
# -*- coding: utf-8 -*-
import scrapy
from scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule
from bid.items import BidItem

class GetbidSpider(CrawlSpider):
    name = 'getbid'
    allowed_domains = ['businessideadaily.com']
    start_urls = ['http://www.businessideadaily.com/']

    rules = (
        Rule(LinkExtractor(allow=r'Items/'), callback='parse_item', follow=True),
    )

    def parse_item(self, response):
        i = BidItem()
        #i['domain_id'] = response.xpath('//input[@id="sid"]/@value').extract()
        #i['name'] = response.xpath('//div[@id="name"]').extract()
        #i['description'] = response.xpath('//div[@id="description"]').extract()
        return i
需进行以下修改:
1. 修改 rules 下的 LinkExtractor,删除括号内的过滤条件,使其抓取起始页上的所有链接并跟随访问:
Rule(LinkExtractor(), callback='parse_item', follow=True),
2. 更新 parse_item 方法,删除注释示例代码,并将变量名改为更具语义的 href,同时捕获页面 URL:
def parse_item(self, response):
    href = BidItem()
    href['url'] = response.url
    return href
至此,新爬虫已配置完成。
爬取网站并获取数据
在命令行中进入项目目录,运行以下命令启动爬虫并导出数据:
scrapy crawl getbid -o 012916.csv
其中 -o 表示输出结果,012916.csv 为输出的 CSV 文件名。对于仅有少数页面的站点,Scrapy 会迅速返回类似以下的页面地址列表:
url
https://businessideadaily.com/auth/login
https://businessideadaily.com/
https://businessideadaily.com/password/email
若针对数千个页面的大型网站,运行时间会相应延长,但原理相同。仅用几行代码,您便为网站监控应用奠定了坚实基础。
另见:“使用 Scrapy 和 WAVE 监控电商网站的无障碍错误。”