


在我上周的文章《SEO 201,第一部分:技术规则》中,我提出了三条对挖掘谷歌作为客户影响者的终极力量至关重要的技术规则。第一条也是最重要的一条规则是:可爬取性决定了可发现性。
规则1:可抓取且可索引
如果您希望网站或网站的某个部分带来有机搜索流量和销售,内容必须可被抓取和索引。
搜索引擎爬虫能否访问您的网站,是决定您能否通过有机搜索获得排名、流量和销售的关键。搜索引擎必须能够抓取网站的 HTML 内容和链接,以便对其进行索引并分析其上下文相关性和权威性。
当爬虫无法访问网站时,从所有搜索意图和目的来看,该内容都不存在。既然内容不存在,它就无法获得排名,也无法带来流量和销售。
显然,为了确保搜索引擎爬虫能够访问和索引我们的网站,从而提升排名、流量和销售,我们最有利的做法就是确保“大门”敞开。
以下每一项技术障碍都会将搜索引擎爬虫拒之门外。它们按所阻挡的内容量大小排序,从影响页面最多到最少排列。
网站错误
对爬虫来说,最大的阻碍因素是内容缺失或网站不可用。如果网站宕机或首页返回错误消息,搜索引擎爬虫将无法开始抓取。如果这种情况频繁发生,搜索引擎会降低该网站的排名,以保护其自身搜索用户的体验。
最常见的错误包括服务器状态码为 404(文件未找到)和 500(内部服务器错误)。任何 400 到 500 范围内的错误都会阻止搜索引擎抓取您网站的部分或全部内容。管理您服务器的团队对这些错误非常熟悉,并致力于防止它们的发生,但 400 范围的错误尤其往往是特定于页面的,更难彻底排查。当您遇到 400 或 500 范围的错误消息时,请将其发送给您的技术团队。Google Webmaster Tools 提供了一个方便的报告,显示其爬虫遇到的所有错误。
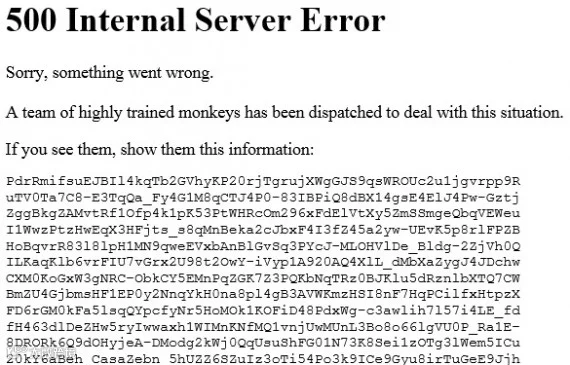
YouTube 幽默的 500 内部服务器错误消息。
Robots.txt 禁止指令
Robots.txt 是一个位于网站根目录的小型文本文件,用于请求爬虫访问或不访问某些类型的内容。robots.txt 文件中的 disallow 命令会告诉搜索引擎不要抓取该命令中指定的内容。
该文件首先指定一个用户代理(user agent)——即它正在与哪个机器人通信——然后指定允许或禁止访问的内容。robots.txt 文件一旦用户已经身处网站上,就不会对其产生影响;它仅阻止搜索引擎抓取和排名指定的内容。
为了理解如何使用 robots.txt,这里有一个示例。假设一个销售再生手提袋的网站——我们称之为 RecycledTotes.com ——希望阻止爬虫访问单独的优惠券页面,因为这些优惠券往往在大部分搜索者发现它们之前就已过期。当搜索者点击过期的优惠券时,他们自然会感到恼火,要么直接离开(跳出),要么向客户服务投诉。无论哪种情况,对 RecycledTotes.com 来说都是不利局面。
使用 robots.txt 的 Disallow 指令可以解决该问题。robots.txt 文件始终位于网站根目录,因此在本例中,URL 应为 www.recycledtotes.com/robots.txt。为每个优惠券的 URI 添加 Disallow 指令,或使用通配符 * 禁止托管单个优惠券的整个目录,即可解决问题。下图展示了这两种选项。
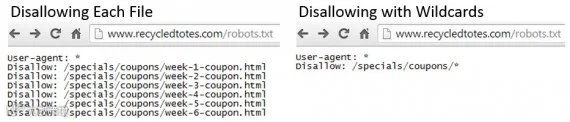
使用 Disallow 指令的 robots.txt 文件示例。
robots.txt 协议非常有用,但也极具危险性,很容易意外禁止整个网站的访问。请在 http://www.robotstxt.org 了解更多关于 robots.txt 的信息,并在将 robots.txt 文件的任何更改上线之前,务必在 Google 站长工具中进行测试。
Meta Robots NOINDEX
可以通过使用 NOINDEX 属性配置 robots 元标签,以防止搜索引擎爬虫索引特定的内容页面。这与 robots.txt 中的 Disallow 不同,后者是阻止爬虫抓取一个或多个页面。带有 NOINDEX 属性的 meta robots 标签允许爬虫抓取页面,但不会保存或索引页面上的内容。
要使用此方法,请将 robots 元标签放置在你不希望被索引的 HTML 页面的 head 部分,例如 RecycledTotes.com 上的优惠券页面,如下所示。

使用 NOINDEX 属性的 meta robots 标签示例。
大多数公司会将该标签放置在 title 标签和 meta description 附近,以便于识别与搜索引擎相关的元数据。由于该标签是针对特定页面的,因此对于每一个不希望被索引的页面都需要重复添加。如果你希望限制使用该模板的所有页面的索引,也可以将其放置在模板的 head 部分。
通常很难意外地将 meta robots NOINDEX 属性应用于整个网站;因此,这种策略通常比 Disallow 更安全。然而,它的实施过程也更为繁琐。
对于使用 WordPress 的电子商务网站:意外地对整个站点应用 NOINDEX 实际上非常容易。在 WordPress 的隐私设置(Privacy Settings)中,有一个名为“要求搜索引擎不要索引此站点”(Ask search engines not to index this site)的单选框,它会对站点中的每个页面应用 meta robots NOINDEX 属性。如果遇到 SEO 问题,请密切监控此复选框。
与 Disallow 一样,meta robots noindex 标签一旦用户访问你的网站,就不会对他们的体验产生影响。
其他技术障碍
某些平台和开发决策可能会无意中造成抓取和索引障碍。JavaScript、CSS、Cookie、iframe、Flash 及其他技术的某些实现方式可能会阻碍搜索引擎的抓取。在其他情况下,这些技术可能对搜索引擎更加友好。
这也引出了技术 SEO 的第二条规则:“不要相信你能看到的就是可抓取的。”下周的文章将深入探讨这些技术障碍的细节。
欲了解我们“SEO 201”系列的下一期内容,请参阅《第三部分:启用搜索引擎爬虫》。