


搜索引擎通过遍历互联网,从数十亿数据点中筛选信息并即时呈现结果。这种便捷体验背后,是庞大的数据检索与软件系统支撑。以最为坦诚的谷歌为例,搜索引擎核心功能主要包含两点:
- 索引信息:发现并存储万维网上约30万亿个独立页面的信息。
- 返回结果:利用复杂算法和机器学习,识别并向用户展示与搜索查询最相关的页面。
爬取与索引化
谷歌如何找到海量网页?过去18年间,其通过名为“爬虫”(Crawler/Bot/Spider)的软件程序逐页爬取互联网。人类提供一组种子页面作为起点,引导爬虫进行索引和追踪。例如,谷歌使用Googlebot,Bing使用Bingbot,Yahoo则使用Slurp。
当爬虫访问页面时,会捕获文本内容、渲染后的HTML代码、入链信息及出链链接等关键数据。
随着爬取深入,Googlebot会发现更多链接。下图展示了在折扣艺术用品电商网站Jerry’s Artarama上的一次简化爬取路径示例:
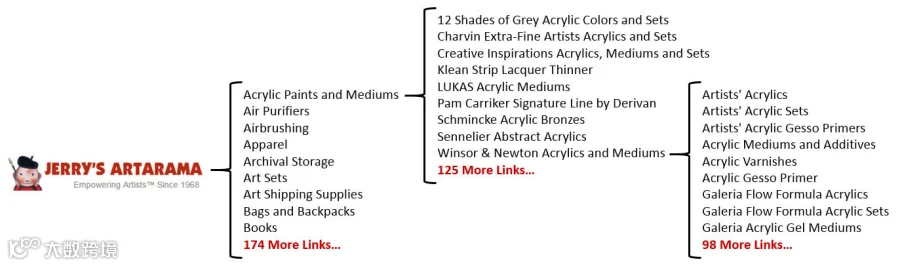
Jerrysartarama.com上的简单爬取路径示例。
图中左侧标志代表站点首页,Googlebot在此处发现了184个链接。跟随导航中的“Acrylic Paints and Mediums”链接进入新页面后,又发现135个链接;继续点击“Winsor & Newton Acrylics and Mediums”,则遇到108个链接。爬虫会持续沿链接访问,直至发现所有相关页面。
爬取过程中,爬虫会反复遇到相同链接(如页眉、页脚导航)。为避免重复劳动,Googlebot通常仅记录页面间关系,随即转向下一个唯一页面。
爬取收集的海量信息被存储在数据中心的大型数据库中。如需了解谷歌数据中心的规模,可观看官方导览视频《Inside a Google data center》。
这些信息被有序存入索引,而非随机堆砌。索引会根据内容版本、上下文、链接结构、同义词、发布时间及多媒体元素等维度进行分类组织,以便算法在返回结果时精准定位。
返回搜索结果
用户在搜索引擎输入关键词后展示的网页即为“搜索结果”,其排列顺序称为“排名”。关于具体展示逻辑,各搜索引擎均视为商业机密。
这一决策过程由专有算法驱动,旨在从索引中快速提取最相关信息并以最优方式呈现。尽管命名不同,现代搜索引擎算法的基本原理相似。例如,谷歌高级策略师Andrey Lipattsev曾确认,排名前三的因素为:内容、链接和RankBrain(机器学习AI系统)。
内容决定上下文相关性:页面词语、语境及关联链接共同决定了其在索引中的存储位置及能回答的搜索查询。
链接决定权威性与相关性:链接不仅是爬取路径,更是权威性信号。算法通过衡量指向页面的质量与相关性,以及该页面出链的质量来确定权重。
搜索引擎结合数百种信号与机器学习,评估页面与查询的匹配度。通常,一个页面需在上下文相关性和权威性两方面均排名前七至十位,才有机会出现在搜索结果第一页。