


有时,网站存在搜索引擎优化(SEO)问题,而 Google Search Console、Google Analytics 以及现成的 SEO 工具都无法发现。在这种情况下,我通常会依赖一种传统方法:Web 服务器日志。
什么是 Web 服务器日志?
你可能认为 Google Analytics 或类似的分析平台会记录访问你网站的每一次访问。然而,分析平台通常不会记录大多数机器人访问,包括搜索引擎爬虫。
相比之下,Web 服务器日志会记录所有访问你网站的行为,无论是来自人类还是机器人。你可以将 Web 服务器日志视为记录网站上所有活动的自动日志。它们通常包括访问者的来源 IP 地址、浏览器用户代理(User-Agent)、请求的页面以及访问者来源的页面。
服务器日志的主要挑战在于信息以原始格式呈现。你需要采取额外步骤来分析这些数据。
例如,以下是 Apache 组合日志格式的样子。
66.249.64.34 - frank [05/Apr/2017:13:55:36 -0700] "GET /product-123 HTTP/1.1" 200 2326 "http://www.webstore.com/home.html" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"
我已用下划线标出日志中的关键部分:访问者的IP地址、访问时间、访问的页面、引荐页面以及访问者或机器人。你可以使用IP地址来验证Googlebot的访问。
使用服务器日志的 3 个示例
以下是三个最近的案例,我在其中使用了 Web 服务器日志来找出 SEO 问题的根源。
第一个例子来自我与一家跨国公司的合作经历。Google Search Console > Crawl > Sitemaps报告XML站点地图中包含超过10万个页面,但Google仅索引了不到2万个。然而,Search Console > Google Index > Index Status报告显示有超过7万个页面已被索引。
这是如何做到的?
Google 可能会索引许多重复或过时的页面,而遗漏网站的“真实”页面。难点在于确定哪些重复页面被索引了,而哪些真实页面没有被索引。
不幸的是,Google Search Console并未提供已索引URL的列表,也未告知你XML站点地图中哪些页面未被索引。为了解决这个问题,我们需要同时回答这两个问题。
在本例中,我收到了涵盖 1 月底到 3 月初的服务器日志。经过分析,我们发现 XML 站点地图中的页面只有不到 9% 在此期间被 Google 抓取。

在该客户的案例中,91.6% 的站点地图 URL 未被抓取。
当我们仔细查看未被爬取的页面时,发现其中大多数具有完全相同的内容和模板,唯一的区别是产品名称。看来Googlebot因这些页面内容完全相同而未对其进行爬取。此外,我们确认Googlebot在机器人陷阱上浪费了时间。
我之前曾讨论过机器人陷阱(即无限爬取空间)。它们通常出现在拥有庞大数据库的网站中——例如大多数电子商务平台——并导致搜索引擎机器人陷入无尽的循环抓取。一个典型的例子是分面导航或引导式导航,这会产生近乎无限多的选项。无限爬取空间会浪费Googlebot的爬取预算,并可能阻止重要页面的索引。
本例的解决方案是一个痛苦的过程,即为每个页面编写独特的内容,从最畅销的产品开始。(衡量对独特内容的投入有助于判断这样做是否合理。)
第二个例子来自汽车行业的一个大型网站。我们将该网站迁移至HTTPS后,面临许多重新索引延迟的问题,这损害了网站的自然搜索排名。
这个案例特别具有挑战性,因为我们怀疑该网站存在严重的机器人陷阱,但我们必须处理来自多个Web服务器的TB级日志数据,按页面类型对页面进行分类,并模拟Search Console > Crawl > URL Parameters的功能以理解问题所在。
按页面类型进行的细分使我们能够将机器人陷阱问题缩小到“年-品牌-型号-类别”URL 组。接下来,我们想看看是否有异常数量的页面因 URL 参数而被抓取,从而帮助我们定位机器人陷阱。
我们的日志分析帮助我们识别了问题。我们发现三个新的URL参数未出现在Search Console > Crawl > URL Parameters列表中,但它们获得的访问量却超出预期。(对URL参数进行分类有助于Google避免爬取重复URL。)由于它们未列在Search Console > Crawl > URL Parameters中,我们无法修复该问题。我原本以为Google会列出任何需要我们关注的参数,但这是错误的。我们实际上有近100个有问题的URL参数。
URL 参数的话题可能令人困惑。URL 参数在页面的 URL 中动态设置,并由其模板和数据源驱动。URL 参数由键和值组成,两者之间用等号(=)分隔,并用连字符(&)连接。第一个参数始终出现在 URL 中的问号之后。
几乎每个电子商务平台都有从数据库内容自动生成动态页面。这些动态页面通常使用 URL 参数来帮助电子商务应用程序展示正确的内容。一个例子是分页分类页面,如下所示。
- http://www.webstore.com/shoes
- http://www.webstore.com/shoes?page=2
- http://www.webstore.com/shoes?page=3
- http://www.webstore.com/shoes?page=4
在这种情况下,“page”是一个URL参数。Google将其视为活跃参数,因为它会更改或影响页面内容。在Google Search Console中,我们会在Crawl > URL Parameters中设置该参数。这将指示Google爬取每个页面,以便它获取规范标签和分页标签。
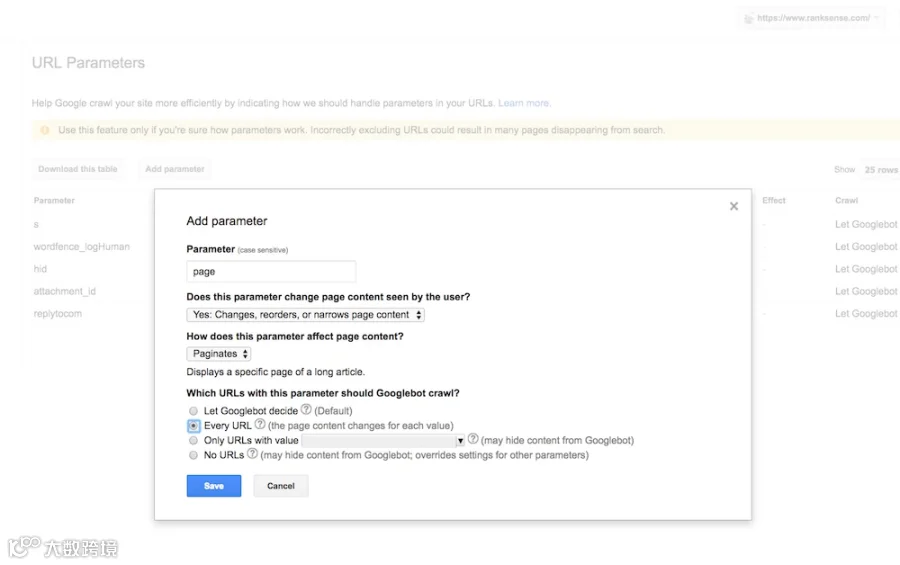
在 Search Console > Crawl > URL Parameters 中设置“page”参数。点击图片放大。
另一个例子是我们在页面中添加的一个用于跟踪目的的参数,以便了解哪些营销活动表现更好。
- http://www.webstore.com/shoes?utm_source=Google
- http://www.webstore.com/shoes?utm_source=Bing
- http://www.webstore.com/shoes?utm_source=Facebook
在这种情况下,该参数为“utm_source”,这是一个标准的 Google Analytics 跟踪参数。它不会影响页面内容。Google 将其视为被动参数。
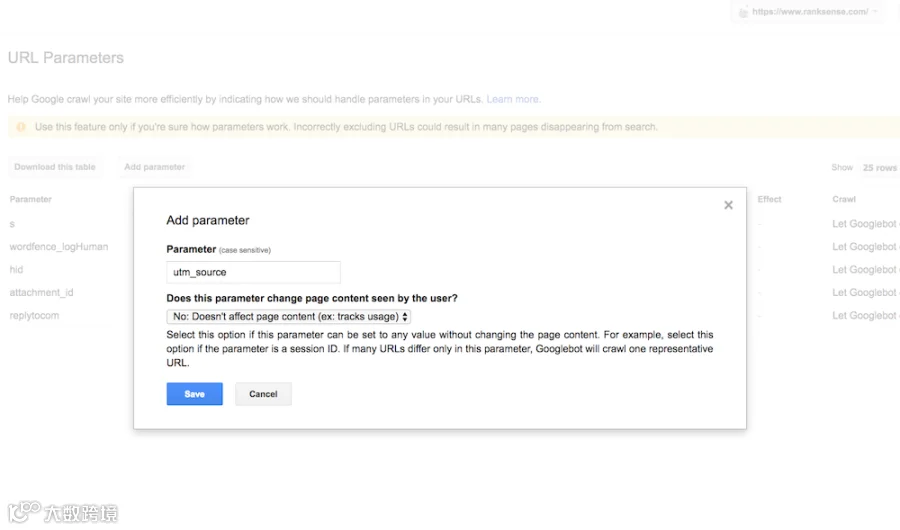
在 Search Console > Crawl > UTM Parameters 中设置“utm_source”,Google 将其视为被动参数。点击图片放大。
最后一个例子涉及一家知名的网络出版商。我们面临的挑战是,虽然我们知道网站上存在重复页面,但在使用蜘蛛工具 ScreamingFrog 运行时却找不到它们,因为这些页面没有内部链接。然而,当我们在 Google 中搜索时,可以在搜索结果中看到其中几个——这证实了它们已被索引。猜测要检查的 URL 并不具备可扩展性。这时就需要借助 Web 日志!
我们下载了从 2 月底到接近 3 月底的日志数据,并专注于回答以下问题:Googlebot 抓取了哪些未包含在 XML 网站地图中的 URL?
当你进行此类分析时,如果网站是一个博客,你可能会看到类别中文章列表以及带有冗余 URL 参数的页面,因为这些页面通常不会包含在 XML 网站地图中。我通常建议将列表页面(例如类别中的文章列表)单独包含在 XML 网站地图中(即使你为它们分配了规范标签),因为这有助于确认它们是否被编入索引。
使用服务器日志,我们惊讶地发现许多无用页面的页面标题与网站上其他合法页面的标题相同,但没有独特内容。我们不知道这些页面的存在,但 Googlebot 能够找到它们,并且不幸的是,对其中许多进行了索引。因此,该网站需要进行一些严重的清理工作以移除这些无用页面。
顺便提一下,Googlebot 可以发现蜘蛛工具(如 ScreamingFrog)无法找到的网页——原因如下。
- Google 会使用来自网络上任何网站的链接,而不仅仅是内部链接。
- WordPress 网站和大多数博客平台在创建新内容时会 ping 搜索引擎。
- Google 拥有长期记忆。如果页面过去曾被抓取,Google 未来可能会重新抓取它。
- Google 并未证实这一点,但它可能从 Chrome 或 Google Analytics 日志中发现新页面。
转换原始日志数据
我们为所有客户的日志分析编写代码。这里有一个简化的两步流程来开始操作。
首先,使用正则表达式(即“regex”)将日志数据转换为结构化数据格式,例如 CSV。以下是在 PHP 中有效的正则表达式。
^(\S+) \S+ \S+ \[([^\]]+)\] "[A-Z]+\s([^\s]+) [^"]+" \d+ \d+ "[^"]*" "([^"]*)"$
正则表达式可能很复杂,尤其是如果你不是 Web 开发人员的话。简而言之,正则表达式就是搜索模式。你可能熟悉通配符。例如,在计算机命令行中使用术语 *.docx 来列出目录中的所有 Microsoft Word 文档。正则表达式允许进行类似但更复杂的搜索。
使用 Regular Expressions 101 来验证和理解上述正则表达式的工作原理。将上述正则表达式输入该工具。你还需要输入一个测试字符串。对于这个例子,我将使用文章前面下划线标出的 Apache 日志示例。

使用 RegEx 101,我们可以将文章中之前引用的服务器日志条目作为“测试字符串”粘贴进去,并应用上述正则表达式。结果就是我们提取的数据。点击图片放大。
在这种情况下,该工具使用上述参考服务器日志条目的正则表达式搜索模式来提取 Googlebot IP、访问日期、访问页面和浏览器用户代理(在本例中为 Googlebot)。
如果你向下滚动右侧的“匹配信息”部分,你会看到提取的信息。此正则表达式专门适用于 Apache 组合日志格式。如果你的 Web 服务器是 Microsoft IIS 或 Nginx(举例),则此正则表达式将无法工作。
下一步是编写一个简单的 PHP 脚本,逐行读取日志文件,并执行此正则表达式以搜索和捕获你需要的数据点。然后将它们写入 CSV 文件。你可以在网上找到一个免费的示例脚本来完成此操作。这段代码已有六年历史,但正如我所说,Web 服务器日志属于老派技术。
将日志条目转换为 CSV 格式后,使用商业智能工具(用于检索和分析数据)来读取文件并获取问题的答案。我使用的是 Tableau,它价格昂贵。但也有许多其他选项提供免费层级,例如 Microsoft Power BI。