


如果新内容或更新的内容未被抓取和索引,低效的抓取预算会影响自然搜索表现。
Google 在《爬取预算对 Googlebot 意味着什么》一文中指出,控制爬取预算的因素有两个:爬取速率和爬取需求。“将两者结合,我们将爬取预算定义为 Googlebot 能够且希望爬取的 URL 数量。”
对于页面少于几千个的网站,抓取预算通常不影响表现;但电子商务网站页面众多,可能引发问题。
本文将介绍如何生成报告以判断网站是否存在 Googlebot 抓取预算问题。目标是列出尚未被抓取(因此也未被索引)的新网页或已更新网页。具体方法是通过生成站点 XML 网站地图中所有 URL 列表(含创建或修改日期),并与网络服务器日志中的 Googlebot 爬取活动进行比对。在分析爬取预算时,日志文件是最佳信息来源。
日志文件处理
首先使用 Screaming Frog 的 Log File Analyser 进行分析:
- 导入日志:将日志文件拖入“在此拖放日志文件”区域,打开“Project”选项卡配置新分析。
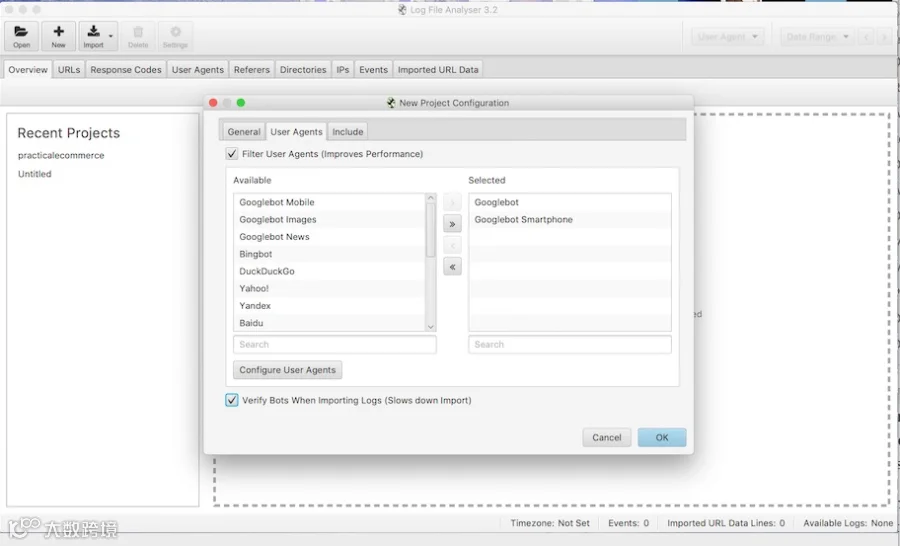
Screaming Frog 的 Log File Analyser 可以显示 Googlebot 抓取页面的时间。
- 修剪日志:隔离 Googlebot 条目并移除伪造请求。在项目选项卡中选择 New > User Agents,勾选“Verify Bots When Importing Logs (Slows down Import)”。该功能通过双重 DNS 验证确认 IP 真实性,正如 Google 《验证 Googlebot》文档所述。
- 导出数据:处理完成后导出为结构化 CSV 文件。选择“Verification Status Show Verified”选项以移除伪造条目,并确保日期格式正确。
XML 网站地图分析
假设 XML 网站地图全面、仅包含唯一 URL 且最后修改日期准确,其掌握着爬取预算分析的关键:
- 是否有页面或更新未被爬取?通过对比网站地图与日志中的爬取页面回答。
- 更改被拾取的速度有多快?通过对比修改时间与爬取时间回答。
由于 Screaming Frog SEO Spider 导出时会丢失关键修改时间,需改用 Python 将 XML 网站地图转换为 CSV 文件。
比较网站地图中的 URL 与日志文件
使用 Pandas 库解析 XML 索引网站地图及各个子地图为 DataFrame,并导出为 CSV 导入 Log File Analyser。在 URL 选项卡下拉菜单选择“Not in Log File”,即可获得一份未被爬取但应被爬取的 URL 列表。
相关代码:https://gist.github.com/hamletbatista/5d0d996872239ddbfe8744da049124a9
将修改时间与抓取时间进行比较
Log File Analyser 不支持直接比对修改与抓取时间,需再次使用 Python。将日志 CSV 加载至另一个 DataFrame,使用 Pandas merge 函数进行“左连接”,保留 XML 网站地图 URL 并捕获交集。
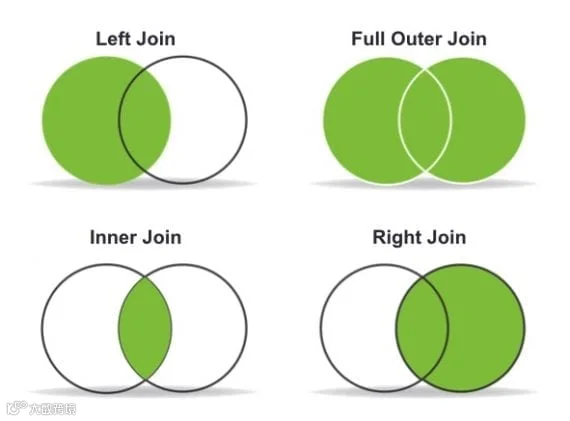
使用 Pandas merge 函数将两个 DataFrame 合并。使用“左连接”来保留 XML 站点地图 URL,并捕获站点地图和日志文件之间的交集。
合并后,可通过以下代码确定哪些页面因缺少抓取日期而未被抓取:
https://gist.github.com/hamletbatista/5e3a65bc19427d8c5570482b572d04b2
此外,通过比较爬取日期与最后修改日期,可生成两个列表:被快速爬取的已更新页面列表、未被爬取的页面列表。
相关代码:https://gist.github.com/hamletbatista/02fb89d885825398c611cba57fbdb3ec
后续操作
审查尚未被爬取的 URL,将重要 URL 插入 Search Console 的“URL 检查”工具获取详细信息,并可请求重新编入索引。