


若搜索引擎爬虫无法抓取网站,页面便无法获得排名。某些不影响用户访问但会阻碍爬虫进入的隐藏“门”正是问题根源。
通过分析爬取情况,可识别并解锁这些障碍,使爬虫顺利进入、获取信息并编入索引,从而出现在搜索结果中。
请遵循以下八个步骤,确保搜索引擎爬虫能够完整访问您的电商网站。
站点屏蔽器
爬虫能否进入该网站?
首先检查是否需要“解锁前门”。robots.txt 文件用于告知机器人是否禁止抓取网站内容。该文件命名固定,且始终位于域名根目录下:https://www.example.com/robots.txt。
务必确保 robots.txt 未包含阻止搜索引擎访问的命令。若文件中存在以下代码,请立即联系开发团队处理:
User-agent: *
Disallow: /
渲染
爬虫能否正确渲染您的网站?
爬虫进入后需找到内容,但无法立即渲染某些代码(如 Angular、React 等高级 JavaScript 框架)。这可能导致 Google 在抓取后数周甚至数月内无法渲染页面以索引内容和链接,其他搜索引擎甚至可能完全无法索引。
请使用 Google Search Console 的“URL 检查工具”及“移动设备友好型测试”,确认 Google 是否能正常渲染页面。

使用 Search Console 的 URL 检查工具查看 Google 如何渲染页面。此示例为 Practical Ecommerce 的主页。点击图片放大。
使用 JavaScript 框架的网站应为用户代理(User-Agent)预渲染内容。“用户代理”指请求网页的对象(如浏览器、爬虫或屏幕阅读器),预渲染可确保无法正常显示内容的代理也能获取信息。
伪装(Cloaking)
是否向所有用户代理(含爬虫)提供相同内容?
伪装是一种过时的垃圾邮件手段,即向用户和爬虫展示不同版本的页面以操纵排名。主流搜索引擎均能检测此类行为,并采取降权或不收录的惩罚措施。
有时“伪装”是无意的,仅因网站两个内容系统不同步所致。Google 的 URL 检查工具和移动设备友好测试有助于排查:若两者呈现的页面与标准浏览器一致,则通常无碍。
由于上述工具无法浏览完整页面,建议使用“User-Agent Switcher for Chrome”等扩展程序模拟 Googlebot 智能手机或其他爬虫。在扩展设置中添加以下四个用户代理字符串:
- Googlebot 移动版:Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2272.96 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
- Googlebot 桌面版:Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
- Bingbot 移动版:Mozilla/5.0 (iPhone; CPU iPhone OS 7_0 like Mac OS X) AppleWebKit/537.51.1 (KHTML, like Gecko) Version/7.0 Mobile/11A465 Safari/9537.53 (compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm)
- Bingbot 桌面版:Mozilla/5.0 (compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm)
开启模拟功能后加载主页,确保模拟 Googlebot 和 Bingbot 时看到的页面与常规访问时完全一致。
抓取频率
Google 和 Bing 的抓取趋势是否稳定?
利用 Google Search Console 和 Bing Webmaster Tools 诊断抓取率。关注趋势线的一致性;若出现异常峰值或低谷并形成新的平台期,需调查当日具体原因。
内部链接可抓取性
链接是否使用带 href 和锚文本的 <a> 标签编码?
Google 仅识别使用锚标签及 hrefs 编码且包含锚文本的链接。如下图所示,“将被抓取”的链接符合规范,而“未抓取”的链接则不符合。
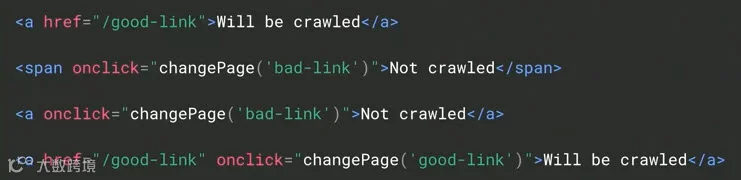
假设性标记展示了 Google 对可抓取与不可抓取链接的区别:“将被抓取”vs“未抓取”。来源:Google。
可使用 Chrome 开发者工具检查链接:右键点击任意链接选择“检查”,即可查看使其可见的代码结构。
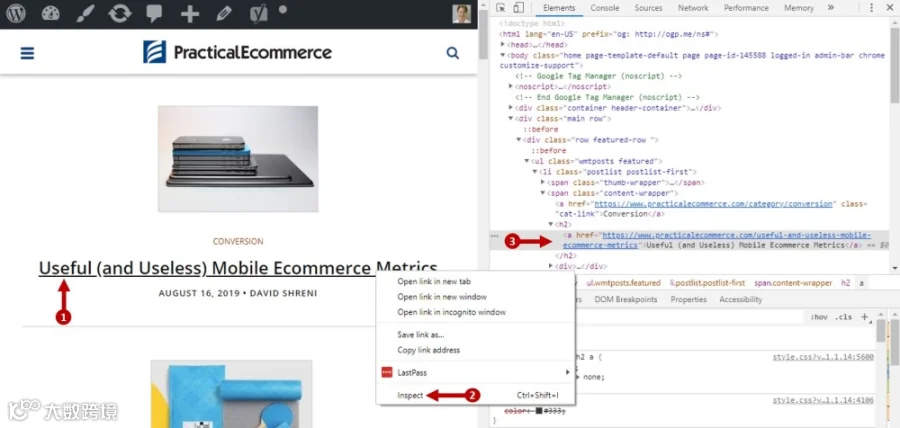
在 Chrome 中右键单击链接并选择“检查”以查看代码。点击图片放大。
机器人排除
是否允许爬虫访问核心内容,同时排除低价值页面?
第一步已确认爬虫能进入“前门”,这一步则是将其引导至正确路径。应将购物车、站内搜索、打印页、推荐好友及愿望清单等对自然搜索无价值的页面排除在外。
爬虫在网站上的停留时间有限(即抓取配额)。务必确保配额集中在最重要的内容上。加载域名的 robots.txt 文件进行分析,确保爬虫仅能访问正确页面。
Robotstxt.org 提供了详细的语法参考;修改前请使用 Search Console 的 robots.txt 测试工具进行验证。
URL 结构
URL 是否为抓取进行了正确结构化?
有效抓取只需满足四点:全小写、字母数字组合、连字符分隔、不含哈希符号(#)。虽然关键词导向的 URL 不直接影响抓取,但能向搜索引擎传递相关性信号。
可使用爬虫工具批量分析 URL。少于 500 页的网站可用 Screaming Frog 免费版;更大规模网站建议购买完整版或使用 DeepCrawl、Link Sleuth、SEMrush、Ahrefs 等替代方案。
也可从网络分析软件导出过去一年访问过的 URL 报告(如 Google Analytics 中的 Behavior > Site Content > All Pages,每次最多导出 5,000 条)。按字母顺序排序后,重点排查大写字母、特殊字符及哈希符号。
XML 网站地图
XML Sitemap 是否仅包含有效 URL?
XML Sitemap 旨在帮助搜索引擎发现和访问 URL,虽不能保证收录,却是通知爬虫分类、产品及内容页面的有效途径。
首先定位您的 XML Sitemap(通常为 https://www.example.com/sitemap.xml 或 sitemapindex.xml)。robots.txt 文件中应包含指向 Sitemap 的链接,格式如下:
Sitemap: https://www.example.com/sitemap.xml
若缺失请补加,并将 Sitemap URL 提交至 Google Search Console 和 Bing Webmaster Tools。
Sitemap 中的 URL 数量应至少与 SKU、类别页、内容页及位置页总数匹配,否则可能遗漏关键页面(如产品页)。同时,务必定期清理旧版 URL、已停产产品及已关闭地点的链接。未被包含在 Sitemap 中的 URL,极有可能无法被搜索引擎发现和抓取。
下期预告:“电商 SEO 收录审计的 6 步法。”