


网站地图分为HTML和XML两种类型。HTML网站地图主要用于引导访问者,而XML网站地图则服务于搜索引擎爬虫,确保其发现并索引网站URL。了解两者的优缺点有助于优化SEO工作。
XML 站点地图
XML使信息可被机器读取,为搜索引擎提供高效的URL列表。它本质上是使用标记标识数据类型的文本文件,通常位于域名根目录下(如www.example.com/sitemap.xml),供爬虫随时访问。
以下截图展示了蒂芙尼(Tiffany & Co.)的产品XML站点地图,包含4,829个产品URL及81,266行数据。
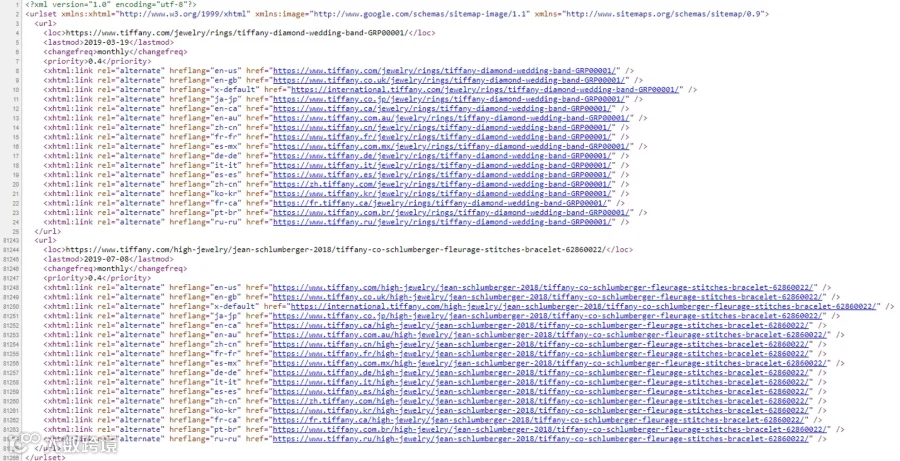
蒂芙尼(Tiffany & Co.)的产品XML网站地图,展示了两个产品的数据。点击图片放大。
该站点地图为每个产品URL提供了四类数据。以钻石婚戒URL https://www.tiffany.com/jewelry/rings/tiffany-diamond-wedding-band-GRP00001/为例:
- lastmod:URL内容最后更新日期。例如<lastmod>2019-03-19</lastmod>。
- changefreq:内容更新频率。例如<changefreq>monthly</changefreq>。
- priority:表示内容重要性的数值(0至1),最高值1通常仅用于首页和顶级着陆页。若所有页面均设为1,搜索引擎将忽略此字段。例如<priority>0.4</priority>。
- hreflang:标识其他语言版本的可选属性,也可包含在XML站点地图中。例如<xhtml:link rel="alternate" hreflang="en-gb" href="https://www.tiffany.co.uk/jewelry/rings/tiffany-diamond-wedding-band-GRP00001/" />。
爬虫访问网站时首先读取robots.txt文件,其中包含抓取指令及XML站点地图引用,从而引导爬虫获取URL列表。
XML站点地图遵循严格的标记规则,创建后应自动生成且无需人工干预。但需定期检查错误,因为过时、不准确或重复的URL出现频率较高。
XML站点地图存在以下限制:
- 不能保证被编入索引:XML站点地图仅推荐希望被抓取和索引的URL,搜索引擎明确表示可能不会索引甚至抓取每一个页面。
- 不传递链接权重:与HTML链接不同,XML站点地图中的URL不传递链接权重。若搜索引擎仅在XML站点地图中发现某URL,不太可能对其进行排名。
HTML 站点地图
与XML不同,HTML站点地图是格式化的链接集合,通常位于网页底部,向用户展示网站内容结构,其SEO价值相对有限。
在基于标题的下拉导航普及之前,HTML站点地图曾为爬虫提供快捷链接,有效传递链接权重并提升排名。如今,多数HTML站点地图仅复制页眉或页脚已有链接,少数网站仍将其作为主要导航。
如下方截图所示,Tiffany利用HTML站点地图链接那些能带来收入但无法通过常规导航访问的页面,从而增加其自然搜索可见度。
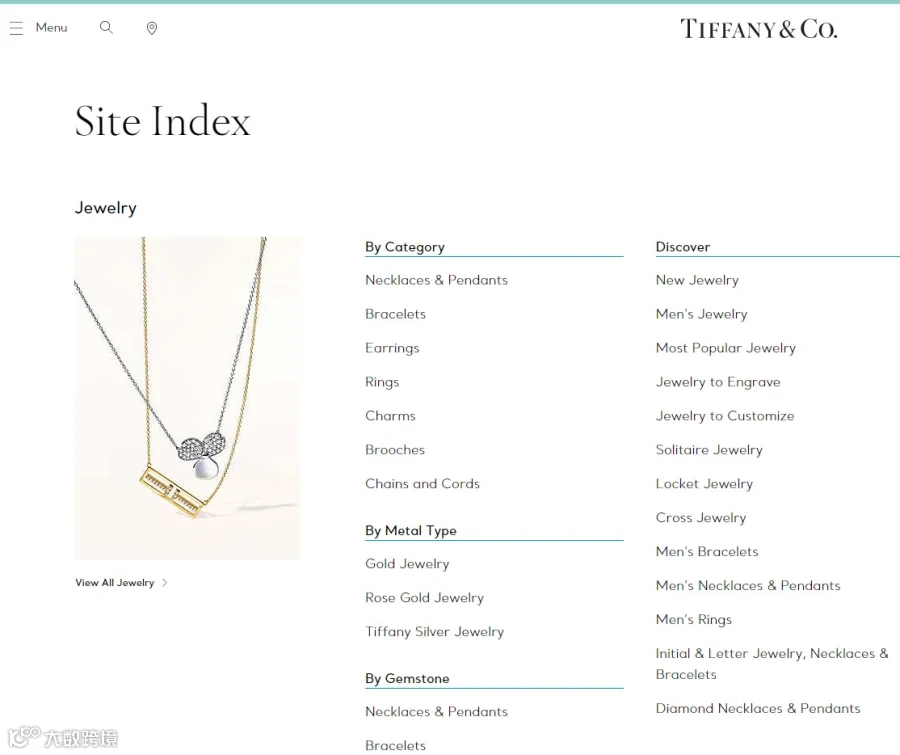
在其HTML站点地图中,Tiffany链接到了那些在站点页眉导航中没有位置的高价值页面。
HTML站点地图在以下特定情况下可增加SEO价值:
- 主站点导航未链接到所有页面。
- 部分导航或站点区域对搜索引擎不可访问。
- 某些重要页面在导航结构中埋藏过深,如FAQ页、支持页、节日活动页及文章页等。
- 分析数据显示访客正在使用HTML站点地图(此时应调查用户绕过主导航的原因)。
拥有HTML站点地图不会对SEO造成损害,它是一种有益的内部链接形式。但不应过度依赖:若希望某页面驱动自然搜索流量和转化,应将其纳入主站点导航。
流量驱动因素?
简而言之,HTML和XML站点地图各司其职,但均无法单独大幅提升自然搜索流量。要实现这一目标,关键在于优化导航结构,这将同时惠及访客和搜索引擎爬虫。