


不,在大多数情况下,不应让 Google 和其他搜索引擎索引您网站自身的搜索结果页面。
长期以来的搜索引擎优化(SEO)经验表明,应阻止搜索引擎爬虫抓取站内搜索结果页面,并将其排除在索引之外。其理由是为了避免让用户感到失望,并防止爬虫浪费时间在下载和分析那些对访客或业务无益的页面上。
用户体验
搜索引擎致力于提供优质的搜索体验,因此像 Google、Bing 和 DuckDuckGo 等平台会投入大量精力确保搜索结果准确无误。然而,来自您网站的内部搜索结果往往并非优质且相关的内容。
例如,假设用户在 Google 搜索“适合大体重跑者的最佳跑鞋是什么”,结果显示了一条指向您网站内部搜索结果的链接。但该被索引的页面实际上是针对“男士跑鞋”的产品列表,仅因其中包含一篇提及“大体重跑者”的博客文章而被关联索引。
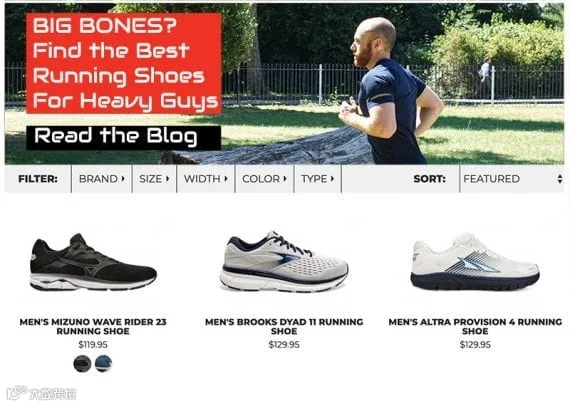
此类内部搜索结果页面通常不是理想的着陆页,因此不应被纳入索引。
这种结果对用户毫无帮助。用户需要点击两次——先在 Google 结果中点击一次,再在网站内部搜索结果中点击一次——才能获取所需信息。此外,访客可能误以为该页面展示的是特定功能的跑鞋列表,下单后却大失所望。
英国技术 SEO 专家 Matt Tutt 在 2018 年的一篇文章中举了一个更糟糕的例子。他指出,在线零售商 Wayfair 曾允许部分动态生成的搜索结果页面被索引。当时若在 Google 搜索带有特定敏感短语的“Wayfair.com”,可能会看到相关结果。由于 Wayfair 会动态向搜索页面描述中添加关键词,SERP 上显示的文案可能包含不当内容。
Tutt 指出,点击该链接后看到的页面文案同样存在问题。正如他所言,这类内容绝非一家家居家具提供商希望用户或搜索引擎发现的。
换言之,许多内部搜索结果页面是自动生成的,对于外部搜索引擎用户而言质量往往不佳。Wayfair 此后已更改其搜索结果机制,现在在该网站搜索特定关键词会返回“笔”(pens),而非原来的敏感词汇。
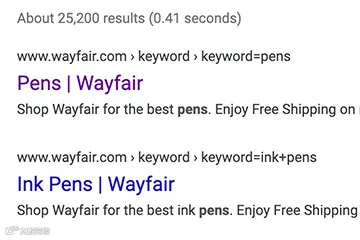
允许动态页面被索引意味着无法掌控向潜在客户展示的结果类型。
这不仅影响体验,Google 也可能不愿将此类内部搜索结果排名靠前。同时,这还在浪费 Googlebot 的爬取精力去抓取对业务帮助不大的页面。
迷失在细节中
Google 的 John Mueller 在 2018 年 4 月的 Webmaster Central Hangout 中表示:“对于内部搜索页面,有两个方面对我们很重要。一方面,如果我们试图抓取所有内部搜索页面,很容易陷入繁琐的细节中。如果网站上几乎任何单词都能导向一个内部搜索页面,而我们的系统认为那里可能有有用内容并尝试全部抓取,从爬取角度来看并非最优。”
Googlebot 为每个网站分配了有限的“爬取预算”。除了内部搜索结果外,您的网站上显然还有更多值得爬取的优质页面。
一个例外情况
Tutt、Mueller 等人提到可能存在一个例外:如果您使用网站内部搜索结果来生成分类页面。高级搜索平台(如 Twiggle、Algolia)可以生成产品类别或品牌页面,商家可配置平台使用同义词和反义词来提供或排除特定类别。
屏蔽搜索引擎
至少有两种方法可告知 Google 和其他搜索引擎不要索引内部搜索结果页面:一是在每个页面的头部使用 noindex 指令;二是在 robots.txt 文件中使用 disallow 规则。
在阐述为何应阻止内部搜索结果被索引后,我们回顾了 10 家领先电商网站的做法。2020 年 3 月 9 日,我们检查了各站点的 robots.txt 文件中是否存在 disallow 规则,并审查了站点搜索结果中的 noindex 指令。
| 站点 | Robots.txt 禁止 | noindex |
|---|---|---|
| 亚马逊 | 否 | 否 |
| Barnes & Noble | 是 | 是 |
| Bath & Body Works | 是 | 否 |
| Best Buy | 否 | 否 |
| GameStop | 是 | 是 |
| Home Depot | 是 | 否 |
| Lands' End | 是 | 否 |
| Sur La Table | 是 | 是 |
| Target | 是 | 是 |
| Walmart | 是 | 否 |
选择 Amazon、Walmart 和 Target 是因为其知名度较高;其余七家则是从关注的电商列表中随机挑选。请注意,Amazon 和 Best Buy 并未阻止外部搜索引擎索引其内部搜索结果页面,而其余八家则通过 Robots.txt 中的 disallow 或 noindex 指令进行了屏蔽。