


索引是自然搜索排名的前提,但并非所有页面都适合被收录。此时需借助“机器人排除协议”(REP)来精准控制搜索引擎爬虫的访问权限。
REP 是一套用于排除或允许爬虫抓取的技术工具集合,涵盖 robots.txt、XML 站点地图及元数据/标头指令等。需要注意的是,合规爬虫(如主流搜索引擎)会自愿遵守 REP,但恶意爬虫可能无视规则,此类情况需在服务器层面进行拦截。
REP 可以排除或包含搜索引擎爬虫。
该协议由 Martijn Koster 于 1994 年创立,Google 于 2019 年提议将其确立为正式互联网标准。各种 REP 方法各有优劣,可单独或组合使用以实现最佳爬取管理。
Robots.txt
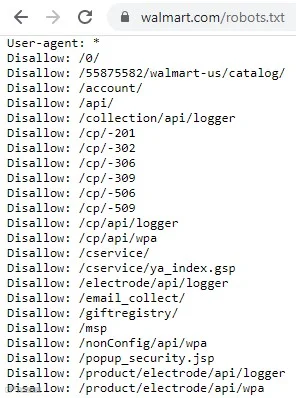
Walmart.com 的 robots.txt 文件“禁止”爬虫访问其网站的许多区域。
robots.txt 是优质爬虫访问网站时的首要目标,固定位于根目录(如 site.com/robots.txt)。它主要用于请求爬虫避开特定区域(如购物车、感谢页、用户资料页),也可在屏蔽区域内指定允许抓取的特定页面。
基础语法包含“用户代理”和“指令”。若希望全站开放索引,配置如下:
User-agent: *
Disallow:
其中星号代表所有爬虫,空白 Disallow 表示无禁止内容。若仅限制 Googlebot 索引全站,则配置为:
User-agent: googlebot
Disallow: /
也可针对特定目录设置例外,例如禁止 Bingbot 抓取 /user-account 目录但允许登录页:
User-agent: bingbot
Disallow: /user-account*
Allow: /user-account/log-in.htm
此外,当爬虫访问过快影响性能时,还可通过该文件请求延迟爬取。需注意,每个协议版本、域名及子域名均需独立的 robots.txt 文件。修改前务必使用 Google Search Console 测试工具验证语法,避免错误导致严重的搜索表现问题。详细语法规范可参考 Robotstxt.org。
XML 站点地图
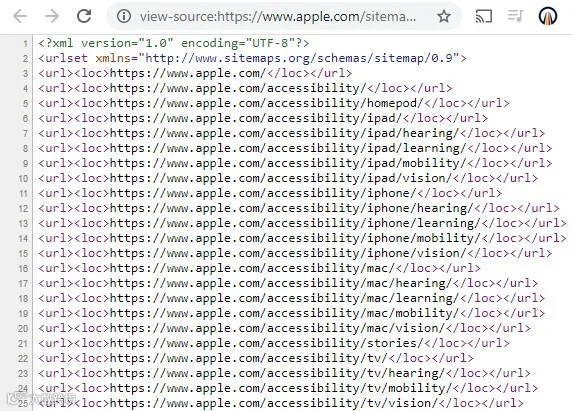
Apple.com 的 XML 站点地图包含 Apple 希望爬虫抓取页面的引用。
XML 站点地图用于向搜索引擎推荐重要页面,通常位于根目录(如 site.com/sitemap.xml)。除基本标签外,应包含 <url> 和 <loc> 标识待抓取 URL,还可补充最后修改日期、更新频率及优先级等信息。
维护站点地图需注意三点:仅链接规范 URL;尽可能自动化高频更新;单文件大小控制在 50MB 以内且 URL 不超过 5 万个。建议至少每季度检查一次准确性,避免包含旧链接或重复内容。
对于大型电商网站,可创建多个站点地图并通过索引文件链接(索引本身最多支持 5 万个站点地图)。同时支持 gzip 压缩以减小体积,并可纳入视频和图片以优化相关搜索排名。由于爬虫无法自动识别文件名,请务必在 robots.txt 中声明站点地图路径,并提交至 Google Search Console 及 Bing Webmaster Tools。
元数据和头部指令
相较于批量控制的 robots.txt 和站点地图,REP 元数据作用于页面级别,通过 HTML head 中的 meta 标签或 HTTP 响应头实现精细控制。
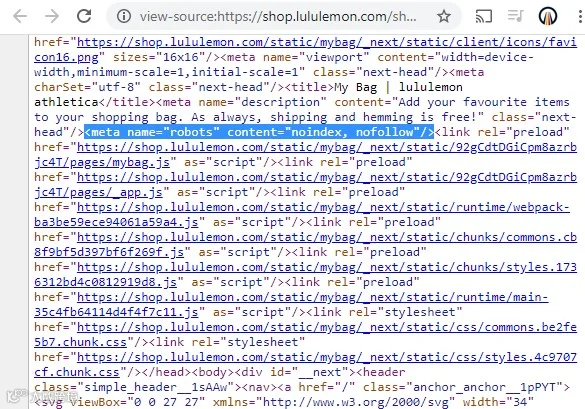
Lululemon 的购物车页面使用 robots 元标签来指示搜索引擎爬虫不要索引该页面,也不要通过其链接传递链接权重。
常用属性包括:Noindex(禁止索引)、Nofollow(不传递链接权重)、Follow(即使不索引也传递权重)。Meta 标签语法示例:
<meta name="robots" content="noindex, nofollow" />
该标签虽作用于单页,但可通过模板批量部署。锚标签中的 rel="nofollow" 同样可阻断权重传递:
<a href="/shopping-bag" rel="nofollow">Shopping Bag</a>
对于 PDF 等非 HTML 文件,需通过 HTTP 响应头发送指令:
X-Robots-Tag: noindex, nofollow
此方法可通过 .htaccess、httpd.conf 或 nginx.conf 等配置文件批量应用于特定文件类型或目录。完整属性列表及代码片段请参阅 Google 开发者文档。
特别注意:爬虫必须能访问文件才能读取 robots 指令。因此,元数据能有效防止索引,但无法节省抓取预算。若存在大量 noindex 页面,建议配合 robots.txt 的 Disallow 指令以阻止爬取。若需取消已索引内容的排名并限制后续抓取,应先使用 noindex 移除索引,再通过 robots.txt 禁止访问。