


Google 现要求使用支持 JavaScript 的浏览器才能查看搜索结果页内容,这实际上将自然排名列表对有机排名追踪器、AI 模型及其他优化工具进行了“隐藏”。
上月起,全球主流搜索引擎开始在搜索页面强制启用 JavaScript。Google 称此举旨在防范机器人及滥用行为,外界普遍认为这是对竞争性 AI 的隐性防御。
这一变动至少在以下三方面增加了 SEO 复杂度:
- 排名追踪
- 关键词研究
- AI 可见性
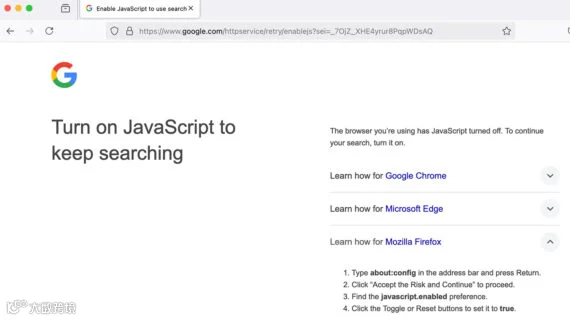
Google 搜索现已要求浏览器启用 JavaScript。
JavaScript 的影响机制
即便内容由 JavaScript 渲染,网络爬虫(如 Googlebot)仍可抓取并索引页面。但网页抓取机器人在获取 HTML 内容时,流程已发生显著变化。
传统静态抓取四步法:
- 请求:爬虫发送 HTTP GET 请求。
- 响应:服务器返回完整 HTML 内容。
- 解析:爬虫分析 HTML 并提取内容。
- 使用:数据存储或调用。
此前,Ahrefs、Semrush 等工具可直接爬取 SERP(如“男士跑鞋”关键词结果),解析 HTML 生成报告。而引入 JavaScript 后,流程变得更为复杂:
- 请求:发送 HTTP GET 请求。
- 响应:仅返回基础 HTML 骨架(如 <div id=”app”></div>)。
- 执行:需通过无头浏览器(Puppeteer/Playwright/Selenium)渲染 JS 以加载动态内容。
- 等待:等待 API 调用及数据更新完成。虽仅数毫秒,但会显著降低速度并增加成本。
- 解析:解析动态与静态混合的 HTML。
- 使用:数据存储或调用。
新增的“执行”与“等待”步骤需完整浏览器模拟,消耗大量 CPU 和内存。据估算,JS 渲染爬取的资源消耗是静态 HTML 抓取的 3-10 倍。
| 功能 | HTML 抓取 | JavaScript 抓取 |
|---|---|---|
| 初始响应 | 完整 HTML 内容 | 带占位符的最小化 HTML |
| JavaScript 执行 | 非必需 | 必需 |
| 工具 | Requests, BeautifulSoup, Scrapy | Puppeteer, Playwright, Selenium |
| 性能 | 更快、轻量级 | 更慢、资源密集 |
| 内容可用性 | 仅限静态内容 | 同时支持静态和动态内容 |
| 复杂度 | 低 | 高 |
需注意,Google 并非用 JS 渲染整个 SERP,而是要求访问者浏览器启用 JS,其实际影响等同。
由于爬取 SERP 的时间与资源差异巨大,除经验推测外,目前难以精准评估该新规对特定工具的具体冲击。
排名追踪成本激增
营销人员依赖有机排名工具监控目标关键词在 SERP 中的位置(含精选摘要、知识面板等)。Semrush、Ahrefs 等工具每月爬取数亿次 SERP,渲染动态页面的成本可能飙升 5 倍。
这对营销人员意味着:要么承担更高的工具费用,要么因爬取频率降低而导致数据准确性下降。
关键词研究精度受损
JS 限制可能导致高流量关键词识别不准且成本上升。SEO 专家 Kevin Indig 建议,若关键词数据可靠性降低,应转向关注页面级或域名级的流量指标来挖掘内容主题与缺口。
AI 模型抓取受阻
AI 模型常通过爬取 Google 结果来发现优质内容(例如为特定人群推荐跑鞋时访问 Top 10 网站)。如今,AI 也需耗费额外时间与算力解析 JS 驱动的 SERP,这可能削弱单纯依靠 Google 排名带来的“光环效应”。
应对策略:等待并适应
如同 Google 历次算法调整,营销人员需时间评估 JS 新规的实际影响。但可以确定的是,SEO 的游戏规则正在发生改变。