


我是赤辰,全网最早专注AI项目教程的公众号头部博主,本期是我们第288期原创内容。
家人们!论最近AI圈最大的热度,那得非Deepseek莫属。
这款“拳打GPT,脚踩谷歌公司”的中国AI黑马Deepseek,仅用十分之一的成本就达到了媲美OpenAI o1级别的表现,R1模型仅发布一周,就刷屏各大社交平台。
最牛X的是Deepseek-R1正式发布还开源了模型权重,这波操作真的太秀了。

直接把美国那边一群智力天花板给干懵了,买那么多的算力芯片,一下子变成大冤种了。
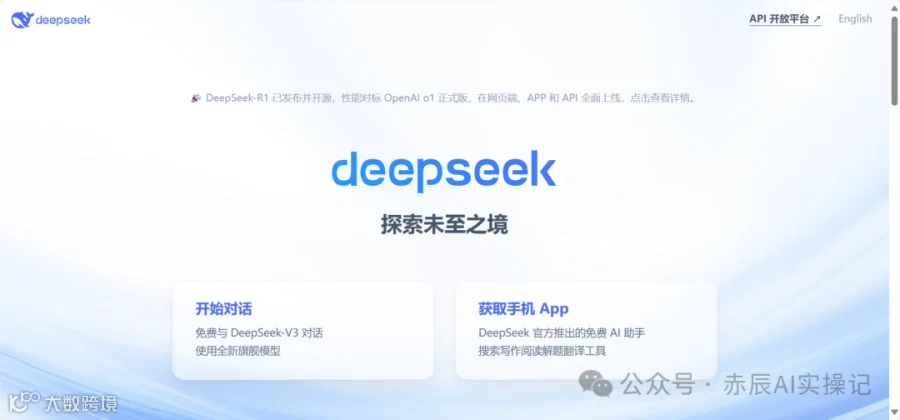
除此外,Deepseek与其他AI大模型相对,它几乎没有任何主动推广,却在多个市场实现了惊人的用户增长与渗透,美区APP Store效率分类中排名第五,中国区下载量直接冲上第二。
免费应用总榜上,美区第18,中国区第23,这成绩简直太惊人了,这波热度,让每一个人忍不住好奇。
Deepseek凭什么能成为顶流?
为了让大伙们更直白的看懂,俺决定从训练层到推理层极致的4大“性价比”详细聊聊。
(1)MLA
目前市面上主流的大模型都是MHA(Multi Head Attention)架构,这导致模型在训练时候要“记住”大量的参数。
而deepseek创新采用MLA(Multi-Latend Attention),大幅度压缩文本处理时候的内存需求,减少高达96%的资源消耗。
(2)数据处理
大模型的训练对数据集的质和量需求都是巨大的,DeepSeek通过Distillation蒸馏技术进一步压缩数据集。
同时训练时使用Quantization技术,使用FP8低精度的数据格式,进一步降低内存需求。
(3)MoE
就算我们没接触过MoE架构,也一定听说过混合专家这个名词,简单来说,MoE就是让模型的训练时只启动需要的结构和参数,大大降低了资源消耗。
(4)把算力价格打下来
DeepSeek V3每百万输入Token0.5/2¥,每百万输出Token8¥,妥妥性价比之王。
要知道Claude 3.5每百万输入3$,每百万输出居然高达15$,这么一对比,DeepSeek妥妥性价比之王!
显然,DeepSeek在资源和性能中间达到了一个平衡,而不是一昧的卷算力卷时长,这为整个大模型行业提供了一个新的思路!
国内用户如何使用DeepSeek?
国内用户可以直接手机应用商店上搜索“DeepSeek”,安装后即可免费登录使用,没有任何使用限制。

也可以在网页端搜索进入其官网,deepseek官网做的很简洁,提供了两个入口,可以点开始对话,开启对话框,就可以开始和deepseek对话啦,使用很简单,登陆就可以使用啦。

对话框底下有两个功能,一个是联网搜索功能,一个是最新的深度思考R1模型,适合推理强的问题处理。
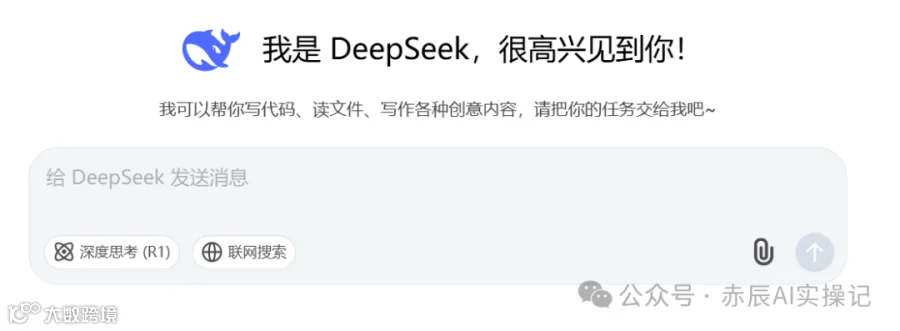
试试AI搜索能力,例如让他预测一下TIkTOK在美区是否能重新上线,点击联网搜索,就能搜索到46个国内外相关的网页,将信息进行处理后发生给我,响应速度非常快,而且内容准确度可以追溯到信息源头。

也可以同时开启深度思考+联网搜索功能,生成的内容会更加有深度些。
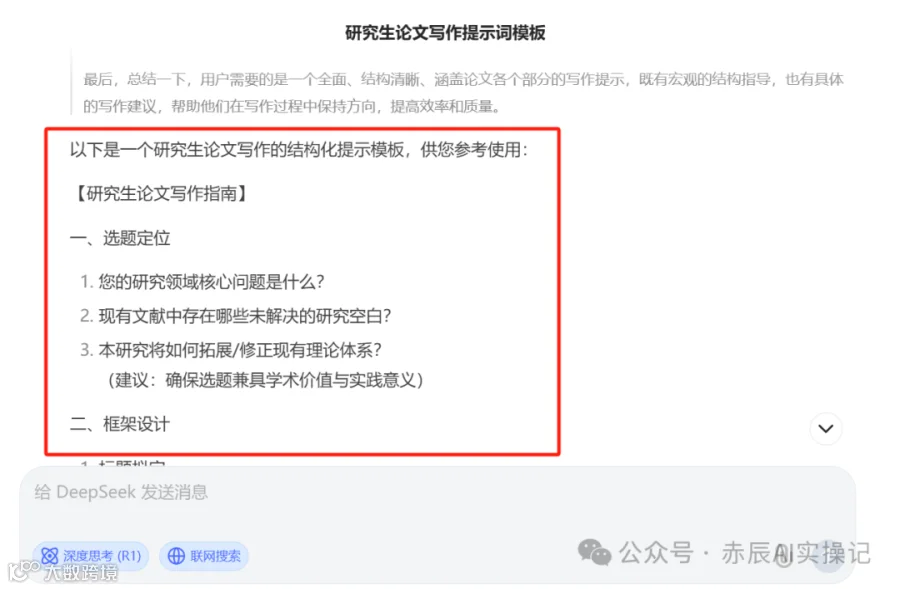
例如让它帮我输出一个关于研究生论文的写作提示词。

它会先进行深度思考8秒后,会再给出结构化提示模版,与以往AI搜索工具不同的是,会更符合国人的逻辑思维,更懂中文任务的处理。
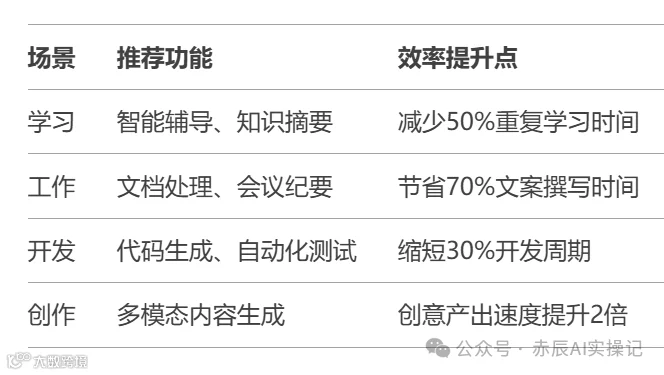
那DeepSeek那么强悍,普通用户如何有效使用这个工具,这里我也向DeepSeek提问,最终它整理出来的4个应用场景,个人觉得还是蛮全面。
好啦,以上就是本期分享的所有内容,DeepSeek作为开源模型中的“性价比之王”,值得大家深度体验,相信你也会对它“爱不释手”。。
学会了或有启发,别忘了给赤辰点赞,在看,转发收藏,~避免下期找不到或接收不到推送,爱大家!
光合AI实战圈最新项目活动:AI梗图变现实战项目(已开营),其它更多项目也在进行中..可下方扫码咨询
团队使命:加速推动AI商业化时代到来! 带更多人用AI深耕有社会价值的项目!
侵权追责:所写的AI项目案例和专业教程均为光合AI团队全网原创首发,洗稿侵权必究!
往期优质原创内容推荐:
100%完全免费、无限制的AI图像生成器——Raphael AI
全部免费!用AI做国风飞仙创意大片,涨粉1.9万
18条笔记涨粉5.6万,用AI做梗图,真的杀疯了!
END
