


大家好,我是bug菌~
想象一下,你正在教一个三岁小朋友认识什么是猫。这个过程,恰好揭示了人工智能领域最神奇的技术——神经网络的核心原理。
一个孩子的认猫课
第一步:准备学习材料
你的爸妈给你看了很多图片,每张图片上都告诉你这是不是猫。
-
输入:一张图片(包含各种特征:尖耳朵、圆眼睛、胡须、毛茸茸、尾巴等) -
期望输出:一个简单的答案——“是猫”或“不是猫”
这就是神经网络的训练数据——有输入有标准答案,是学习的基础。
第二步:大脑的初步判断
刚开始,你完全不知道什么特征重要。你可能会瞎猜:
-
“有毛的就是猫!”(于是你把毛绒玩具也当成了猫) -
“会动的东西就是猫!”(于是小狗跑过去你也叫猫) -
“有尾巴的就是猫!”(于是猴子你也觉得是猫)
在这个阶段,你对每个特征都赋予了一个 “瞎蒙的重要性”,这个重要性在神经网络里就叫“权重”。

神经元就是你大脑里的“判断小细胞”,它负责接收信息,然后根据自己的“权重”做出微小判断。一开始,这些权重都是乱设的。
第三步:综合决策并犯错
现在,给你看一张兔子的图片。
-
输入:兔子(有毛、红眼睛、长耳朵、短尾巴) -
你的大脑开始工作: -
神经元A:“有毛!+10分!” -
神经元B:“红眼睛?-5分!” -
神经元C:“长耳朵?没见过,+0分吧” -
...把所有神经元的分数加起来 -
输出:总分数超过了你的“判断门槛”,你大喊一声:“是猫!” -
结果:你爸妈说:“错!这是兔子!”
这个“错”的信号,就是**“误差”或“损失”**。
第四步:吸取教训,调整思路
你知道自己错了,就会开始反思:
-
“哦,原来光有毛不行,‘有毛’这个特征的权重我得调低一点” -
“红眼睛好像不是猫的特征,下次看到要大胆地扣分” -
“长耳朵似乎是兔子的标志,以后看到要特别注意”
这个根据错误结果,反过来调整每个特征“权重”的过程,就是神经网络最核心的学习机制——反向传播。
第五步:重复学习,越来越准
你爸妈不断地给你看新的图片(猫、狗、狮子、老虎……),你每次都会:判断 → 犯错 → 调整权重 → 再判断。
经过成百上千次的练习后,你大脑里的“权重”被调整得越来越精准:
-
“尖耳朵+圆眼睛”权重很高 -
“脸型是三角形”权重很高 -
“有胡须”权重很高 -
“体型大小适中”权重也很高
最终,你形成了一套非常复杂的、综合性的判断标准。现在即使看到一只你从来没见过的品种的猫,你也能综合这些特征,大概率准确地认出它是一只猫。
现在,我们把整个故事对应到神经网络的术语上:
-
神经网络 = 一个虚拟的大脑或决策系统 -
神经元 = 大脑中的一个判断小单元 -
输入层 = 你的眼睛和耳朵(接收原始信息) -
隐藏层 = 你大脑里进行复杂思考、综合判断的过程 -
输出层 = 你最终说出的答案 -
权重 = 你对每个特征的重视程度 -
前向传播 = 从“看到图片”到“说出答案”的整个思考过程 -
误差/损失 = 你的答案和正确答案的差距 -
反向传播 = **“吸取教训”**的过程 -
迭代训练 = **“大量练习”**的过程
理解了这套机制,你就会明白:现在的AI为什么能够识别人脸、听懂语音、翻译语言、甚至开车下棋。
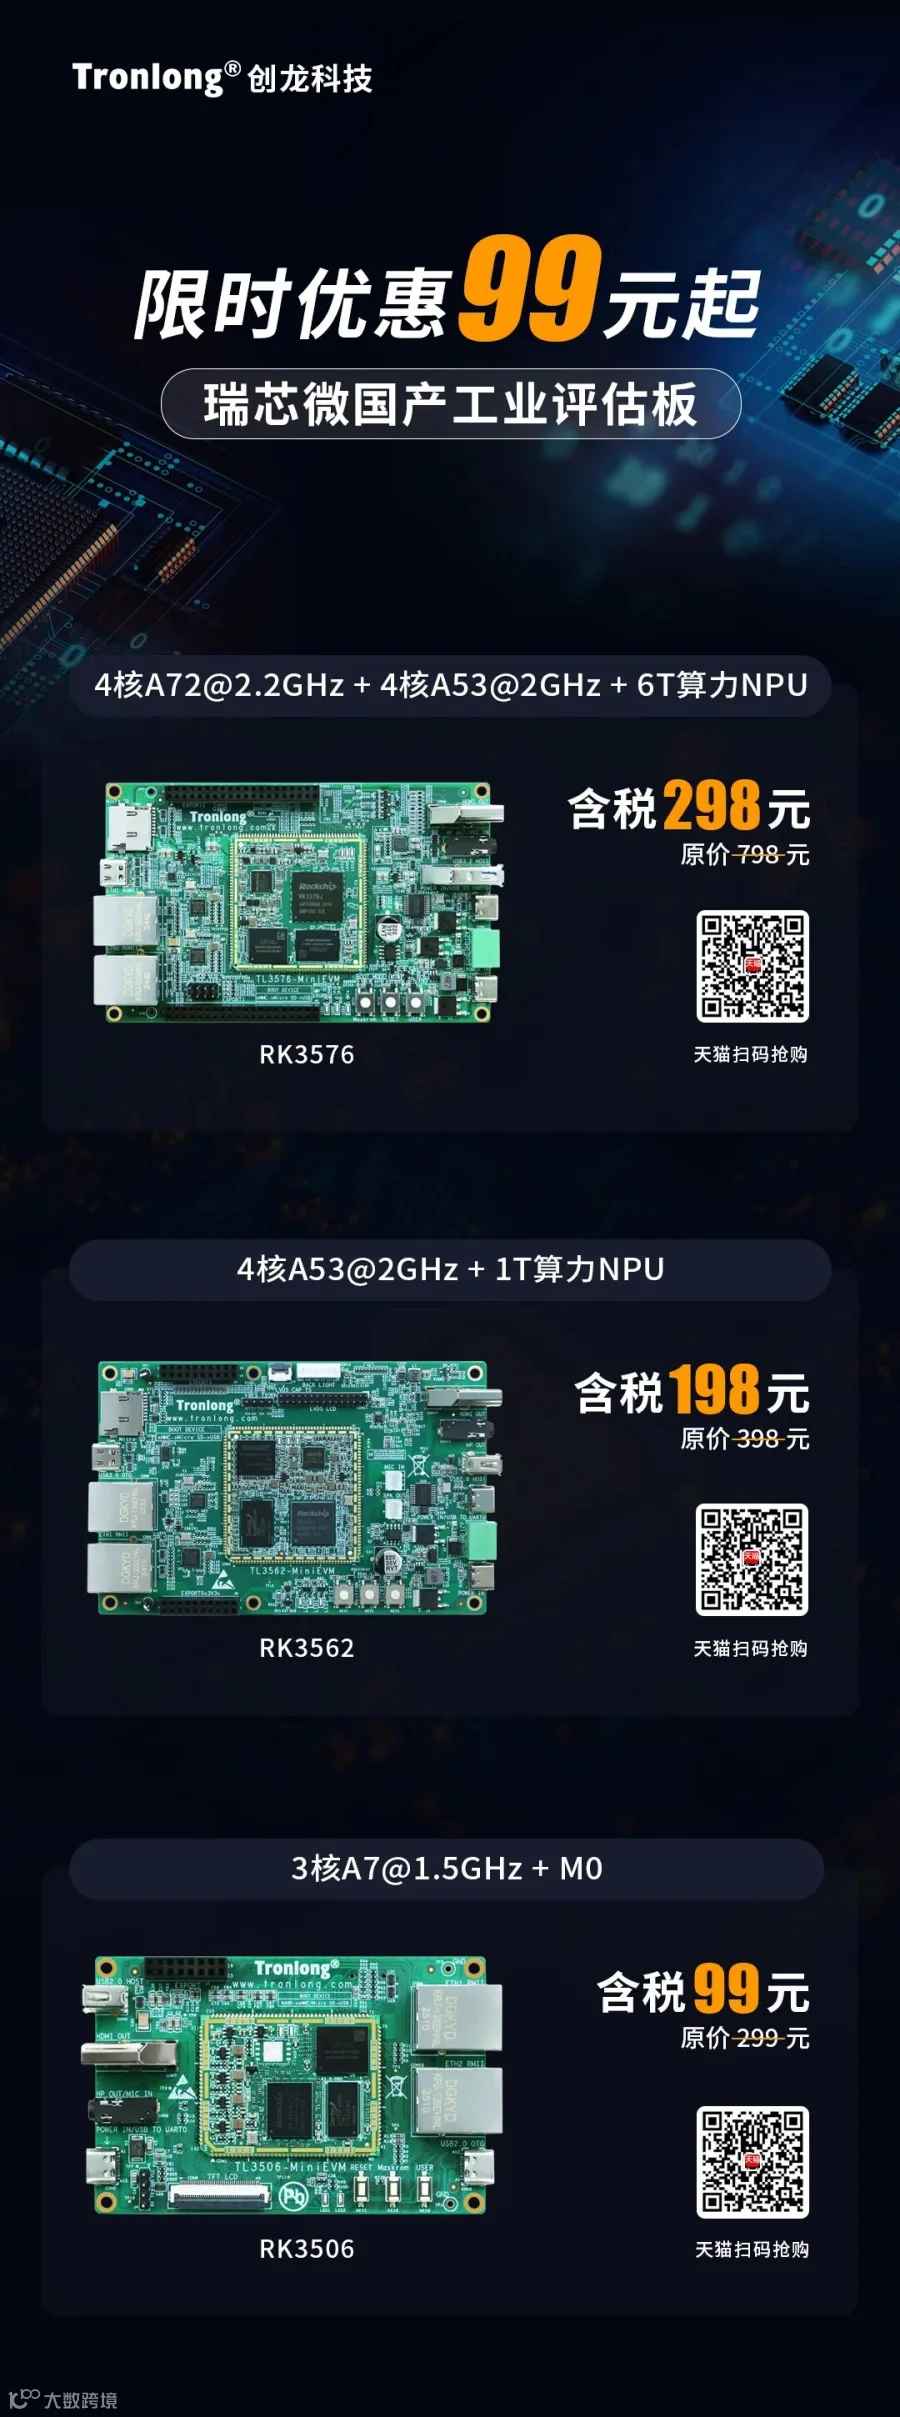
有没有同学在RK系列开发板上跑起来AI小模型或者其它AI算法,这里给大家推荐下创龙科技的开发板,RK3576带6T算力NPU,现优惠价298元(原价798元),性价比非常高。
它们都不是靠程序员编写C语言那样的if-else“如果...就...”的规则(那样太复杂且不可能完成),而是通过“大量练习 → 犯错 → 吸取教训”来不断优化内部判断标准,最终学会完成复杂任务。
神经网络不是一个写好的程序,而是一个“练出来”的技能。就像人类的学习一样,在试错中成长,在经验中完善。
这就是人工智能的本质:用计算机模拟人类学习的过程,让机器获得类似人类的学习能力。
最后
好了,今天就跟大家分享这么多了,如果你觉得有所收获,一定记得点个赞~