


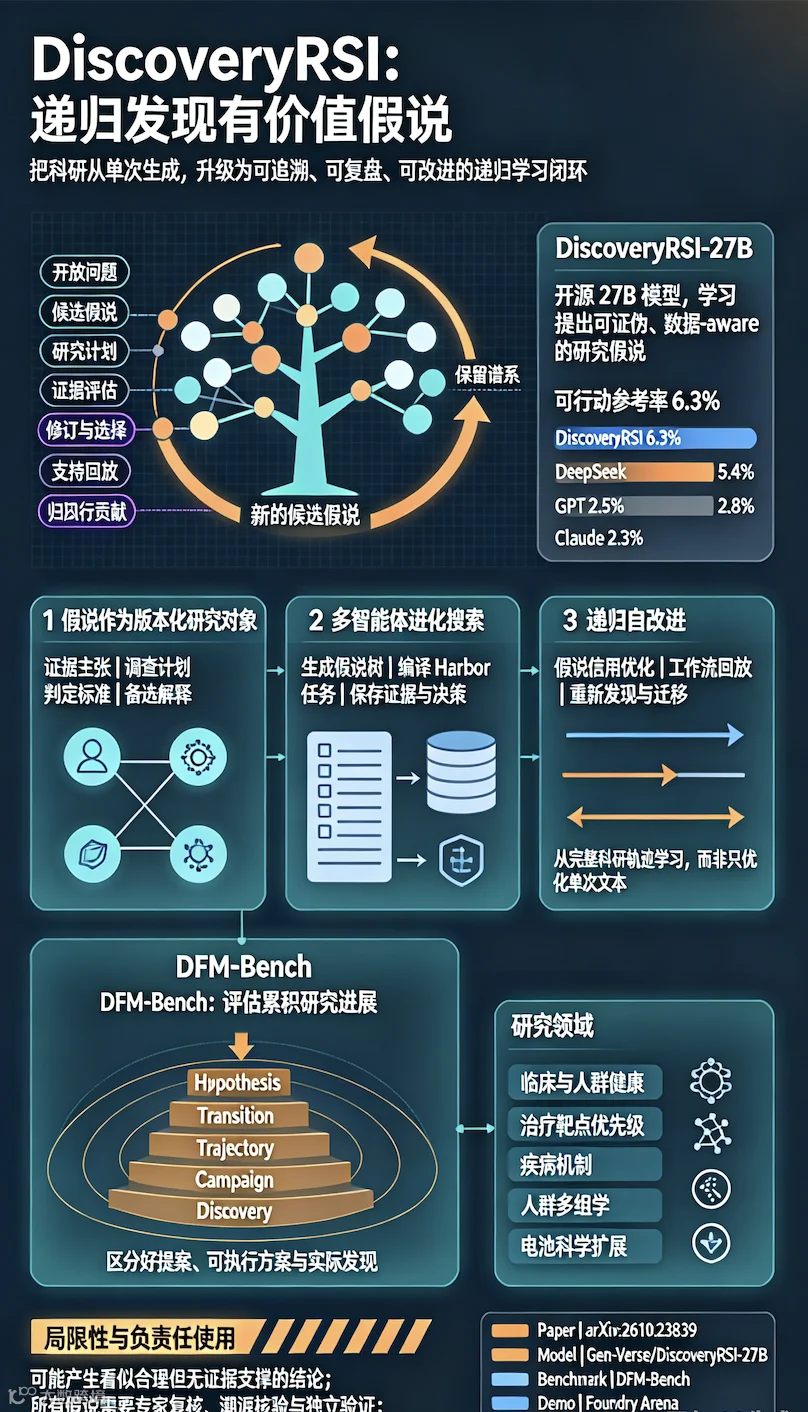
编者摘要:DiscoveryRSI(Gen-Verse 团队,arXiv:2610.23839)是一套面向科学假说自动发现的递归自改进科研智能体全栈开源框架,核心目标不是撰写论文综述,而是自主生成具备可证伪性、完整实验方案、证据溯源和备选解释的科研假说,并在迭代科研轨迹中持续自我优化。项目配套开源 27B 基础模型 DiscoveryRSI-27B、DFM-Bench 过程式评测基准、可可视化演示 Arena 与完整本地部署代码,是当前少有的完整开放科研智能体工程体系。
该框架重构了大模型辅助科研的范式。传统科研大模型多是单次文本生成,仅输出独立结论;DiscoveryRSI 将假说定义为带版本的科研对象,构建假说树记录假说演化、修订、交叉衍生谱系。依托多智能体进化搜索筛选候选假说,通过 Harbor 模块将调研方案编译为可执行计算任务;创新提出假说信用优化(Hypothesis Credit Optimization),把奖励信号拆解到增加对照组、完善测量指标、修复证伪规则等科研动作,而非简单对最终文本打分。对比基座模型,该训练方式可多产出 16.7% 独特假说,可成功编译的实验任务提升 50%。
配套的 DFM-Bench 是其核心创新点。现有科研基准大多只评估单次输出文本质量,DFM-Bench 从假说、状态转换、演化轨迹、完整科研任务、科学发现五个层级,评估累积式科研全过程。基准主场景为生命科学,覆盖人群健康、疾病机制、药物靶点、多组学研究,同时扩展电池电化学领域评测套件。评测能区分 “文笔优美的假说文本” 和能够持续迭代产出有效发现的科研流程。
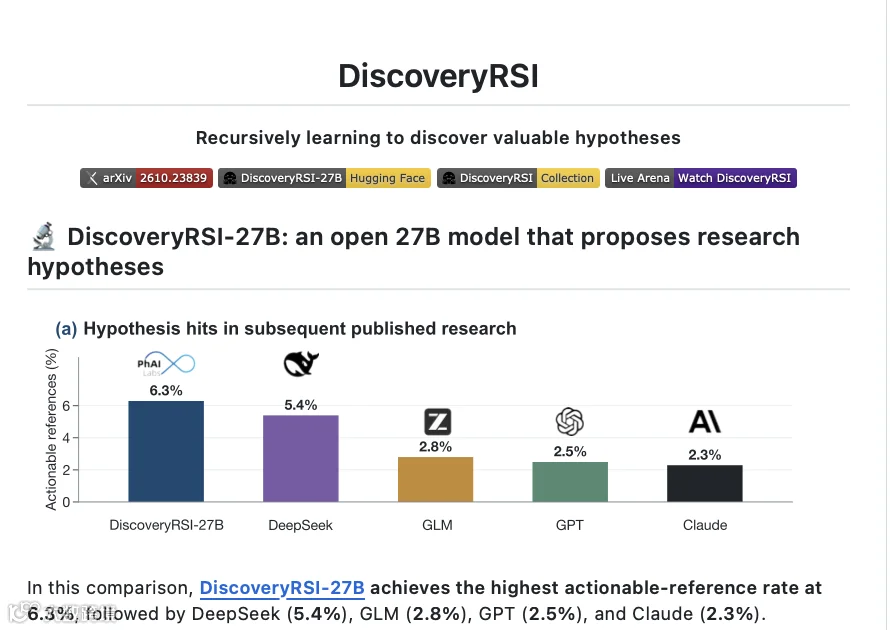
实测指标上,DiscoveryRSI-27B 可行动参考率达 6.3%,高于 DeepSeek、GLM、GPT、Claude,代表模型提出前瞻性假说、与后续真实发表成果吻合的能力。系统自带回放机制,复盘工具调用失败、上下文丢失、重复发现等问题,持续优化智能体协作策略。框架解耦模型与工作流,底层模型可替换,兼容所有 OpenAI 兼容接口。
项目仍存在明确局限:模型会生成看似合理但缺乏证据支撑的猜想,可能误读文献、提出不可落地实验。所有假说必须由领域专家审核、溯源核验与独立实验验证,不可直接用于临床等高风险决策。整体来看,DiscoveryRSI 的最大贡献在于把科研智能体的重心从单次文本生成,转向可追溯、可迭代、可评估的完整科研闭环,为 AI 辅助基础科学探索提供了一套开源可复现的工程范式。
横向对比表:DiscoveryRSI / AlphaEvolve / ScienceAgent / Dream-RSI
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
10个关键问题Q&A
-
Q:DiscoveryRSI 是用来写论文的吗? A:不是。目标是生成可检验的科研假说 + 实验方案,是科研前期假设生成智能体,不是论文写作模型。 -
Q:RSI 在这里是什么含义? A:Recursively Self-Improvement,递归自改进;系统跑完一轮科研,从轨迹学到经验,优化模型与工作流,再做下一轮科研,循环提升假说产出质量。 -
Q:6.3% 这个指标代表什么? A:模型提出假说,和模型知识截止之后真实发表论文结论吻合的比例,衡量前瞻性科学猜想能力,不是普通文献总结。 -
Q:DFM-Bench 为什么重要? A:传统 benchmark 只打分单次输出;DFM-Bench 看假说迭代改进的全过程,区分单次 “好句子” 和长期能产出发现的科研流程。 -
Q:能不能替换底层大模型,不用 27B? A:可以。框架支持 OpenAI 兼容适配器,接入 Claude Code、DeepSeek 等任意模型,27B 只是推荐配套模型。 -
Q:Harbor 是什么? A:框架内部组件,把自然语言的调研计划编译成可执行的计算任务,让假说可以被自动化工具验证。 -
Q:假说 Credit Optimization 和普通 RL 有什么不同? A:普通 RL 给最终结果打分;该方法把分数拆解到每一步科研贡献动作,比如补充对照、明确测量标准,让模型学习科研方法论,而不是单纯模仿论文文本。 -
Q:Foundry Arena 能做什么? A:可视化实时科研循环;观察假说树生长、不同模型 PK、候选假说、编译实验、整个科研轨迹动态更新,方便审计智能体思考过程。 -
Q:这个系统能直接做湿实验吗? A:不能。只产出计算层面可执行的调研任务,不连接真实实验室硬件,湿实验依然需要人类科研人员独立验证。 -
Q:许可证是什么? A:项目代码 Apache 2.0;模型权重、基座模型、数据集单独协议,需要看 HuggingFace model card。

概括:DiscoveryRSI 是一套面向科学假说自动发现的递归自改进(RSI)智能体框架,配套开源 27B 大模型 DiscoveryRSI-27B + 全新科研过程评测基准 DFM-Bench;不再只让 LLM “写论文摘要”,而是生成可证伪、带实验方案、有溯源谱系的科研假说树,并且从完整科研轨迹里持续自我优化
一、核心范式:把科研变成以假说为中心的递归学习
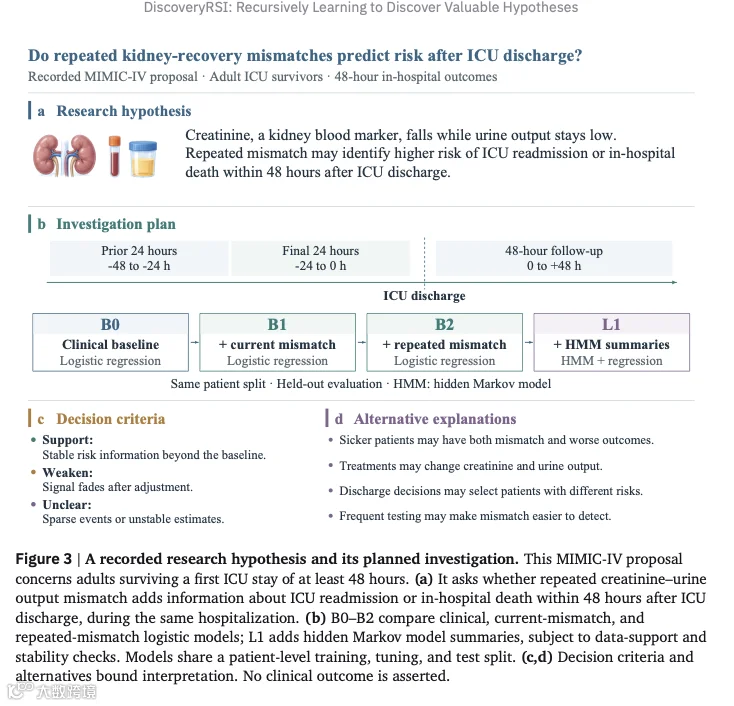
传统科研 LLM 大多是一次性生成文本;DiscoveryRSI 把假说定义为一个带版本的科研对象,一个合格假说必须包含:
-
基于证据的科学主张 -
可落地的调查 / 实验方案 -
明确判定标准(什么结果能证实 / 证伪) -
备选解释(控制其他可能性)
系统运行流程:
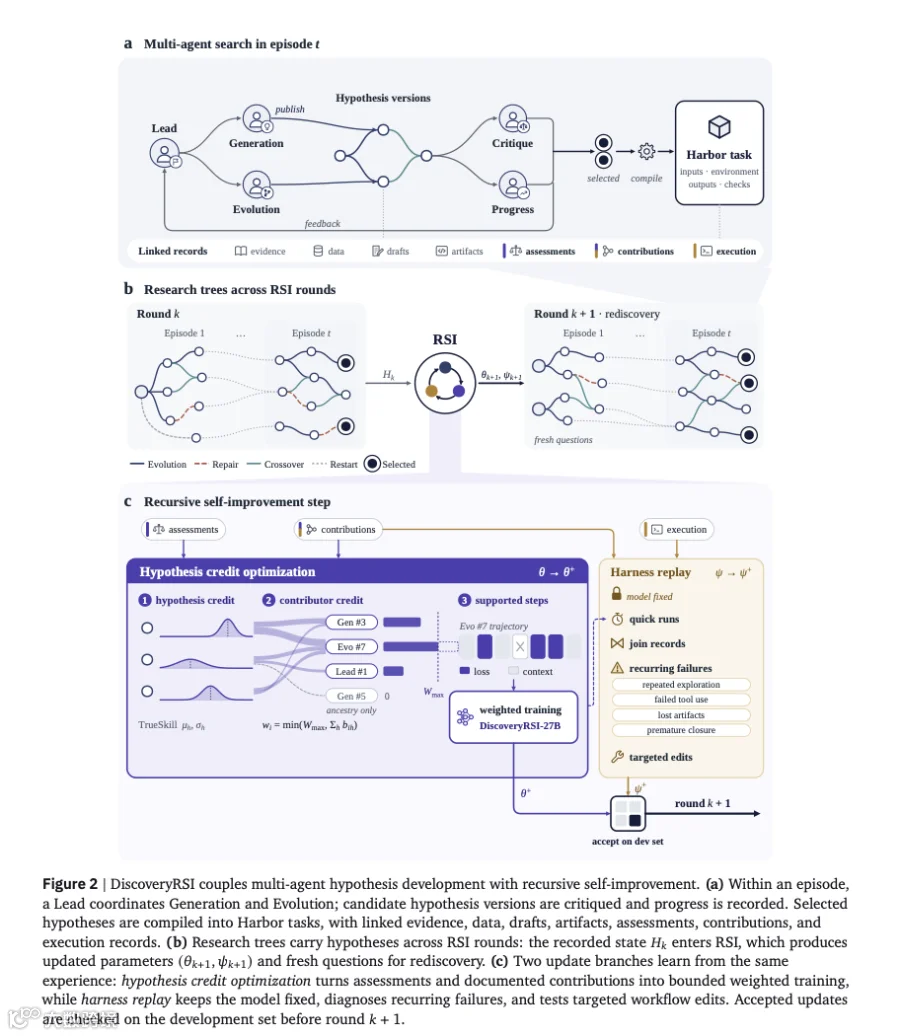
- 多智能体进化搜索
生成假说树(hypothesis tree),记录每一条假说的父代、修订历史、来源证据; - Harbor 任务编译
把选中的调研方案编译成可执行计算任务; - 三层递归自改进机制(RSI 核心)
- 假说信用优化 Hypothesis Credit Optimization
把科研质量打分,归因到具体贡献动作(找到新证据、增加对照组、完善测量规则、修复证伪逻辑),以此作为训练信号,训练 DiscoveryRSI-27B;相比基座模型,可多选 16.7% 独特假说,可成功编译的 Harbor 任务提升 50%; - Harness Replay 回放
复盘历史运行轨迹,识别有效策略与反复踩坑的失败模式,优化智能体协作、证据检索策略; - 重新发现 Rediscovery
:把验证有效的模型 / 工作流改进,放到全新科研问题上跑,产出更多新经验,持续迭代闭环
二、模型:DiscoveryRSI-27B
-
参数量:27B,开源权重在 Huggingface Gen-Verse/DiscoveryRSI-27B -
核心指标(可行动参考率,即假说与模型截断之后真实发表论文吻合度) -
DiscoveryRSI-27B:6.3% -
DeepSeek:5.4% -
GLM:2.8% -
GPT:2.5% -
Claude:2.3%
说明:这个指标衡量模型提出的假说,有多少在模型知识截止期之后,被真实科研论文验证,代表提出前瞻性有效假说能力,不是普通问答 / 论文总结能力。 自改进两轮后,假说质量得分由基座模型 4.86 提升至 5.39,提升主要来自可证伪性、数据可判定性两项。
三、评测基准 DFM-Bench(重点创新)
现有科研基准大多只评价单条回答文本;DFM-Bench 评估完整累积科研过程,5 层评估维度:
-
Hypothesis 单条假说质量 -
Transition:假说修订,对比上一版本改进点 -
Trajectory:整条科研演化路径 -
Campaign:完整一轮科研任务 -
Discovery:最终科学贡献
领域:主基准为生命科学(临床与人群健康、药物靶点筛选、疾病机制、多组学);额外扩展电池科学分支(电化学、材料衰减、传感、状态估计)。
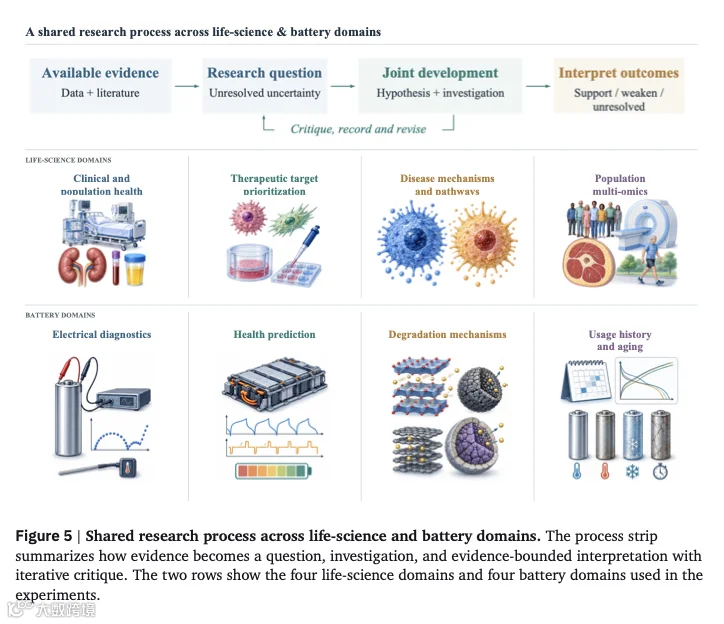

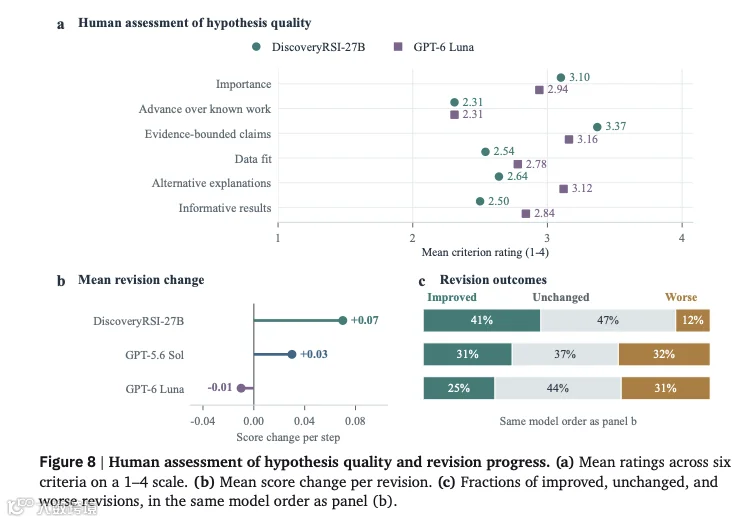

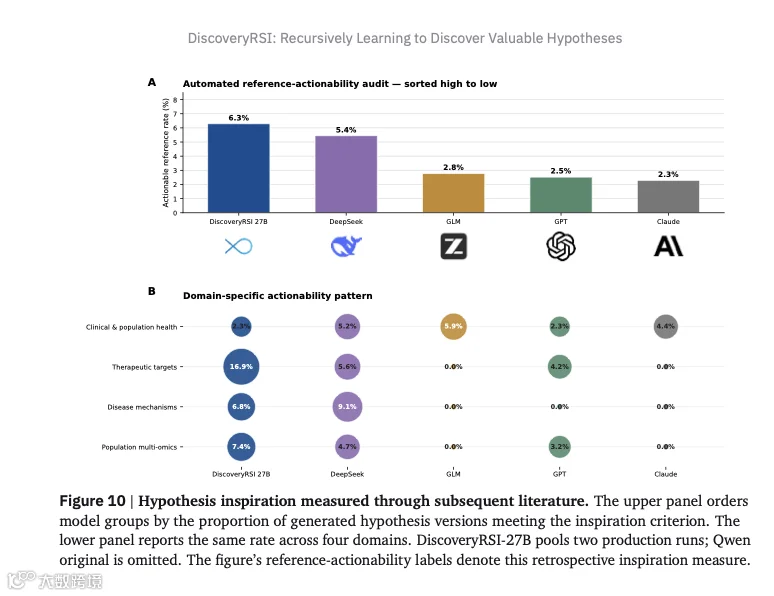
关键区分:区分 “写得好看的假说” vs “能持续产出有效发现的科研过程”;区分可执行方案 vs 已经被科学验证的结论。
四、系统架构与开源资源
开源组件(Apache2.0 协议,代码)
-
智能体核心 harness、模型适配器、角色提示词、工具注册表、回放存储、任务清单、领域适配器 -
数据集:DiscoveryRSI-Hypothesis-Task-Examples,Huggingface 数据集 -
Demo Arena:Foundry Arena,可视化实时科研闭环,可看假说树演化、模型对战、实验编译过程
地址:https://foundry-arena.rsi-arena.workers.dev/arena
快速部署流程
git clone https://github.com/Gen-Verse/DiscoveryRSI.git
cd DiscoveryRSI
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -e .

# 本地确定性demo
discovery-rsi demo --iterations 2
pytest

# vLLM部署模型,OpenAI兼容接口
export MODEL_ID=Gen-Verse/DiscoveryRSI-27B
vllm serve "$MODEL_ID" --served-model-name discoveryrsi-27b

# 另一个终端启动科研任务campaign
export DISCOVERY_RSI_BASE_URL=http://localhost:8000/v1
export DISCOVERY_RSI_MODEL=discoveryrsi-27b
export DISCOVERY_RSI_API_KEY=local
discovery-rsi campaign \
  --adapter openai-compatible \
  --manifest configs/research_manifest.json \
  --roles plugins/discovery-rsi/roles \
  --iterations 3 \
  --replay episodes.jsonl
适配器支持任意 OpenAI 兼容接口,可接入 Codex、Claude Code 等其他模型,不绑定自家 27B 模型。
五、适用领域与边界限制
✅ 主攻:生命科学(临床人群健康、疾病机制、治疗靶点优先级、人群多组学,基于 GEO 通路 / 靶点数据);电池材料电化学(扩展) ❌ 不内置:患者原始数据、HCC、UK Biobank 私有数据、实验室硬件。
⚠️ 重要局限(负责任使用声明)
-
会生成看似合理但无证据支撑的结论,遗漏文献,误读资料,提出不可行实验; -
所有假说必须领域专家人工复核、溯源核验、独立实验验证; - 不能作为医疗设备,不可直接用于临床等高风险决策
。
六、与同类科研智能体的核心差异
-
评价对象从文本生成结果升级到整条科研迭代轨迹,DFM-Bench 专门评估累积科研进展; -
训练信号不是简单 RL 奖励,而是科研贡献归因(Hypothesis Credit),把奖励绑定到 “增加对照组、完善测量” 这类科研动作; -
保留完整谱系:假说的演化、修复、交叉衍生、重启全部可追溯,支持回放失败案例、上下文丢失、重复发现; -
开源全栈:框架、benchmark、模型权重、示例数据集、可视化 Arena 全部公开,本地可完整跑科研闭环,不是只能看网页 Demo。
七、思维导图(文本版)
DiscoveryRSI
├─ 定位:递归自改进RSI科学假说发现框架
├─ 核心机制
│  ├─ 多智能体进化搜索 → 假说树(带版本、谱系、备选解释)
│  ├─ Harbor任务编译:假说→可执行计算实验
│  └─ 三大RSI学习机制
│     ├─ Hypothesis Credit Optimization:贡献归因训练模型
│     ├─ Harness Replay:复盘失败与有效策略
│     └─ Rediscovery:迁移改进到新科研任务
├─ DiscoveryRSI-27B模型
│  ├─ 27B开源权重
│  └─ 6.3%可行动假说率,超过DeepSeek/GPT/Claude
├─ DFM-Bench 五层评估基准
│  ├─ Hypothesis / Transition / Trajectory / Campaign / Discovery
│  └─ 生命科学 + 电池科学扩展
├─ 开源资源
│  ├─ Apache2.0代码库
│  ├─ HuggingFace模型、数据集
│  └─ Foundry Arena可视化演示
├─ 工作流能力:生成可证伪方案、保留修订谱系、回放失败、评估完整科研路径
├─ 适用领域:生命科学、多组学、电池电化学
└─ 约束:假说需专家核验,禁止直接临床决策