


10 个关键问题Q&A
-
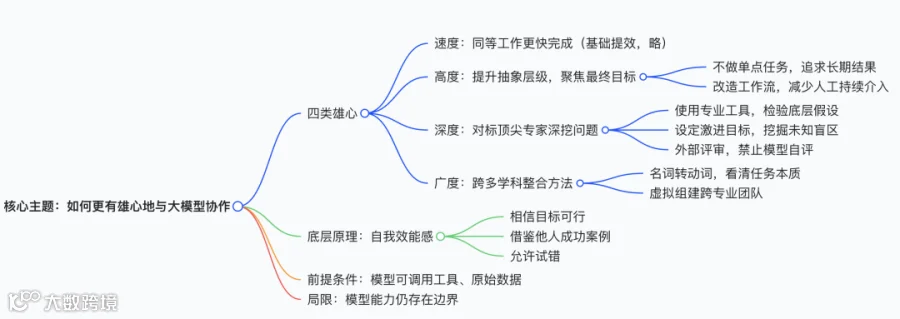
Q:作者提出的四类 “雄心” 分别是什么? A:速度、高度、深度、广度;文章重点讲解高度、深度、广度。 -
Q:什么是 “高度” 层面的雄心? A:跳出零散操作任务,提升抽象层级,聚焦最终目标,搭建自动化长效工作流。 -
Q:深度维度使用 AI 的核心要点是什么? A:对标领域专家,使用专业工具,校验固有假设,挖掘数据盲区,引入外部验证。 -
Q:广度维度如何落地? A:把任务名词转为动词理解本质,虚拟组建跨学科团队,调用多领域分析方法。 -
Q:为什么不建议让模型自行评判输出结果? A:2026 年当下模型存在局限,模型自评容易失真,需要外部工具或第三方校验。 -
Q:想要实现高阶 AI 协作,需要什么基础条件? A:模型能够安装软件、访问原始数据,可通过 MCP 等协议对接外部工具。 -
Q:文章提到的心理学概念 “自我效能感” 指什么? A:个体对自身完成任务能力的信心;信心越强,越容易完成高难度工作。 -
Q:作者举历史案例想证明什么? A:人的能力上限常常被 “这件事不可能” 的固有认知束缚,突破认知就能实现突破。 -
Q:高度思路适合哪类场景?哪些场景效果一般? A:适合业务目标类、需要开会决策的工作;在纯创意创作场景效果有限。 -
Q:高阶使用大模型,只靠优化提示词就够了吗? A:不够,往往需要改造整套工作流程,开放数据、环境权限给模型。

发布时间:2026 年 10 月 13 日
我从事 Claude 相关工作。这段经历很奇妙:几乎每天,我都会听说有人借助 Claude 完成了某件新壮举 —— 那些我从未设想、本以为不可能,或是单纯缺少好奇心与时间去尝试的事。就在本月,Claude 或许助力一位业余天文学家发现了一颗新行星;我看到了首部由 AI 制作的音乐视频;我们也在讨论陶哲轩提出的 “数学 2.0”。
大模型能力的增长并非均匀同步。正如陶哲轩所说:模型 “在某些领域能力惊人,在另一些方面却仍有不足”。一部分人能驾驭模型那些惊人的能力,仿佛展翅高飞;看着人们用我们打造的产品攀上难以置信的高度,实在令人着迷。但还有很多人,仍在努力适应这双新翅膀,困惑除了问 “法国的首都是哪里” 或者 “能不能把这封邮件改得语气平和一点” 之外,AI 还能用来做什么。
我经常和其他 AI 从业者一起呼吁:我们在使用 AI 时,应当更加大胆进取。这句话已经成了我们的口号。每当看到惊艳的成果,我们就会转发并感慨:“我们的想象力还不够。” 我深知践行这条建议并不容易,因此写下这份指南,教大家如何更有雄心地使用大模型。
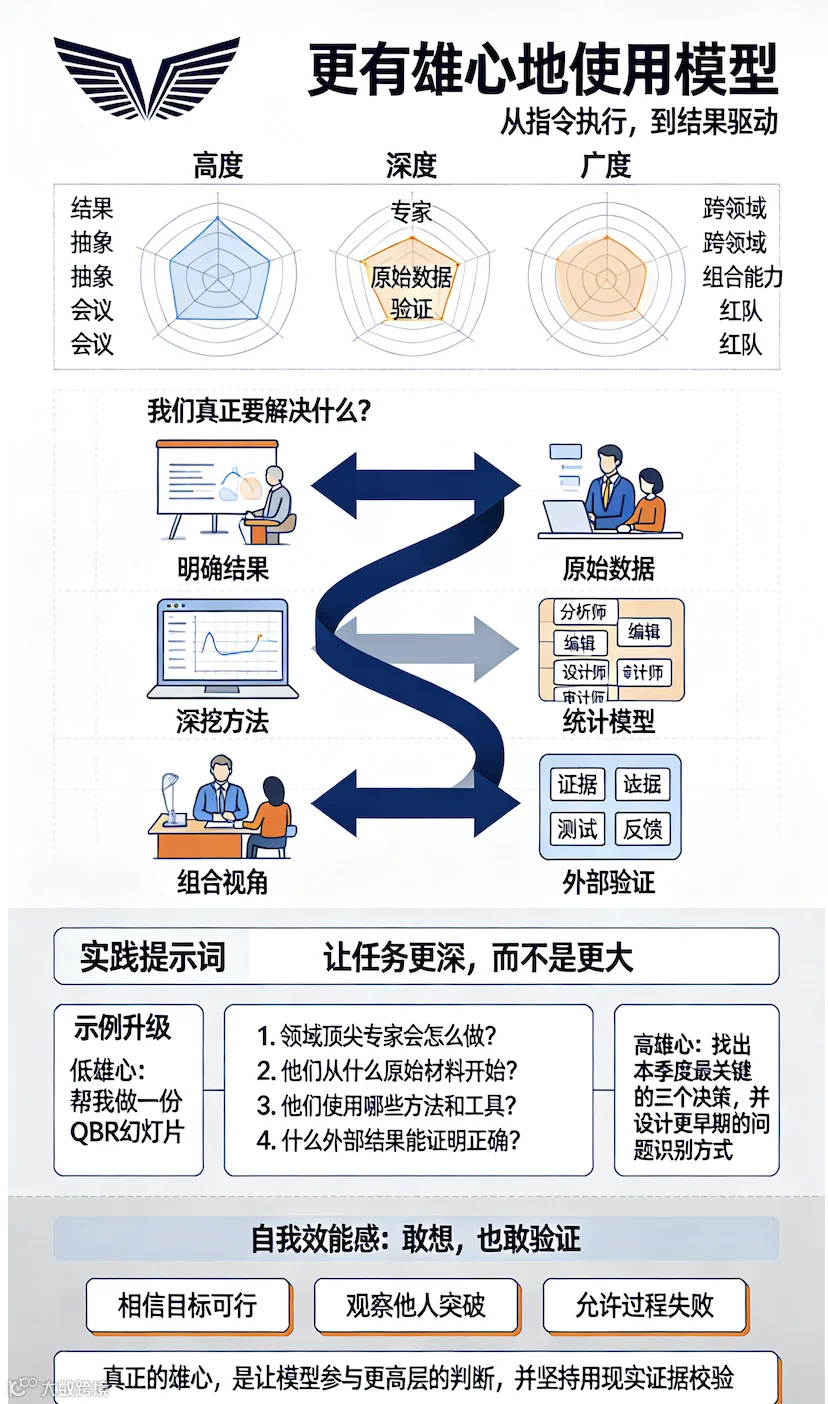
我将 “雄心” 划分为四类:速度、高度、深度、广度。
速度:用更少时间完成同等工作量,这是 AI 创造经济价值的基础。如果你需要写一段代码,借助 Claude 就能更快完成。这一点已经十分成熟,对 AI 的使用方式也不需要太多创造力,所以本文不再展开。
高度:提升抽象层级,着眼最终结果,而非一个个零散任务。
深度:以行业顶尖专家的视角处理任务。不停留在任务表层,向下深挖,触及底层数据、工具与核心问题。
广度:跨多学科领域思考,不局限于任务表面所属单一领域,调用平时不会用到的知识、工具与方法。
我日常主要用 Claude(这是自然),但文中这些方法并不局限于某一款大模型。
高度
我们常随口称之为 “让模型在更高抽象层级工作”。当你给模型下达任务时,它只是在执行你猜想的、达成目标的步骤。想要在高度上更有雄心,不妨自问:接下来我想要实现什么?目标背后更深层的目标是什么?去年年初,我还只是让 Claude 逐个修复程序崩溃问题。后来,我直接要求 Claude 保障我们所有应用不发生崩溃。
我们来看一个日常(甚至可以说普通)的办公场景。假设你在一家虚构公司阿克姆(Acme Inc),需要制作一份季度业务复盘(QBR)演示文稿。有一堆数据在手,Claude 可以轻松帮你生成幻灯片。如果你有现成模板,它甚至可以直接填充内容。但这和发现新行星完全不是一个量级。我们一步步提升目标,看看如何让使用方式变得更有雄心:
绝大多数业务复盘,都需要说明本季度发生了哪些变化、变化原因,以及对应的行动方案。不要只想着更新模板里的数字,尽可能把全部数据交给模型,让它理解业务全貌:“梳理本季度发生了哪些变化、背后原因,以及我们应当采取什么对策。”
高质量会议最终要产出决策。你可以这样要求 Claude:“基于所有分析结果,找出三项最紧急的决策事项,并梳理每种方案的支持理由与反对意见。”
季度复盘诞生于这样一个时代:过去需要人工仔细筛选数据、解读含义,再判断业务是否需要调整。你可以对 Claude 说:“复盘的意义,是让管理层尽早发现问题,把人力与资金调配到正确方向。设计一套比季度 PPT 复盘更好的机制;用我们公司过往历史数据证明这套机制可以更早识别风险;接下来一个季度,让这套新机制和现有复盘并行运行。”
高度这套思路最适合追求最终业务结果的场景;用于创意创作时效果有限。一个简单判断标准:如果你需要开会讨论这件事,那么就适合从高度入手。当然模型目前仍存在局限(2026 年,对绝大多数企业来说,只说一句 “Claude,去赚钱” 并不能自动实现盈利)。但总体来看,模型能力越强,就越能在更高抽象层级完成工作。
“高度” 思路也能帮你搭建可长期复用的工作流,减少人的重复介入,不必一次次给模型下达零散任务。想要做到这一点,往往需要改造现有工作流程。比如想让 Claude 保障应用不崩溃,我首先要确保它能获取崩溃日志、识别应用版本对应的 Git 提交记录,还要授予它访问 Windows、macOS、Linux 环境的权限,让它能够独立复现故障、验证修复方案。
深度
有时候,你只是希望把一件事做到极致。深度层面的雄心,就是推动模型使用行业顶尖专家所用的工具、技术、素材与知识,持续挖掘,直到就连领域专家也能从这份成果里获得新启发。
继续沿用阿克姆公司季度业务复盘 PPT 的例子。假设这家公司正面临用户流失问题。下面这些方法对我很有帮助:
- 坚持使用业内顶尖从业者的专业工具
如果只是让模型扮演专业人士,它往往只会换一套专业话术,方法却没有改变。想要做到深度分析,就要和顶尖数据科学家、统计学家使用同样的工具。当 Claude 想用 Markdown 表格输出时,要求它使用数据库与统计模型。你不一定需要懂专家用什么工具,Claude 通常了解。 - 设定看似不合理的目标,并告诉模型这完全可行
网站加载速度从 10 秒优化到 5 秒?那直接要求做到 200 毫秒。模型如果觉得这件事不可能,反复告诉它:问题完全可解,只需要继续深挖。 - 挑战固有认知
商业领域里,很多我们笃定的结论,其实只是对现实粗略的近似。把原始数据交给模型,让它从反面检验我们的假设。例如:“我们认为用户流失源于新手引导环节。用原始数据验证这个结论是否成立。” - 产出新知识
这一点可以承接上面的假设检验。当 Claude 深入挖掘数据后,让它寻找我们尚未发现的盲区。“基于日志搭建客户行为模拟系统,复现过去一年的用户情况。找出我们目前还不知道的、最早的用户流失预警信号,并证明该信号在未见过的数据上依然具备预测能力。” - 引入外部评审方
不要让模型自评结果。我相信随着模型能力提升,这个问题终会被解决,但在 2026 年 10 月,我强烈建议采用外部验证。最好是模型可以直接调用工具,即时获取反馈。
我经常用的一段提示词模板:
我希望对这项任务做深度挖掘,不是单纯扩充内容。在重写提示词前,请依次完成:(1)说明该领域顶尖专家会做哪些我没有要求的工作;(2)写出专家会使用哪些原始素材,而非已经加工整理好的材料;(3)列出专家会用到的具体方法与工具;(4)说明除了你我之外,用什么证据可以证明结果正确。之后重写我的提示词,精准提出以上全部要求。
广度
简单来说,广度层面的雄心,就是从多个不同学科视角看待工作 —— 多到在过去单独依靠人力时,成本根本无法承受。这个观点并不新奇:所有偷盗题材电影,前 30 分钟基本都在组建一支拥有多元技能的团队。随着 AI 产品越来越容易搭建多智能体系统(多线程、编排器、子智能体),我试过让 Claude 引入其他学科视角,得到了非常有意思的结果。
落地实践并不简单,需要创造力。我同事亚历克斯・阿尔伯特用 Blender 渲染室内设计,在那之前,就算我曾经制作过电子游戏,也从来没想过用 Claude 搭建 3D 场景。但在广度这个方向,我见证了最多惊喜。
如何实操?分享几个我的方法:
把名词替换成动词: 这是汤姆・凯利与乔纳森・利特曼在《创新的艺术》里提到的经典技巧。季度复盘不是 “一份 PPT”,而是 “在 30 分钟内,让忙碌的管理者理解一套因果逻辑,并在信息不确定的条件下做出决策”。转化成动词描述后,无论是我还是 Claude,都更容易想到哪些学科能提供独特有效的视角。
组建虚拟团队: 假设这份演示文稿必须做到完美,不然外星人就要毁灭地球。人类会集结一支什么样的团队?想要达到专业制作水准,我会搭配分析师、记者、编辑。如果还要现场演示,可能还要加入动态与音频设计师。还可以组建对抗性红队,引入做空投资者与法务审计师。 注意:不要单纯玩角色扮演 —— 这只会让对话文本变得奇怪,却无法提升最终结果。这个方法的目的是挖掘相关学科与技术手段。不要让模型模仿做空者的文风,而是让它执行做空者调研时用到的分析方法。
想要实现以上所有关于雄心的用法,模型需要一台可以安装软件、访问各类相关数据的计算机(可以借助 MCP 连接器或者其他方案)。现在已有不少工具支持该能力,推荐尝试。
我们曾经历过相似阶段
以上就是如何更大胆地使用 AI 的实操建议。如果你愿意继续往下读,我想聊聊为什么这件事本身至关重要。
人类的上限,一直被我们心中 “什么是可行的” 所束缚。更糟的是,我们往往只在极窄的领域内相信自己。米开朗基罗当年并不想画西斯廷天顶画 —— 要知道,他自认是雕塑家,不是画家。
在研究 “雄心” 这个主题时,我发现心理学中有一个对应的概念:自我效能感。简单讲:自我效能感高的人更相信自身能力,进而能取得更多成果。有证据表明自我效能感可以主动提升:洛克与莱瑟姆梳理了 35 年目标设定相关研究,得出结论:设定明确且有挑战性目标的人,更容易取得突破。Stripe 创始人帕特里克・科里森维护了一份清单,记录人类在大胆目标与紧迫期限下完成的诸多壮举。几个已被验证的提升方法:
- 相信难事可行,方能攻克难事
1939 年,乔治・丹齐格在伯克利统计课迟到,抄下黑板上两道题目当成作业完成。而那两道题,是当时尚未解决的统计学难题。 - 看见别人做到,自己也能攻克难事
数十年来,人类一直挑战 4 分钟跑完一英里的纪录。1954 年 5 月,罗杰・班尼斯特打破纪录,而仅仅 46 天后,就有其他人也做到了。长跑圈现在正在见证类似的事:塞巴斯蒂安・萨维今年 4 月在伦敦跑出首个正式破 2 小时马拉松成绩;同场比赛亚军也跑进 2 小时大关。 - 允许自己失败,才敢挑战难事
最近我才读到那本很多人推崇的商业书籍《网球的内在游戏》。书的核心观点:当你拼尽全力硬扛时,反而打不出最好的网球。我们工程师或许会想起 Linux:当年它被发布时,作者只说 “这只是个爱好,不会像 GNU 那样庞大专业”。
自我效能感并不是新问题,但在当下,它的影响力变得更强。如今我们的能力每隔几周就会迎来跃升,需要一些方法,去完成那些原本不敢设想、不相信能做到的事。如果你发现更多可以激发雄心的技巧,欢迎告诉我!
本文配图为弗朗西斯科・戈雅作品《飞行的方式》。
费利克斯・里泽贝格任职于 Anthropic,工程经理,曾主导 Claude.ai、Cowork、Claude Code Desktop 的工程研发。Electron 以及多个开源项目的联合维护者。曾先后在 Notion、Stripe、Slack、微软从事相关工作。
术语注释(便于阅读)
-
Self-efficacy:自我效能感,班杜拉提出,指个体对自己能否完成某一行为所进行的推测与判断 -
QBR:Quarterly Business Review,季度业务复盘 -
MCP:Model Context Protocol,模型上下文协议,用于大模型对接外部工具、数据的标准协议 -
Red team:红队,对抗性测试团队,从反面寻找漏洞、质疑结论 -
Churn:用户流失率 -
Four-minute mile:4 分钟一英里长跑(经典人类极限突破案例)