


编者摘要:Jeff 是基于 Qwen3.5 与 Gemma4 微调得到的轻量决策模型,对标 Jev,参数量压缩至 0.8B,主打本地部署零样本分类能力。它不输出生成文本,仅通过单次前向运算,返回各选项的校准概率,无需文本解析,降低工程接入成本。
该模型支持任意自定义选项,类目无需存在于训练数据,仅需用自然语言描述场景与候选选项,可用于客服队列分配、用户意图识别、内容审核标签、语音指令解析、游戏动作决策等场景。
推理性能优秀,RTX PRO 6000 上单轮决策约 22ms,Apple M4 Max 借助 MLX 框架可达 28ms,低延迟特性适合实时业务。
核心定位是嵌入式轻量决策器,并非通用大模型,只做分类打分,不承担内容生成任务,适合集成到代码中,为本地智能体、业务判定场景提供低成本、低时延的分类决策能力。

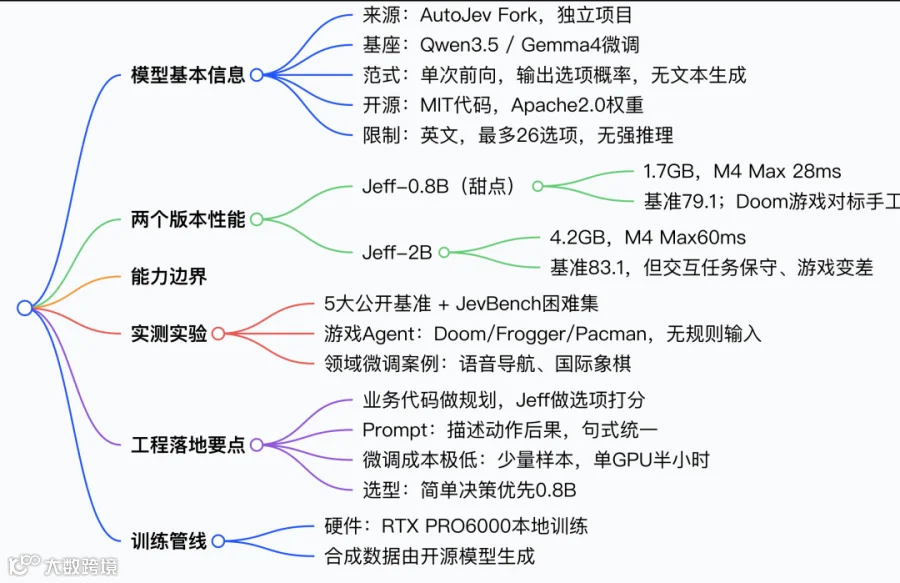
附录:Jeff:Jev 风格 0.8B 本地决策模型
定位:轻量本地零样本分类决策模型,不是通用推理大模型,复刻 Jev 的输出范式,一次前向传播输出选项校准概率,无自由文本生成,适合嵌入业务做快速选择。
一、模型本质
Jeff 基于 Qwen3.5、Gemma4 微调,继承 AutoJev(Perplexity Denis Yarats)的核心架构:不生成文本,直接输出各个选项概率。
-
输入:自然语言描述场景 + 候选动作 / 标签(附带每个选项的后果描述) -
输出:各选项校准后的概率,无需文本解析 -
核心能力:零样本选项选择,标签 / 动作不需要出现在训练集;但不做多步逻辑推理(System1 快速判断) -
开源协议:代码 MIT,模型权重 Apache2.0;独立项目,不属于 TypeSafe(Jev 原作者),无官方背书
硬件延迟与体积(重点是 0.8B 甜点模型)
表格
|
|
|
|
|
|
|
|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
亮点:0.8B 仅 1.7GB,Mac 笔记本本地可跑,单次决策几十毫秒,远快于 Jev API(114~212ms,含网络)
二、基准结果解读(4599 题 + JevBench 困难子集)
⚠️注意:Jev、AutoJev 是同基准但不同测试样本,不是严格控制变量对照
-
Jeff-0.8B:整体 79.1 分;Jeff-2B:83.1 分,略超 Jev 公布 83.0 -
✅小模型优势场景(分类、事实接地) -
Financial PhraseBank 金融文本分类:96.4(Jeff0.8B)vs Jev77.0 -
RAGTruth RAG 事实校验:86.1 vs Jev77.3 -
❌短板:复杂多步推理任务明显拉胯 -
BBH 复杂推理:64.0 vs Jev94.3 -
JevBench 困难子集:47.6 vs Jev73.3
一句话总结:做选项之间的判断很强;需要多步推理、深度思考就不行。
三、游戏零样本实测
Doom、Frogger 青蛙过河、Pac-Man 吃豆,仅文字描述环境 + 动作后果,不给任何游戏规则,20 局取平均。
-
Jeff-0.8B:Doom 击杀 6.55,和手工规则 Bot 持平;而原版 Jev 只有提前告知瞄准规则才能到 6.55,不给规则时仅 - 0.6。 -
反常识现象:Jeff-2B 基准分更高,但游戏表现反而差,模型更容易保守避险。
关键启示:基准分数不能预测智能体交互任务效果,提示词写法(重点写清楚每个动作带来的后果)远大于模型参数量。
四、领域微调能力(零样本不够就微调,成本极低)
-
语音导航任务:零样本 31.7% → 微调后 95.8%,仅 1.1w 样本,单块 GPU 半小时训练,推理 40ms -
国际象棋:60 万 Lichess 棋面 + Stockfish 标注,单 GPU 训练 3.5 小时 -
Jeff0.8B 零样本:15.5%;微调后 Jeff-0.8B-Chess:55.8% -
能力上限:无搜索仅约 1000Elo,弱于 Stockfish 最低档位;优势是速度,单 GPU 可同时支撑 600 场快棋。
五、工程使用建议
-
定位分清:Jeff 做选项决策,业务代码负责规划。只适合 “给定候选列表选最优”;不适合预测远期状态、多步推演。 -
Prompt 技巧:必须写清每个选项的后果;保持选项描述句式统一,效果提升巨大。 -
输入格式:短 key + 简短描述,不要超长 ID。 -
批量打包多个独立问题放到同一个请求,提升吞吐。 -
选项上限:最多支持 26 个选项(A-Z),第 27 个及以后选项永远不会被选中,长候选列表要先做过滤。 -
选型:简单快速决策优先 0.8B;需要更谨慎判断选 2B;交互类游戏场景慎用 2B(风险规避问题)。 -
语言限制:仅英文文本。
六、局限性(作者主动披露,非常重要)
-
最多 26 候选,超出失效; -
0.8B/2B 尺度不具备强推理能力,只适合选项间快速打分; -
Jeff-2B 存在保守偏见,交互游戏任务反而弱于 0.8B; -
基准分数≠实际智能体表现; -
Prompt 极度敏感,提示范式不对效果断崖下跌; -
仅支持英文文本输入。
七、训练与工程背景
-
衍生自 AutoJev,保留单次前向、概率读出、温度校准核心思路,目标做小型学生模型。 -
全本地训练:RTX PRO6000 工作站,0.8B 训练约 2h,2B 约 3.5h;合成数据由开放大模型生成,不使用闭源模型输出做训练数据,仅用来抽检数据质量。 -
开源资产:代码、模型权重发布;训练集未开源。仓库 2026-09-28 新建,短时间获得 918 星。
八、价值总结
Jeff 是 Jev 路线上非常务实的开源落地成果:把 Jev 风格的校准概率决策能力压缩到 0.8B,本地笔记本就能跑,几十毫秒返回结果。 适用场景:本地智能体动作选择、意图分类、标签判定、审核打分、机器人 / 游戏 Agent 动作挑选; 不适用:多步推理、复杂规划、长逻辑推演、中文场景。
本质是高性能本地分类器,不是通用智能体大脑。