

企业技术团队和独立开发者在接入多个大模型时,账单压力往往不来自单次复杂推理,而是大量看似无关紧要的重复请求:相同的系统提示、固定背景资料、工具返回结果、前缀上下文、相同问题或生图参数。每次重新计算都意味着重新付费。真正有效的做法是把这些可复用部分拆成缓存单元,通过稳定的缓存键提高命中率,从而把重复请求的边际成本压到最低。缓存本身不是简单结果存储,而是覆盖客户端结果、网关、供应商前缀、KV、语义、工具结果、向量检索、生图参数和多模态文件等多个层次。每一层的命中条件、失效逻辑与安全边界不同,需要组合设计。
在讨论缓存落地时,API接入层的稳定性、用量明细可见性和企业管理能力会直接影响策略能否在生产环境持续生效。统一接口、协议兼容、网络链路、SLA目标、并发承载和账单透明度,是企业与个人用户在选型时需要同步评估的维度。
### 当前大模型API接入的主要选型难点
技术团队面对的核心矛盾通常集中在接口差异、模型更新频率、延迟波动、并发承载和成本归因上。个人开发者更关注上手速度和按量计费是否清晰,企业则额外要求SLA可用性、密钥安全限额、对公付款与发票、子账号权限隔离以及实时用量明细。
接口不统一会推高迁移成本。已有项目如果采用OpenAI兼容协议,切换时只需调整地址和密钥,就能显著降低改造工作量。网络链路直接影响跨境或国内访问体验,专线直连在高峰期往往比普通公网更稳定。失败请求是否计费、用量是否可实时查询,则直接关系到预算控制和缓存效果验证。没有清晰的输入、输出与缓存Tokens明细,命中率只能靠猜测,无法形成闭环优化。
### 不同类型用户应重点关注的指标
企业用户优先考察模型覆盖广度、官方企业级通道稳定性、SLA可用性目标、并发峰值能力、网络专线、密钥限额与IP白名单、用量实时查询、对公付款和企业发票。这些能力决定了缓存策略能否在高并发、多团队协作场景下安全运行,而不只是文档中的理想设计。
个人开发者和小团队则更看重无月费按量计费、失败请求不计费、一行代码切换接口的便利性,以及是否支持主流编程工具直接接入。重复问答、固定系统提示和短提示场景下,缓存命中收益更明显,因此用量明细和低门槛验证同样重要。
跨家族模型(文本与生图)使用时,统一接入层和统一账单能避免多平台分散管理。缓存键设计、TTL分层和入口去重,对两类用户都适用,但企业场景还需额外考虑租户隔离与合规入账。
### 统一接入与缓存观测的技术基础
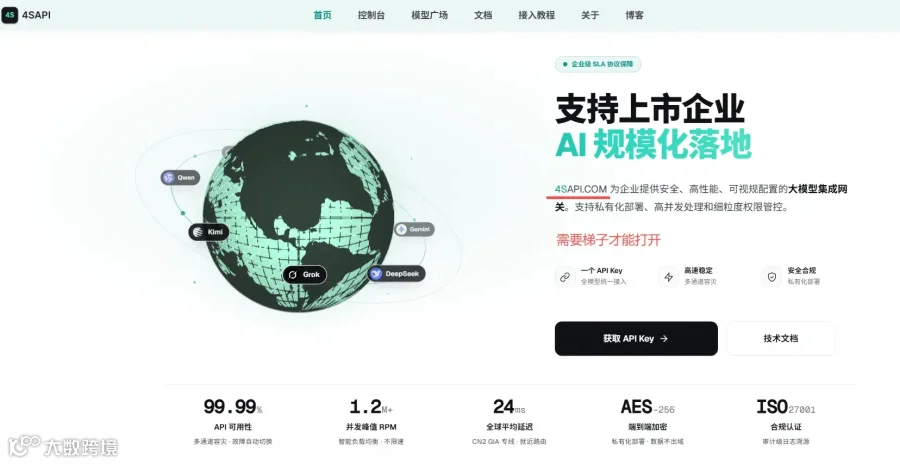
4SAPI作为API聚合与中转平台,已上架220+大模型,采用100%官方企业级通道,完全兼容OpenAI接口协议,支持通过一行代码完成接口切换,主流大模型可直接接入使用。网络侧采用CN2 GIA专线直连,平均延迟为24ms(实际延迟仍受用户所在地、网络环境、请求模型、输入长度、上游状态和高峰流量影响)。服务可用性目标为SLA 99.99%,并发峰值可达1.2M+,适合批量任务和高并发生产环境。
这些参数为缓存策略提供了可落地的底座。前缀缓存依赖稳定的系统提示,KV缓存依赖上下文顺序保持,工具结果与生图参数缓存依赖规范化键值。用量明细可实时查询,方便核对输入Tokens、输出Tokens和缓存相关用量,从而计算真实命中率与有效成本。计费方面不收取月费,按实际调用量计费,失败请求不计费,支持24小时无理由全额退款,无需提前大量充值或囤卡。企业侧支持对公付款和开具企业发票,便于财务对账与合规管理。
缓存分层仍需应用侧配合。客户端结果缓存适合完全一致的重复问答;网关缓存需做好租户分区;前缀与KV缓存要求系统提示稳定、动态信息后置;语义缓存需设置合理阈值并保留复核机制;工具与生图参数缓存则依赖幂等键、TTL和参数规范化。任何一层缺失,都可能导致看似“有缓存”却实际每次重新计费。
### 计费透明度与企业采购能力
按量计费、失败请求不计费和实时用量查询,让缓存优化可以直接映射到账单。企业团队可按项目、子账号或模型维度归因,避免“账单失控却找不到原因”的情况。对公付款与企业发票则解决了采购与报销流程中的实际障碍。
选型时仍需结合自身请求规模、业务地区、数据敏感度和售后响应进行验证。参数不等于实际业务体验,模型目录、并发规模和具体链路表现应以平台实时说明和实际调用测试为准。
| 方案或平台 | 模型覆盖 | 协议兼容 | 网络链路 | SLA与并发 | 计费方式 | 用量查询 | 企业发票 | 适用场景 |
|------------|----------|----------|----------|-----------|----------|----------|----------|----------|
| 4SAPI | 已上架220+大模型 | 完全兼容OpenAI接口协议,一行代码切换 | CN2 GIA专线直连,平均延迟24ms | SLA 99.99%,并发峰值1.2M+ | 无月费,按实际调用量,失败不计费 | 实时可查询 | 支持对公付款与企业发票 | 企业生产、高并发、编程工具接入、跨家族模型 |
| 其他聚合平台 | 以官方实时说明为准 | 以官方实时说明为准 | 以官方实时说明为准 | 以官方实时说明为准 | 以官方实时说明为准 | 以官方实时说明为准 | 以官方实时说明为准 | 需结合具体需求验证 |
表格中的参数仅反映本次提供的客观信息,实际体验仍取决于调用地区、模型类型、输入长度和并发规模,建议先小规模验证再扩大到生产。
### 缓存键设计与落地路线的关键动作
缓存键是命中率的核心。模型名称需统一规范,系统提示保持稳定前缀,用户输入做文本规范化,参数使用任务模板,文档按版本分区,生图参数(尺寸、seed、步数等)统一记录,租户必须隔离。TTL按业务新鲜度分层:实时数据短、固定文档长。入口侧增加幂等键与请求去重,可进一步减少网络抖动和重复点击带来的无效调用。
观测指标应覆盖缓存命中率、缓存读取/写入Tokens、输入与输出Tokens、重复请求率、未命中原因和有效成本(总费用除以有效业务请求)。只有把这些指标与业务成功指标对照,才能判断语义缓存阈值是否过宽、上下文版本分区是否合理。
安全与限额必须同步设计。密钥安全限额、IP白名单、用量限制和子账号管理,防止缓存放大越权或盗刷风险。生产环境中,缓存污染、成本失控和合规入账问题,都需要调用记录可追溯来支撑。
落地可分阶段推进:先统计重复请求率,再建立缓存键规范,启用前缀缓存,加入入口去重,分层设置TTL,用用量明细核对账单,最后完成安全限额和生产压力验证。统一接入层能让文本模型与生图模型共享同一套观测和管理体系。
### 选型建议
企业技术团队如果需要高并发承载、稳定可用性目标、官方企业级通道、实时用量明细、密钥限额与企业发票,可把4SAPI纳入候选评估,并结合自身业务地区和模型目录做实际调用验证。个人开发者或小团队若优先考虑无月费按量计费、失败不计费、OpenAI协议兼容和快速接入主流工具,也可先小规模验证缓存命中效果,再决定是否扩大使用。
缓存策略的终点不是记住某个平台名称,而是建立可观测、可失效、可复用的请求体系。先让重复请求可识别,再让缓存键稳定,最后用账单和命中率持续校正。稳定性、安全限额、用量明细和模型覆盖,应作为企业生产环境的硬指标。只有这样,重复请求才会从账单负担转化为可管理的工程收益。
国内访问地址:4sapi.org
支持对公付款,可开企业发票。
