搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
ZPedia|MiniMax M3.1 Flash :Coding 逼近 DeepSeek,价格继续下探
>
ZPedia|MiniMax M3.1 Flash :Coding 逼近 DeepSeek,价格继续下探
Z Finance
2026-10-19
4
导读:72 小时之内,DeepSeek和MiniMax 前后发布 Flash 模型
Flash模型崛起:
MiniMax
M3.1 Flash正式发布,对标
DeepSeek
-V4.1
随着基座能力的跃升,曾经被视为“阉割版”的Flash档位模型,正凭借低延迟和高性价比成为开发者在终端、自动化Agent等核心工程场景的主力选择。
10月17日,DeepSeek推出DeepSeek-V4.1-Flash-1017,将DeepSWE成绩提升至77.0%,Automation-Bench提至60.5%。仅隔两天,MiniMax正式发布MiniMax M3.1 Flash。该模型此前以测试版形式在MiniMax Code等
工具
中开放,此次正式版在代码工程、Agent执行、Computer Use及系统安全等多维度给出完整评测,直接对标DeepSeek-V4.1-Flash-1017及国内外主流旗舰模型。
接入真实工程后,开发者的核心诉求收敛于工程性价比:即在极低的单次任务开销下,模型能否独立解决真实场景中的复杂问题。
工程与Agent能力实测
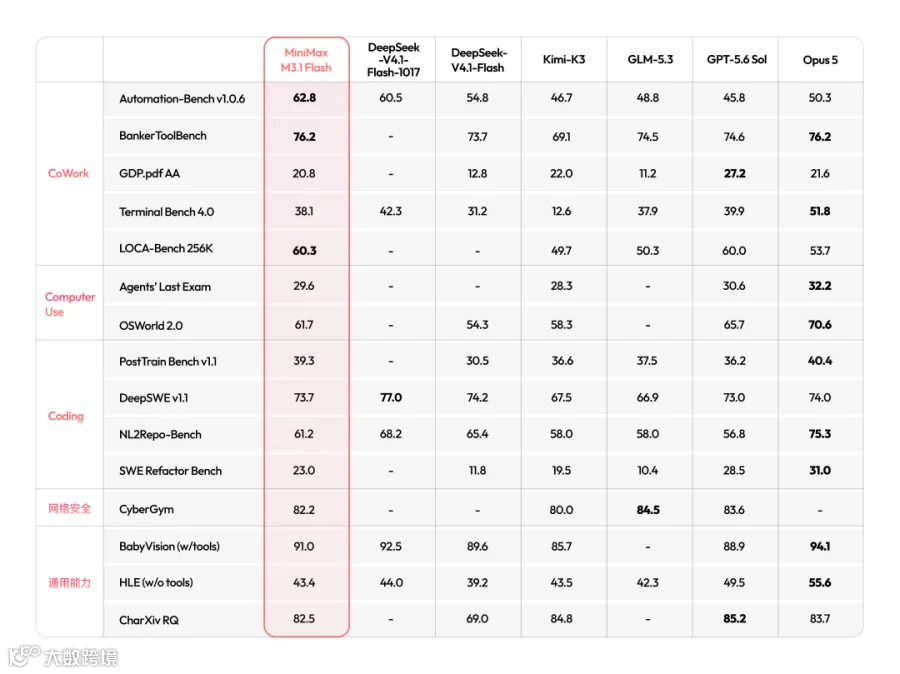
官方评测显示,MiniMax M3.1 Flash在核心指标上已进入第一梯队,软件工程得分紧咬DeepSeek最新版,并在跨系统企业自动化、金融工具调用与桌面操作上展现出明显优势。
代码修复能力:
在衡量代码仓库级修复能力的DeepSWE测试中,DeepSeek-V4.1-Flash-1017得分为77.0%,MiniMax M3.1 Flash取得73.7%,差距仅3.3个百分点,同时超越了GPT-5.6 Sol(73.0%)、GLM-5.3(66.9%)与Kimi K3(67.5%)。
自动化执行能力:
在考察跨SaaS动态执行的Automation-Bench v1.0.6中,M3.1 Flash跑出62.8%的成绩,超过DeepSeek 1017的60.5%,更显著高于Claude Opus 5(50.3%)与GPT-5.6 Sol(45.8%)。而在侧重终端命令行交互的Terminal-Bench 4.0中,M3.1 Flash得分为38.1%,DeepSeek 1017达到42.3%,两者在终端交互与上层业务流上各有侧重。
金融与合规任务:
在面向金融复杂任务的B
anker
ToolBench中,M3.1 Flash取得76.2%的得分,与Claude Opus 5并列第一,领先于DeepSeek V4.1 Flash(73.7%)与GPT-5.6 Sol(74.6%),验证了其在严格合规与复杂工具链下的规划稳定性。
Computer Use与多模态:
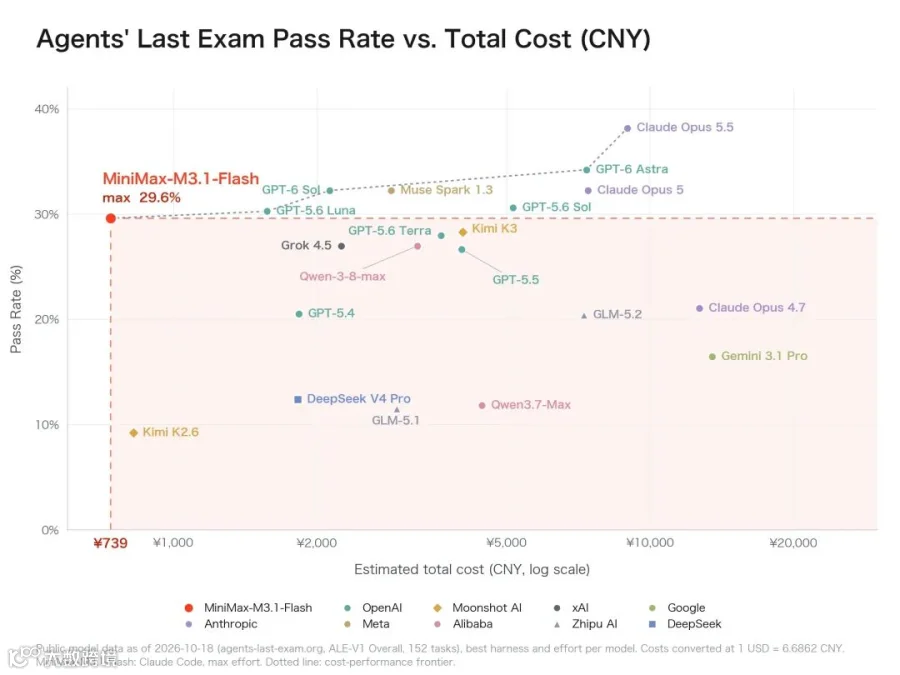
在长流程权威基准OSWorld V2中,M3.1 Flash取得61.7%,超过Kimi K3(58.3%)与DeepSeek V4.1 Flash(54.3%),逼近GPT-5.6 Sol(65.7%)。在专业任务综合基准ALE中,其通过率达29.6%,接近GPT-5.6 Sol的30.6%。此外,M3.1 Flash在漏洞安全测试CyberGym中拿下82.2%,在多模态评测BabyVision中达到91.0%,可通过截图和视频辅助前端开发与调试。
重定义单任务成本
真实工程环境中,Agent解决问题需反复读取上下文、调用工具和重试,冗长输出易推高总账单。因此,
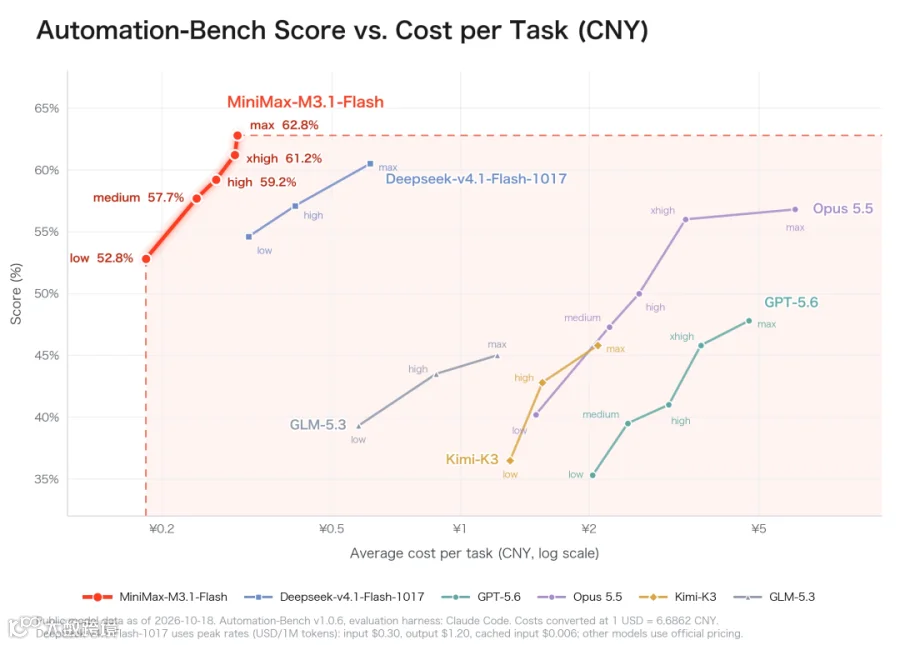
完成单项任务的平均总成本(Cost per Task)比百万Token标价更具参考价值
。
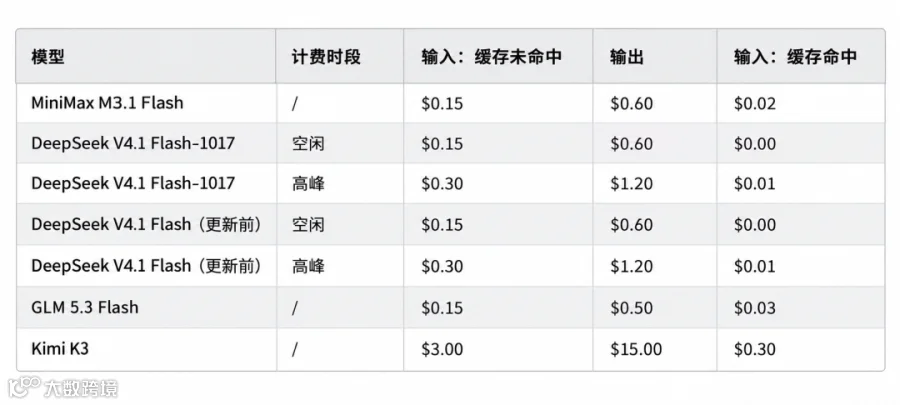
MiniMax M3.1 Flash的API普通输入价格为每百万Token 0.15美元,输出价格为0.60美元,缓存命中输入价格约为0.015美元。相比上一代M3,其输入输出价格减半,缓存读取降低约75%。对比DeepSeek-V4.1-Flash-1017,M3.1 Flash的价格与DeepSeek闲时持平,仅为其忙时价格(输入0.30美元/输出1.20美元)的一半。
结合任务完成率与单次任务成本分析,各模型在实际执行效率上的差异如下:
Automation-Bench性价比领先:
随着推理档位从low至max拉升,M3.1 Flash始终处于低成本区,最高冲至62.8%。相比之下,DeepSeek 1017要达到相近分数需付出更高单任务成本,而Claude Opus 5与GPT-5.6 Sol则基本分布在右侧高价区。
DeepSWE紧跟第一梯队:
在软件工程任务上,DeepSeek 1017依然保持最高分与低成本的综合优势;M3.1 Flash最高分略逊一筹,但相比一众高价闭源旗舰,依然稳居“高得分、低开销”区间。
ALE专业任务账单:
在ALE测试中,M3.1 Flash(Claude Code max配置)跑出29.6%通过率,跑完全套评测预估仅需约739元人民币;而Claude Opus 5、GPT-6 Astra等模型虽然通过率更高,但对应成本也相应上涨。
除了支持五档推理强度让开发者按需控费外,生成
速度
也在隐性压低成本。得益于更激进的稀疏注意力架构,M3.1 Flash日常输出速度可达200+ TPS,中位数(P50)稳定在170+ TPS以上。对于需要成百上千次循环调用模型的自动化团队来说,跑得越快、错得越少,省下的
时间
和算力账单就越可观。
原生多模态与工具链落地
在此次正式版发布前,MiniMax M3.1 Flash的早期版本已经在海外开发者社区经历过一轮公开测试和大量调用。
今年9月下旬,全球模型路由平台OpenRouter上线了一款代号为
Space Bunny
的匿名免费模型。不到一周,这款模型凭借在编程与Agent工具中的稳定表现,9月28日单日消耗达3.99万亿Token,一度超过DeepSeek V4.1 Flash(3.44万亿)位列平台日调用量第一。在开源编程工具OpenCode上也刷出了数十万亿Token的调用规模。
当时,不少海外开发者通过测试其独特的百万上下文窗口设置以及Tokenizer分词特征,推测其来自MiniMax。此次官方正式确认,Space Bunny正是M3.1 Flash的早期测试版,在吸纳了社区海量实战反馈后,正式版的工具调用与指令遵循得到了进一步加固。
MiniMax从此前的M2.7、M3系列迭代至M3.1 Flash的技术路线,这款模型针对开发者的核心特性主要集中在了百万级上下文与原生多模态输入的结合上。这直接打通了许多过去纯靠文字描述极其费劲的开发场景。
比如在前端性能调优中,面对包含海量工单的卡顿页面,Agent可以自己跑起项目,直接“看懂”浏览器生成的火焰图和日志,揪出耗时操作并改代码重测;而在Computer Use桌面操作中,模型直接靠截图理解软件界面状态,联动键鼠完成跨软件的繁琐人工操作。
结语
72小时内,DeepSeek与MiniMax前后脚交出新一代Flash答卷。可以看出国内大模型的竞争重点正在从代码能力延伸至复杂Agent任务、计算机操作和实际使用成本等多个维度。
对于开发者而言,MiniMax M3.1 Flash的实际价值在于,它在DeepSWE、Automation-Bench等核心工程测试中交出了具有竞争力的成绩,同时将能力覆盖到Cowork、Computer Use等场景,并通过多档推理强度和较低的任务消耗,为不同复杂程度的Agent工作提供了成本选择。
目前,M3.1 Flash已正式上线MiniMax API、MPlan以及MiniMax Code中,并将于稍后开放权重。对于高频使用Coding Agent,或正在尝试将Agent引入企业工作流的开发者和团队,这款模型提供了一个兼顾工程能力与使用成本的新选择。
【声明】内容源于网络
0
0
Z Finance
我们相信认知能够跨越阶层,致力于为年轻人提供高质量的科技和财经内容。
内容
936
粉丝
0
关注
在线咨询
Z Finance
我们相信认知能够跨越阶层,致力于为年轻人提供高质量的科技和财经内容。
总阅读
117.4k
粉丝
0
内容
936








 Z Finance