


「这不是给文生视频模型装个控制模块那么简单。」
在通用实时世界模型 PixVerse R2 发布之际,旧金山机器人与世界模型读书会主理人 Junfan Zhu 指出其与传统文生视频模型的本质区别:音频、视频和动作需在同一个因果世界循环中实时生成,且在用户介入后能保持状态连续性。

可交互的实时世界:从观看进入体验
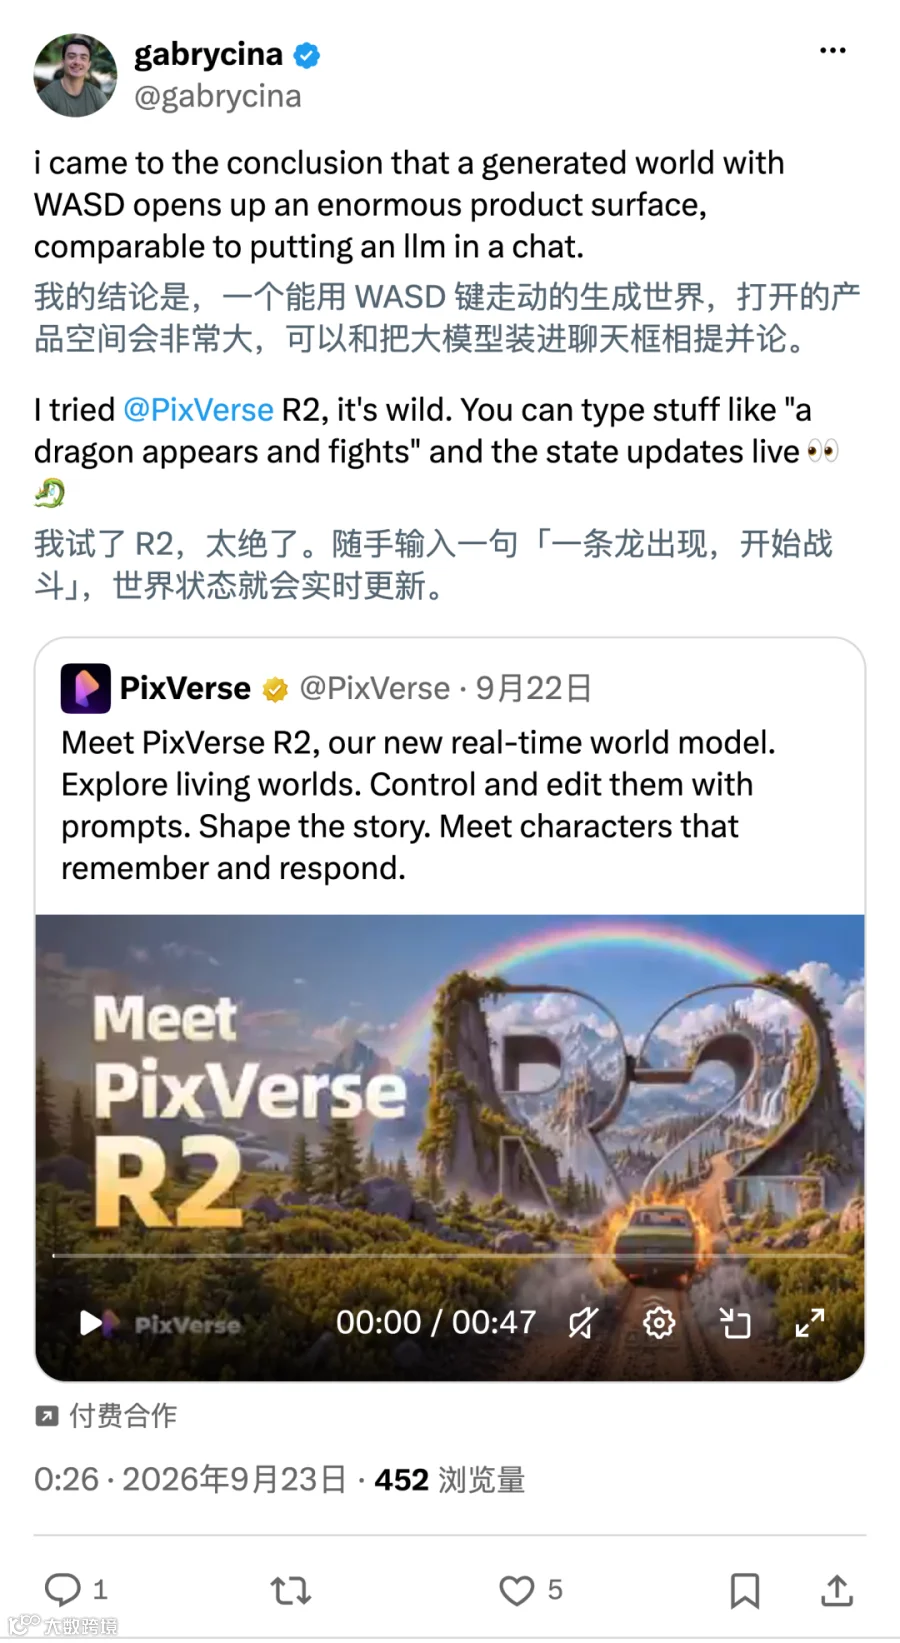
9 月 22 日,PixVerse R2 正式发布。该模型构建了一个可持续运行的实时世界,用户可通过 WASD 键移动视角,并通过提示词实时改变场景中的事物,这些变化将延续并影响后续剧情发展。
Scale AI 高级产品工程师 gabrycina 体验后表示,输入指令如“一条龙出现并开始战斗”后,场景状态会实时更新,效果令人惊艳。
PixVerse 官方提出的核心议题是“实时世界模型能否持续扩展”。与传统观点认为实时适合小模型、通用适合大模型不同,PixVerse 采用双核心引擎策略,将能力与效率解耦。
业界专家关注的重点并非单纯的画质,而是以下三个技术指标:
- 模型延迟:用户操作后画面的响应速度;
- 能力保留:实时化改造后原始性能的留存比例;
- 运行稳定性:长时间连续运行下画面是否变形或崩溃。
极低延迟:重构生成逻辑
开源推理框架 SGLang参与开发者 Chenyang Zhao 指出,实时世界模型对推理延迟的要求极高,无法像传统视频生成那样依靠加载圈隐藏等待时间。

SGLang Omni 核心开发者 Yichi Zhang 也认为,流式延迟和实时优化是该模型带来的主要挑战。传统视频生成类似“录播”,可全局参考帧信息;而实时世界模型类似“直播”,需基于已有画面和即时操作快速生成后续片段。
为解决延迟问题,PixVerse R2 采取了两项关键设计:
- 动态切片处理:针对 WASD 等按键操作生成短片段以确保反应精准,针对提示词描述的完整事件生成长片段以保证叙事连贯。
- 稀疏注意力机制:仅精确计算画面中关系紧密的部分,稀疏度超过 90%,在几乎无损的前提下大幅降低算力需求,从而提升分辨率并延长运行时间。
Video-LLaVA 作者之一 Jiaxi Cui 实测单板滑雪场景后确认,通过 WASD 和空格键控制可实现即时响应,延迟在可接受范围内。

能力保留:减少“蒸馏税”
Junfan Zhu 将模型蒸馏过程中的性能损耗比喻为“能力税”。传统流程需经过多轮蒸馏、误差修补和压缩,导致画质、动作及稳定性逐层递减。

PixVerse R2 简化了这一流程,仅保留两个核心步骤:
- 训练可同时处理多模态输入的主干模型
Omni Causal AR,深度强化基础能力; - 直接将该主干模型加速为实时模型,避免多层蒸馏带来的性能折损。
这种“师傅直带徒弟”的模式旨在消除专门的误差修补环节,使实时模型在继承主干模型能力的同时,具备随规模扩大而增强的潜力。
长期稳定性:对抗“滚雪球”效应
World Labs 空间重建研究员 Chongjie Ye 指出,PixVerse R2 在长时间运行中表现出更高的稳定性,抖动和世界突变现象显著减少。

传统向前生成模式易因早期微小错误累积导致画面崩坏。PixVerse R2 通过三种策略解决此问题:
- 训练时引入含噪声的历史画面,增强模型对偏差的容忍度;
- 分离保存长期设定(角色、场景规则)与短期动作,防止核心要素突变;
- 建立“错题本”,将历史错误画面重新纳入训练以修正模型。
数据显示,该技术使长时间运行的亮度漂移指标从 0.201 降至 0.129,静止场景下的异常动态明显减少。尽管前 Hugging Face 亚太生态负责人 Wang Tiezhen 指出算力限制仍影响体验时长,但行业对其实时负载优化前景持乐观态度。

应用前景:从演示走向技术路线
西湖大学助理教授 Yuliang Xiu 认为,实时性让世界模型名副其实。PixVerse R2 引擎使得手机扫描、智能眼镜拍摄等实时输入数据得以充分利用,例如实现即时的虚拟试衣功能。

gabrycina 指出,支持 WASD 移动的生成世界开辟了巨大的产品空间,其意义堪比将大模型嵌入聊天界面。用户不再是旁观者,而是可以通过操控角色和调整镜头,实时干预故事走向。随着算力成本下降,为宠物或角色构建可交互、可修改剧情的个人小世界将成为可能。