大数跨境

实测 Grok Bot:变身「云端AI团队」同题硬刚两款国产Agent

实测 Grok Bot:变身「云端AI团队」同题硬刚两款国产Agent AI科技评论
2026-10-19
7
导读:一套代码能跑遍所有芯片。
一套代码能跑遍所有芯片。

    作者丨吴海明

    编辑丨李娜 岑峰


01


Grok Bot 的进化:

从“聊天框”到“云电脑”

马斯克近期为 Grok Bot 赋予新能力:接入 Claude Opus 5.5、Midjourney 和 Suno 等第三方顶级模型,并实现核心范式跃升——主 Bot 可主动发现任务并提议接手。
Grok Bot 已从被动应答的聊天机器人,进化为“主动工作”的 AI 云端团队。用户可创建具备不同职责(如研究员、项目经理)的多个 Bot。主 Bot 根据任务执行情况,主动规划下一步工作并将决策权留给用户。
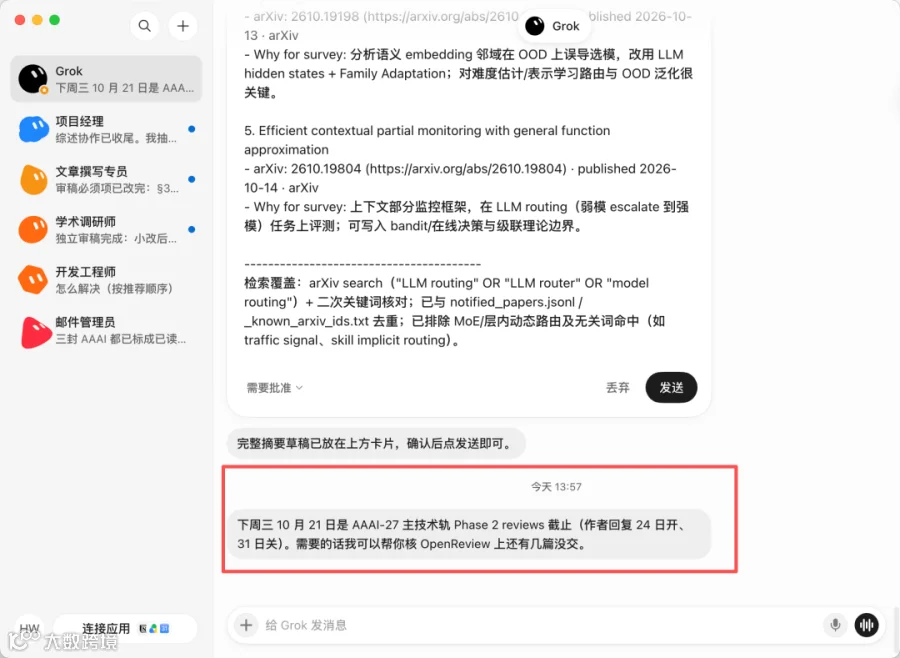
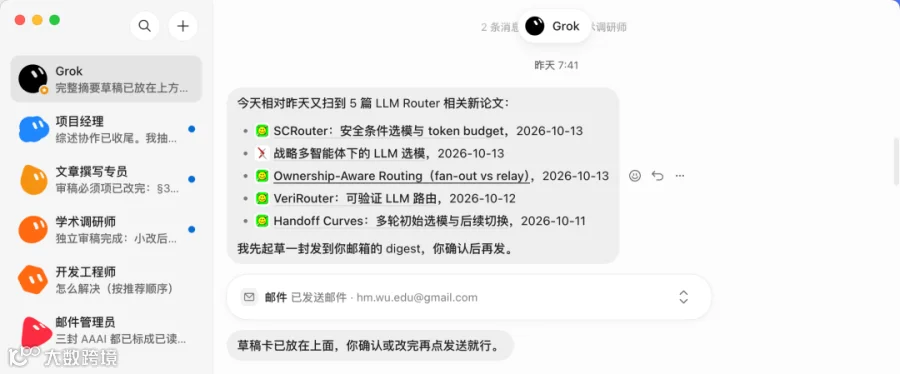
(示意图:无需用户主动发问,Grok Bot 根据已有工作上下文,主动提醒 AAAI-27 审稿截止日期,并提出进一步核查 OpenReview 中尚未提交的稿件。)
这种“多智能体协作”与“主动式 Agent”模式究竟表现如何?为此,本文对 Grok Bot 及两款国产 Agent——WorkBuddy 和 Qoder CN 进行同题测试,任务为撰写《大模型路由研究综述》。
该任务涵盖文献检索、方法梳理、数字核查及独立审稿,要求智能体区分高相似度研究,落实审稿意见,并在交付物中保留分工、交接和纠错痕迹。
实测结果显示:Grok Bot 耗时 12 分 49 秒,速度最快且收录论文最多;WorkBuddy 耗时 21 分 43 秒,正文最接近编辑底稿;Qoder CN 耗时 14 分 42 秒,展现了有价值的智能体交叉纠错。三款产品均暴露出文件引用、数字口径或方法归类等问题,表明多智能体产品的下一竞争焦点在于交付可靠性。

02


三款 AI 同题写作实测

选择“大模型路由”作为测试主题,因其易在资料整理阶段出错:不同论文名称相近但方法各异,同一研究在不同材料中实验数据口径不一。
测试要求智能体分别承担文献检索、方法梳理、实验与基准核查、独立审稿等职责,并在最终交付中保留可见的任务交接与修订记录。
测试指令概要:

代码块

1.请使用你可用的多智能体协作机制,完成一份截至 2026 年 10 月 15 日的中文研究综述,主题为“大模型路由研究”。

2.请让不同智能体分别承担文献检索、方法梳理、实验与基准核查、独立审稿等职责,由一位负责人整合结果。

3.可以按产品支持的方式分工,但必须保留实际可见的任务交接与审稿修改记录;不要编造未发生的智能体协作。

4.最终交付:①一篇约 3000—4000 字的综述,解释大模型路由要解决什么问题、主要方法如何分类、LLMRouter 的具体贡献及局限;②一张涵盖至少 12 篇原始论文的对照表,列出方法、路由依据、模型池、质量/成本/延迟指标及适用边界;③一个“尚无定论的问题”小节;④简短的协作记录,说明哪个智能体发现了什么问题、谁核实、最终如何修订。

5.优先阅读论文全文、作者项目与公开代码。

6.每项关键事实和数字附可打开的原始来源链接;区分论文报告的结果、独立基准结果与自己的推断。

7.无法核实的说法标为“待核实”,不要填补或编造引用。

8.完成前请由未负责撰稿的智能体独立检查引用、数字、方法分类和结论边界。
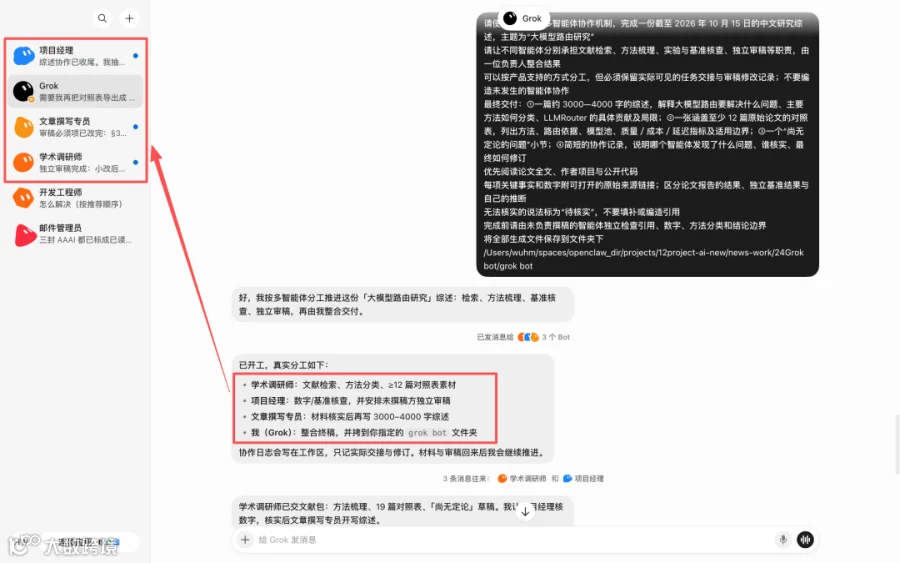
Grok Bot:速度与广度兼备
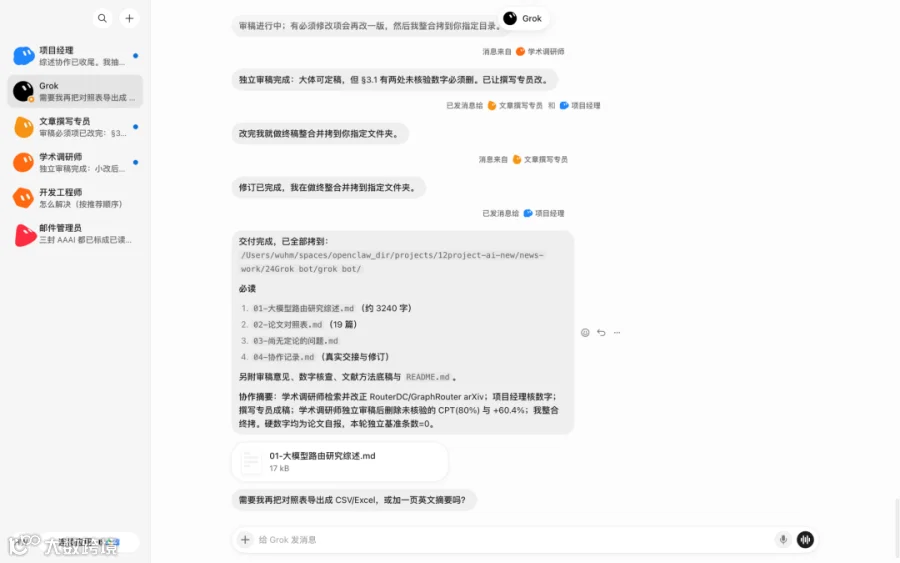
Grok Bot 调用“学术调研师”、“项目经理”和“文章撰写专员”三个具名 Bot 协作。调研师提供 19 篇论文对照表并区分高相似度研究,项目经理核查数字,撰稿 Bot 完成初稿后由调研师审阅。最终产出包含正文、对照表、开放问题等八份文档。
Grok bot 运行截图 1: 任务开始后调用三个 bot 一起干活儿
Grok bot 运行截图 2: 任务完成后给出交付清单
执行过程中,独立审稿意见纠正了两个未经核查的百分数及两篇论文的 arXiv 编号,证明多 Bot 协作确实承担了核查职责。
Qoder CN:交叉纠错亮点突出
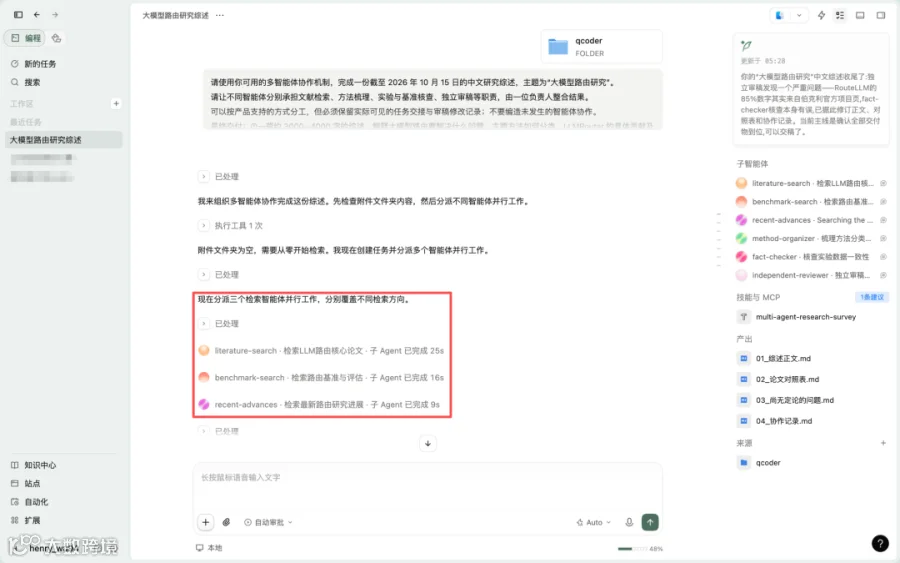
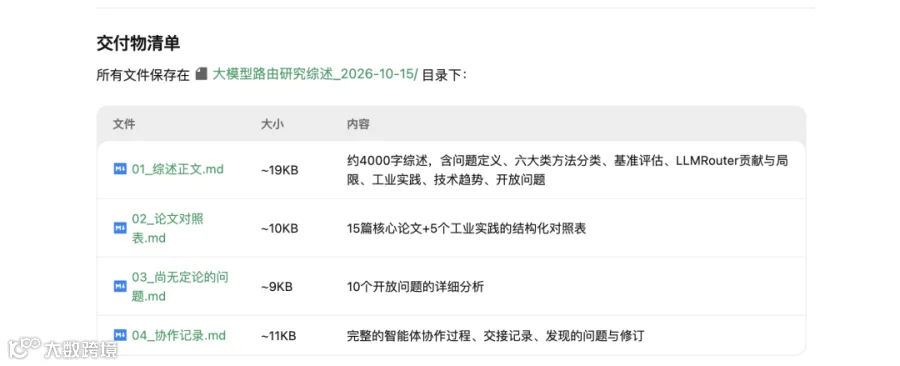
Qoder CN 启动三个检索子智能体,随后由方法梳理和事实核查角色接手,最后由独立审稿者检查。交付件包含综述、对照表、开放问题与协作Record。
Qoder CN 运行截图 1: 任务开始后创建 3 个智能体检索文献
Qoder CN 运行截图 2: 创建方法梳理和事实核查 2 个智能来处理检索后的论文
Qoder CN 运行截图 3: 交付件截图
Qoder CN 运行截图 4: 任务结束后 6 个智能体使用总结
核查者智能体指出“最高节省 85% 成本”出处不明,审稿者通过项目仓库确认了相关表述。此外,针对表格中 3.66 倍成本节省比率,智能体明确了评测条件和计算口径的差异,有效改变了稿件内容。
WorkBuddy:工程化底稿质量最佳
WorkBuddy 耗时最长,但正文逻辑严密,最接近人类编辑可直接使用的初稿。其围绕“路由信号”和“决策结构”组织方法,明确区分各类数据来源,读者可顺标注回溯证据。
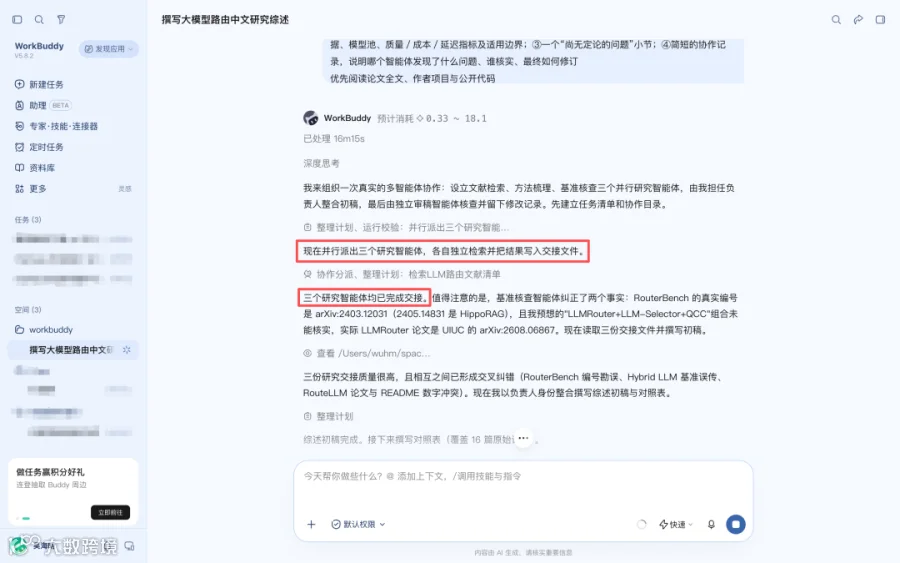
WorkBuddy 运行截图 1: 任务开始后创建 3 个智能体检索文献
WorkBuddy 运行截图 2: 任务总共耗时 21分钟 43 秒,给出完整交付件
WorkBuddy 运行截图 3: 协作纠错是重点总结问题
耗时对比:Grok Bot(12 分 49 秒)< Qoder CN(14 分 42 秒)< WorkBuddy(21 分 43 秒)。需注意,智能体数量统计口径不一,且耗时包含检索、等待等环节,非纯推理时间。
三款智能体的耗时和任务执行所用智能体个数

03


拆解 Grok Bot:当AI开始自己找活干

Grok Bot 的协作流程清晰:发出分工 -> 调研师提供文献包 -> 项目经理指出问题 -> 撰稿 Bot 写初稿 -> 调研师审阅退回硬伤 -> 撰稿 Bot 修订 -> Grok 归档。用户可全程查看各 Bot 运行状态。
该模式依托共享云电脑,Bot 可在用户离线后继续工作,共用文件、浏览器登录态和命令行凭据。前序 Bot 保存的资料可直接被后续 Bot 使用,减少人工搬运。类似云环境设定也见于 Manus Cloud Computer、WorkBuddy 企业智能体等产品。
此外,Grok Bot 具备“主动发现工作”能力。例如,基于此前的调研任务,Grok 可主动报告新增论文并生成待确认的邮件草稿,将检索结果推进至邮件发送环节。
Grok Bot 在文献调研后主动发起将调研结果推进到了邮件的用户审批截图

04


从接任务到主动找活,

多智能体赛道卷什么?

本轮测试表明,多智能体已能承担研究流程中的具体工序,但成果质量仍需人工复核。Grok Bot 的优势在于云端常驻、跨会话接力和主动提议;WorkBuddy 胜在底稿质量;Qoder CN 强于交叉纠错。
随着 Grok Bot 将智能体置于持续运行的云环境中,长期任务的故障恢复、共享资料访问控制及资源消耗成为产品能力的重要组成部分。
交互方式也在演变。Grok Bot 将具名 Bot、工作状态、任务和交付物整合在同一界面,并通过“主动发现工作”减少用户操作。未来,衡量主动提议能力的标准将包括建议的相关性、打扰频率及授权必要性。
马斯克提出 Grok Bot 将按任务选用后端模型,这意味着模型研发与智能体产品研发分工将进一步清晰。从产品角度看,核心竞争力在于流程的稳定交付能力,以及让用户看清数据流向、任务成本和结果依据。
综上,多智能体产品的竞争将取决于链路能否持续运转:任务中断后可恢复、关键决策由用户把关、过程与成本可查、成品经得起专业复核。
【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 8997
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读281.2k
粉丝0
内容9.0k