大数跨境

VLM 在预测性空间推理上的缺口还有多大?21 个模型,最高准确率仅 58.0%

VLM 在预测性空间推理上的缺口还有多大?21 个模型,最高准确率仅 58.0% AI科技评论
2026-10-20
5
导读:空间专项模型反而不如通用模型?浙大庄越挺团队提出空间智能新基准
空间专项模型反而不如通用模型?浙大庄越挺团队提出空间智能新基准

    作者丨张岂萍

    编辑丨幸丽娟


空间智能正成为 AI 竞赛的核心战场。虽然视觉语言模型(VLM)已能处理部分静态空间问题,但在真实交互环境中,机器人需应对动作引发的场景变化。若仅告知模型“移动物体”或“旋转场景”而不提供变化后的画面,模型能否准确推断新的空间关系?
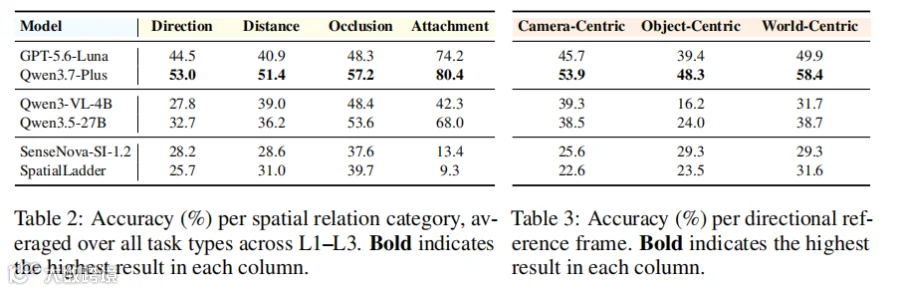
浙江大学庄越挺、沈永亮团队最新提出 SpaceCast-Bench,专门评估此类预测性空间推理(predictive spatial reasoning)能力。评测涵盖 21 个 VLM,结果显示最高准确率仅为 58.0%,远低于人类的 87.2%。更令人意外的是,6 个空间专项模型的准确率仅在 25.7% 至 29.1% 之间,接近随机水平,整体表现不及通用开放权重模型和闭源模型。
该研究由李弘幸、苏进越共同一作,沈永亮通讯,庄越挺、肖俊等参与。团队在空间推理领域积淀深厚,旨在通过新基准揭示当前模型在动态空间理解上的瓶颈。
论文地址:https://arxiv.org/abs/2610.12402

现有空间推理短板:难在变化之后

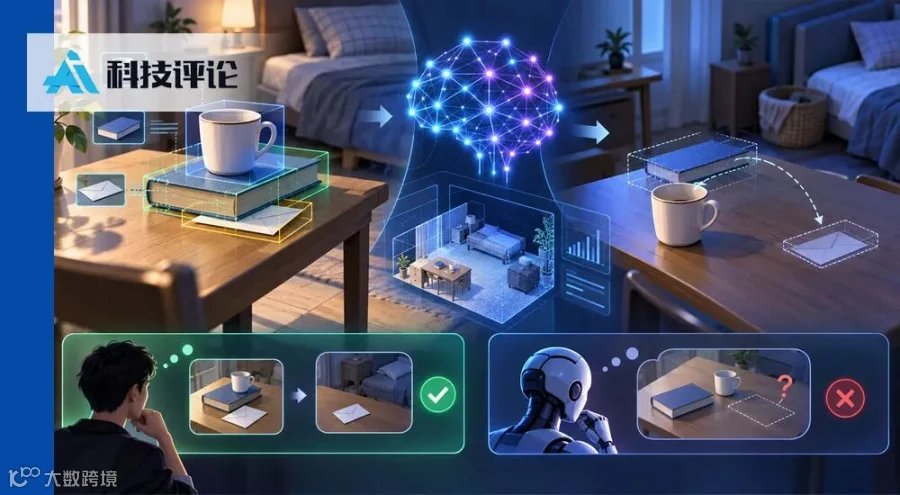
现有评测多聚焦于单图或多视角下的静态关系识别,即判断已呈现视觉信息中的物体关系。然而,真实操作往往涉及动态预测。例如,机器人若要取出书下的信封,需预判移开书本后场景的变化。
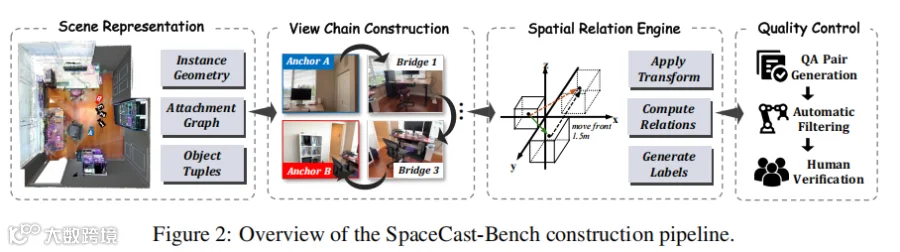
SpaceCast-Bench 采用 observe–transform–infer 框架:模型先观测当前场景,接收指定的空间变换指令,最后推断变化后的空间关系,且结果状态不直接以图片形式提供。

三层级拆解:测试预测性空间推理能力

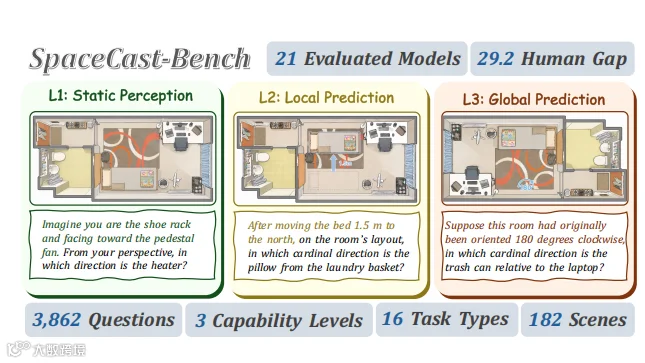
为区分静态感知与动态推理差异,SpaceCast-Bench 设定三个能力层级:
  • L1 Static Perception(静态感知):不改变场景,测试方向、距离、遮挡等基础关系,作为能力参照基线。
  • L2 Local Prediction(局部预测):涉及物体移动、旋转或移除,需考虑附着关系带来的联动变化。
  • L3 Global Prediction(全局预测):对整个场景布局进行整体旋转,要求模型在不同参考系下重新判断空间关系。
基准包含 182 个真实室内场景、3862 道问题和 16 类任务,覆盖相机中心、物体中心和世界中心三种参考系。

空间专项模型为何失守?

评测显示,空间专项模型总体得分接近随机基线,且低于通用模型。深入分析发现:
1. 全局预测能力薄弱:通用模型在 L3 全局预测上表现回升,而空间专项模型在 L3 上表现显著弱于 L2,说明其缺乏有效的全局空间表示及更新能力。
2. 附着关系理解不足:在处理物体联动(如移动书本带动杯子)时,空间专项模型准确率极低(如 SenseNova-SI-1.2 仅 13.4%),远低于通用模型。这表明现有专项训练未充分覆盖此类复杂物理关系。
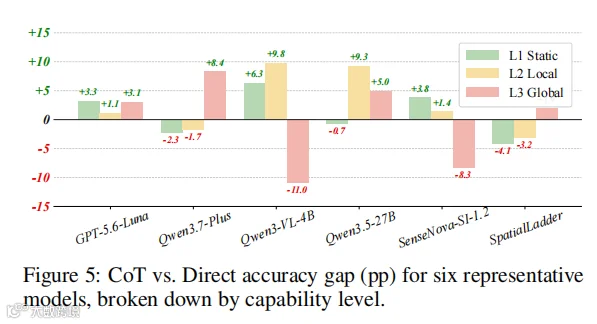
3. 思维链提示效果有限:引入 Chain-of-Thought 并未带来稳定的性能提升,表明单纯增加推理步骤无法解决空间信息整合的根本问题。

显式 3D 信息助力空间推理

研究测试了两种辅助信息对模型性能的影响:
1. 显式 3D 信息:包括鸟瞰图(BEV)和文本形式的 3D 元数据。结果显示,提供 3D metadata后,闭源模型平均提升 30.7%,通用开放权重模型提升 10.9%。这证明准确的 3D 空间表示是突破推理瓶颈的关键。
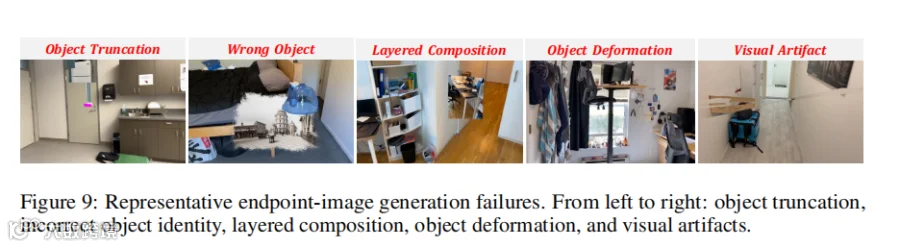
2. 生成式证据:利用图像生成模型预演变化后的场景。实验发现,生成结果常伴随物体缺失、形变等错误,导致模型推理准确率不稳定甚至下降。相比之下,受控任务中明确的 3D 空间信息比生成画面更可靠。

多视角整合与训练优化路径

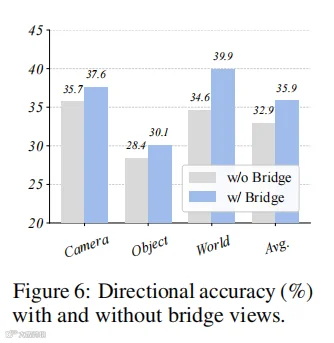
多视角整合:去除连接分散场景区域的“桥接视角后”,模型在世界参考系下的方向判断准确率显著下降。这说明模型尚不具备自动整合分散视角空间信息的能力,需要连续视角辅助。
训练效果:通过分阶段监督微调(SFT),Qwen3-VL-4B在 SpaceCast-Bench 上的准确率从 34.0% 提升至 65.7%,且在分布外基准上表现优异。关键在于训练数据需覆盖预测性空间推理任务。
需注意,SpaceCast-Bench 主要衡量受控空间变化下的预测能力,尚未涉及复杂物理动力学模拟。未来模型需进一步应对更复杂的物理交互和长期持续学习。

对话一作李弘幸:迈向真正的空间智能

▎AI 科技评论:为何从静态感知转向预测性推理?
李弘幸:真实物理环境中,智能体需在行动前预测后果。例如机器人移动桌子时,需预判桌面物体的联动及对环境的影响。这是 VLM 迈向具身交互和复杂任务规划的关键一步。
▎AI 科技评论:中间最大的挑战是什么?
李弘幸:在于建立稳定、完整且可动态更新的空间表示。当前模型难以形成跨视角一致的三维理解,且缺乏可靠的状态更新能力,尤其在处理物体联动和全局旋转时容易出错。
▎AI 科技评论:为何采用 observe–transform–infer 框架?
李弘幸:该框架将推理拆解为独立环节,且不直接提供结果画面,从而能精准定位模型在空间感知、状态更新或关系推断哪个环节存在缺陷。
▎AI 科技评论:空间专项模型表现不佳的原因?
李弘幸:现有专项训练仍侧重静态感知,忽视了空间变化预测和动态状态更新。导致模型虽能识别物体,却无法正确维护三维关系,能力难以迁移至预测性任务。
▎AI 科技评论:显式 3D 信息的启发?
李弘幸:准确的空间表示与推理能力同等重要。显式 3D 信息能显著降低推理难度。未来,显式三维表示与生成式世界模型可能形成互补:前者提供稳定结构,后者预测动态变化。
代码:https://github.com/ZJU-REAL/SpaceCast-Bench
数据:https://huggingface.co/datasets/hongxingli/SpaceCast-Bench   
【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 8997
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读281.2k
粉丝0
内容9.0k