


是石科技发布TokenFleet,聚焦GPU集群有效产出
在2026 CCF全国高性能计算学术大会期间,独立第三方全栈算力运营商是石科技(METASTONE)正式发布新品TokenFleet分布式调度框架。该框架旨在解决GPU集群中请求排队与资源闲置并存的痛点,通过优化请求路由、跨机房容量协同及混合负载治理,提升现有算力的有效产出。
若将推理服务比作“国产Token优化工厂”,GPU为生产设备,推理实例为工位,业务请求为订单,TokenFleet的核心职能即是实现订单与产能的高效匹配。在规模化服务场景下,不同任务类型与分配策略直接决定等待时间与达标产出,TokenFleet致力于在模型质量、服务要求与算力预算一致的前提下,提高有效Token产出,降低单位有效产出的成本。
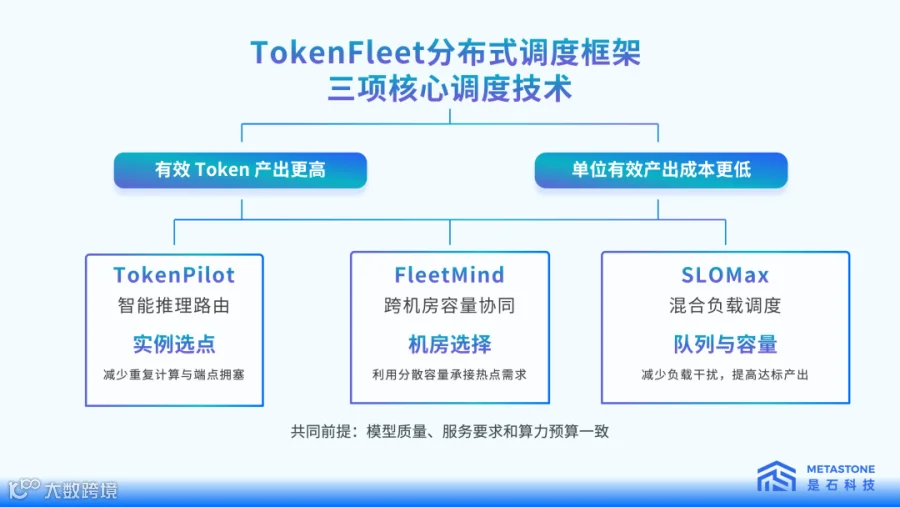
△图1 TokenFleet三项核心调度技术总览
TokenPilot:统筹缓存收益与排队代价
针对单一模型池内的实例选择问题,TokenPilot解决了仅按请求数量分流导致的负载不均难题。由于短问答与长文档在计算与显存消耗上差异巨大,且KV缓存复用能减少Prefill阶段的重复计算,但高缓存命中实例往往伴随较长排队时间,TokenPilot在选点时同时估算缓存复用收益与排队代价。
该组件结合输入规模、输出预算及可复用前缀预估工作量,综合队列长度、在途Token、KV缓存压力与预测延迟,对候选实例进行评分筛选。调度器据此判断复用缓存节省的计算时间是否能抵消额外等待成本。

△图2 TokenPilot智能推理路由框架
基于GLM5.3的调优数据显示,在特定显卡集群与负载条件下,采用预测延迟路由后,P95首Token延迟降低32.4%,P50首Token延迟降低71.3%。P50反映中位水平,P95反映尾部请求等待情况,响应改善需结合吞吐与资源占用综合评估成本收益。
△表1 TokenPilot首Token延迟调优结果。数据来源:是石科技大会演讲材料。改善率按(基线值-优化值)÷基线值计算;延迟下降不直接等于成本下降。
FleetMind:实现跨机房服务容量协同
在多机房部署场景下,有空闲GPU并不意味着能立即接单,还需考量模型部署状态、版本匹配、服务端点就绪情况及网络传输耗时。FleetMind关注实际可用的模型服务容量,汇聚各机房的模型可用性、实时容量与网络状态,先选择执行机房,再由本地决策引擎选择具体推理实例。
当热点机房出现排队时,系统会评估其他机房是否存在同版本模型的就绪端点及服务余量,在满足权限和数据地域约束的前提下,综合比较回源时延、排队、计算、缓存与传输成本,判断是否承接允许跨地域执行的新请求。通过短周期调整新请求去向与长周期调整模型副本及预热位置,结合容量预留与自动回退机制,减少容量错配和重复预留。

△图3 FleetMind跨机房执行框架。说明:A地为业务入口,不计入GPU容量池;B地为现有集群,C、D地为扩展机房。
SLOMax:基于服务等级的混合负载治理
面对实时对话、长上下文处理及离线批量任务等不同交付要求的混合负载,统一队列易引发资源争抢。长Prefill、KV容量压力和批量负载可能挤压交互请求,导致超时、取消与重复执行,造成计算资源浪费。
SLOMax通过识别输入长度、输出预算、任务类型与租户服务目标来界定工作量,实施等级准入、分池排队及容量协调,保障交互容量并控制长短请求的并发干扰。其核心优化指标为Goodput(达标输出吞吐),即完整测试时段内,成功完成且满足约定服务要求的请求所产生的输出Token总量除以测试时长。

△图4 SLOMax分类队列与容量反馈框架。说明:效果反馈用于调整容量与准入,框架不预设运行中任务抢占能力。
系统将达标吞吐、失败、取消与重复执行情况反馈给调度策略,持续动态调整准入和容量比例。在GLM5.3收益测算示例中,采用流控协同调度后,总输出吞吐增加约1.5%,达标输出吞吐提高约29.4%,达标比例从约67%升至约86%。这表明在同等总产出下,减少无效计算可显著交付更多达标Token。
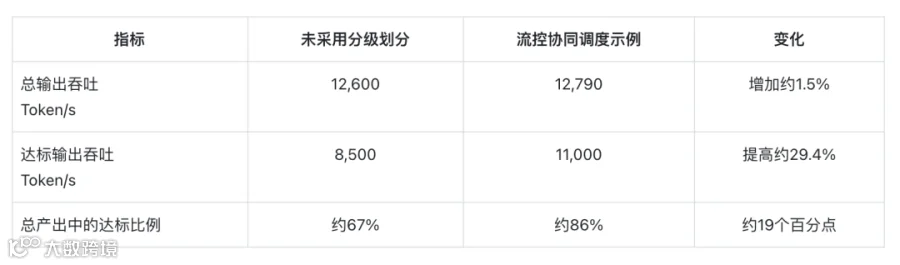
△表2 SLOMax有效Token吞吐收益测算示例。数据来源:是石科技大会演讲材料。本表为收益测算示例;达标比例沿用原文取整值,变化约19个百分点。
从单点效率到集群调度的全栈优化
是石科技作为一家不绑定特定大模型厂商的独立第三方全栈算力运营商,提供涵盖硬件、组网、调度、优化与运营的一站式服务。凭借源自国家级计算中心的经验,其算力集群运行SLA达到99.95%以上,目前已纳管超过20000P+算力资源,运营10多个超智算中心,其中包括2个国家级超算中心。
相较于此前发布的聚焦单实例执行效率的Meta-Infer高效推理引擎,此次推出的TokenFleet将优化重心延伸至集群调度层面。通过精细化分配每一次请求与每一份容量,是石科技致力于让通用、高频的推理服务更经济,充分释放国产算力潜能,助力行业实现从“用得起”到“用得好”的跨越。