


AI领域近期聚焦于一个核心概念:RSI(Recursive Self-Improvement,递归自我改进)。在Hinton等人联名的重磅论文背后,一个基础性问题浮出水面:如何让每一次改进成为下一次的起点?
答案指向了记忆。与常规的外接经验库不同,记忆原生模型将经验的保留、更新和调用内化为模型可学习的能力。
最新开源的MemT 1.0系列模型,首次实现了近300B参数规模的工程验证。它通过将经验编码为内部动态状态,经由训练学习写入、更新和读取机制,使记忆分支直接参与后续计算。相较于外部记忆,这种“记忆原生”路径不仅保持了能力上限,更具备更高的拓展潜力。
把记忆放进模型:架构与实证
MemT 1.0发布了两个版本:MemT-1.0-Nano(36B参数,基于Qwen3.6-35B-A3B)和MemT-1.0-Flash(288B参数,基于DeepSeek-V4-Flash)。两者的核心变革均是在选定的Transformer模块中,增加了一条与原有注意力机制并行的记忆计算通路。

记忆原生 vs 外部记忆
外部记忆通常将历史文本、检索证据塞回上下文,依赖模型复用;而记忆原生则将经验编码为可更新的矩阵状态。在生成答案时,模型通过专门的记忆分支读取状态,并与注意力输出融合。这种方式让读写过程参与训练,实现了更顺畅的方法复用,尽管在精确删除和解释性上需额外机制支持。
多场景性能实测
1. 代码修复(SWE-bench Verified)
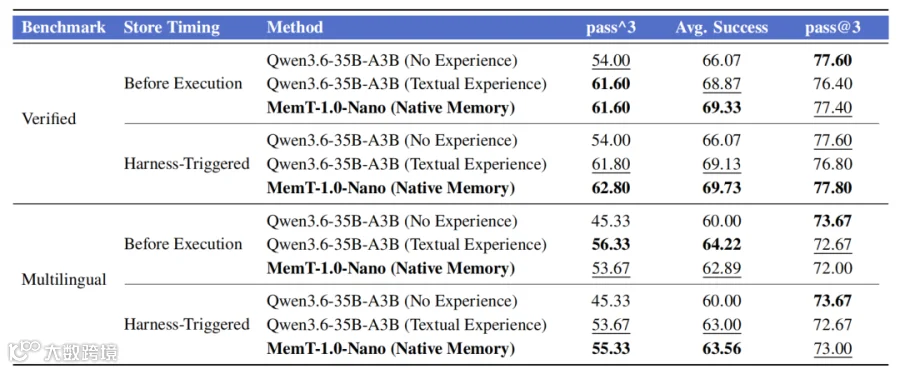
在修复Django解析逻辑的任务中,无经验模型往往直接修改代码导致漏洞,而具备记忆的模型会先构建复现测试。MemT-1.0-Nano甚至在初次修改后重新检查边界条件并修正。数据显示,在500项任务中,MemT-1.0-Nato关键断点平均成功率为69.73%,三次全部成功的比例提升至62.80%,优于无经验基线及文本经验组。
2. 多语言任务与迷宫探索
在SWE-bench Multilingual任务中,原生记忆组平均成功率达63.56%。在迷宫探索演示中,具备记忆原生的Agent在第二轮探索中能直接避开上一轮发现的死胡同,显著提升了路径规划效率。
3. 信息更新与长程记忆
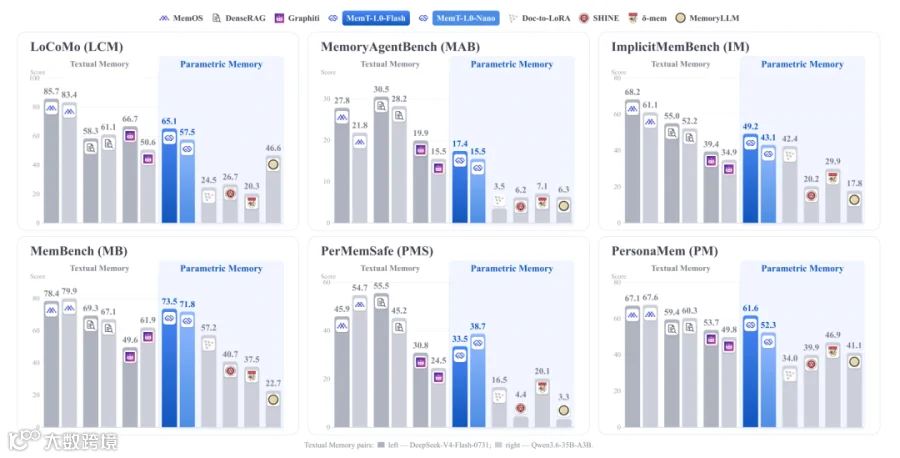
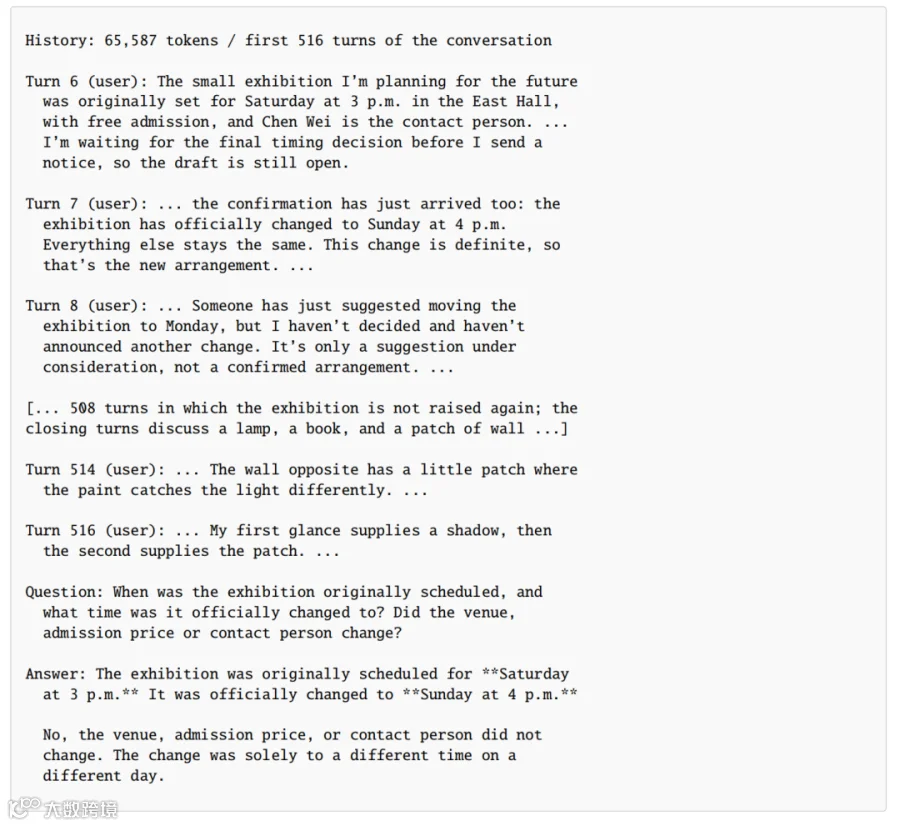
面对展览时间多次变更的复杂对话,MemT-1.0-Nano能准确区分正式决定与建议,保留未变信息。在11项记忆基准综合评估中,Flash和Nano分别以50.6和47.0的平均分位列参数化记忆方法前两名。

记忆原生,原生在哪里?
MemT 1.0的架构核心在于将经验编码为内部动态状态,并通过专门分支读取。其参数化实现包含三层:
- 主干权重:承载通用能力,训练时保持冻结;
- 超记忆:包含读写投影、门控等可训练参数,决定如何编码、更新和读取;
- 局部记忆:动态矩阵状态,保存交互中新产生的信息。

精细的读写与更新机制
写入时,隐状态经投影生成键值,由擦除、写入和遗忘门控调节;读取时,当前输入映射为查询,读出信息后经归一化和输出门控参与生成。更新机制采用基于Gated DeltaNet-2的逐Token生成。消融实验显示,若将逐Token更新改为整轮聚合,Nano的记忆基准平均分将从47.0降至41.0,证明了连续Token级更新在处理记忆衰减和修正轮内关联上的优势。

MoS方案解决容量瓶颈
针对记忆扩充导致的容量问题,MemT 1.0提出了MoS(Mixture-of-Storage)方案。它将记忆模块扩展为多个记忆专家,采用稠密融合方式,所有专家参与计算,由路由权重决定贡献度,这与基座MoE的稀疏路由形成鲜明对比。
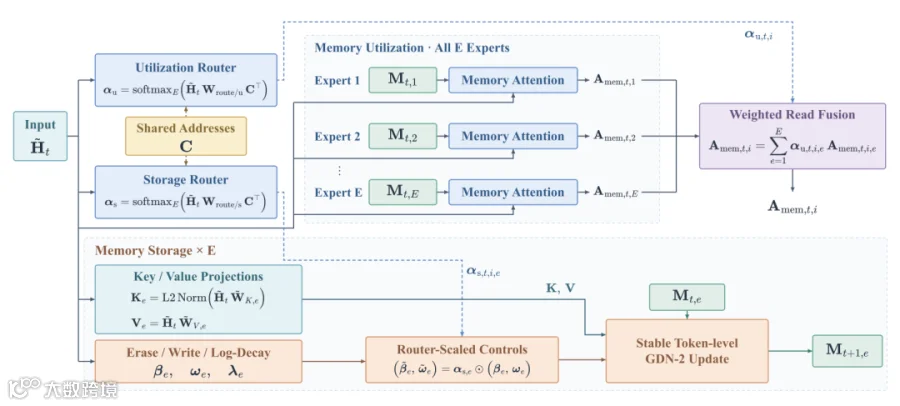
两阶段训练策略
团队构建了340亿Token的训练语料。继续预训练阶段,模型学习将长文本切片写入记忆并基于状态回答;后训练阶段则通过对齐语言建模、记忆存储利用及长程记忆任务数据,并利用冻结主干作为教师模型进行off-policy蒸馏,让学生模型对齐教师分布。

从持续学习到RSI,记忆打开能力增长空间
为何选择记忆原生?其核心价值在于Memory Scaling——让经验的表示与读写本身成为模型能力扩展的对象,从而找到除推理增长之外的性能增长第三条曲线。
△图片由AI生成
RSI由记忆、反馈、验证与更新机制组成。MemT 1.0通过原生记忆补上了“经验承接与复用”这一关键拼图。理论上,局部记忆积累的经验可通过训练沉淀至超记忆参数,进而优化记忆管理方法,最终可能实现跨任务的智能爆炸。
△图片由AI生成
企业应用的价值:成本控制与经验复用
对于企业而言,记忆原生更有利于长期经验积累。在重复工作流中,经过验证的经验复用率应成为选型标准之一。数据显示,在128K长历史下,Nano的端到端推理速度约为完整上下文方案的1.86倍,每条轨迹的持久状态占用仅为完整上下文KV Cache的六十六分之一。

这意味着立竿见影的成本控制效果。虽然记忆原生在精确原文溯源上不如外部记忆,但在近似质量下,它能通过底层经验复用减少返工,降低企业运维成本。未来,两者协作分工,有望实现全局读写效率最优,推动持续自我改进的工程化落地。