

传统文生图在海报设计等场景下,常因排版不可控而陷入“抽卡”困境。10月16日,OpenMOSS团队开源MOSS-Image,提出“版式即输入”的新范式:通过结构化JSON定义元素位置与内容,模型依框生成。该项目发布MOSS-Image-Base及SFT微调版,代码与权重均采用Apache-2.0协议,旨在可控性与文字渲染能力上对标闭源商业模型。
技术架构:大编码器与小主干的协同
MOSS-Image-Base采用42层扩散Transformer(DiT)主干、Qwen3.5-9B文本编码器及FLUX.2 VAE的组合。其核心特征在于编码器参数(9B)大于主干参数(5B),这种非典型比例意在强化对长提示词(支持4K token)及复杂排版指令的理解能力,而非单纯依赖生成模型的绘画能力。
- 文本编码器:负责深度理解整张海报的文案及元素描述。
- 扩散主干:5B参数规模兼顾推理成本与微调门槛。
- VAE:负责将潜在空间数据还原为像素图像。
推理默认配置为Flow-matching Euler采样,50步,CFG 3,并在第22层对无条件分支执行跳层以优化算力。

MOSS-Image 架构示意图
核心创新:结构化JSON定义版式
MOSS-Image摒弃了通过自然语言描述排版的模糊方式,转而使用结构化JSON作为输入。该结构包含三层信息:
summary:定义画布整体风格与主题。items:定义具体元素,包括类型(label)、视觉描述(caption)、文本内容(text)及位置边界框(bbox)。- 坐标约定:
bbox_coord_space与bbox_format。
坐标系统采用以画布中心为原点的绝对像素坐标,格式为[上, 左, 下, 右](yxyx)。在1024×1024画布中,坐标范围为-512至+512。这种设计使得版式可通过程序批量生成或通过UI交互调整,将“排版”从生成难题转化为确定的输入条件,实现了结果的可复现性与工程化调用。
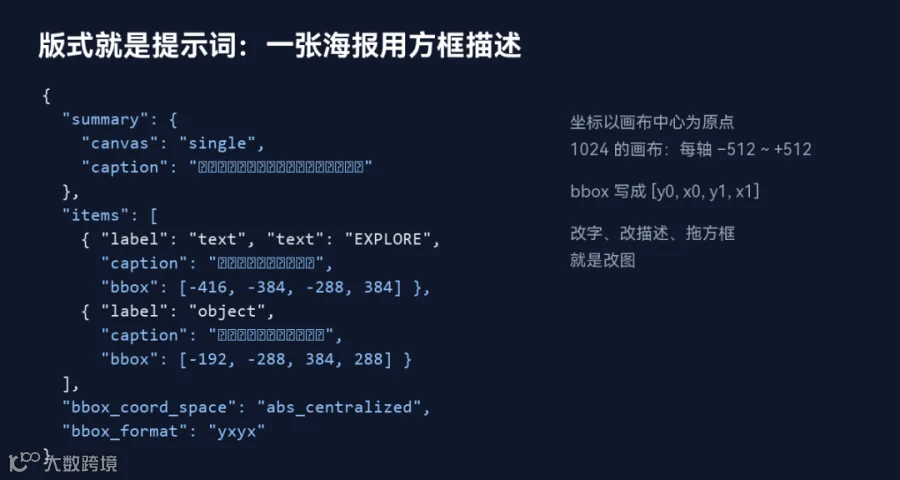
版式JSON结构示例
强化文字渲染能力
针对文生图模型常见的文字乱码痛点,MOSS-Image将“要写的字”(text字段)与“视觉风格描述”分离。前者确保字符准确性,后者控制美学风格。结合4K token支持及动漫/写实双风格覆盖,该模型专注于批量生产具备准确文字与规范版式的商业素材,如电商主图、海报及包装设计方案。
生态配套与商用友好性
MOSS-Image在发布初期即提供了完善的工程化支持:
- 推理框架支持:原生支持SGLang与vLLM-Omni,便于快速服务化部署。
- ComfyUI集成:提供原生插件及示例工作流,并计划并入ComfyUI主干。
- 辅助工具:内置Prompt Enhancer技能,可将自然语言转换为版式JSON;提供像素草稿转中心坐标脚本。
- 显存优化:提供常驻GPU、CPU/GPU动态调度、顺序加载三档模式,适应不同硬件环境。
此外,项目支持异构GPU训练,且代码与模型权重均遵循Apache-2.0许可证,极大降低了企业商用的法律与技术门槛。
局限性与应用展望
尽管MOSS-Image在可控性上取得突破,但仍存在以下挑战:
- 版式细节上限:JSON仅定义位置骨架,字体、字重及背景融合等审美细节仍依赖模型自身判断,批量生成的一致性需进一步验证。
- 画质天花板:5B主干在极致质感、复杂肢体及密集人群处理上,可能略逊于超大参数模型,其定位更偏向生产力工具而非艺术创作玩具。
- 多元素稳定性:在多文字块、无遮挡的复杂排版场景下,稳定性仍需结合具体业务需求进行测试。
总体而言,MOSS-Image填补了中文开源领域在“可控版式+准确文字+宽松协议”方面的空白。它将文生图的输入从自然语言推进至可编程的结构化数据,为设计自动化流水线提供了关键基础设施。对于需要精确排版的海报生成场景,MOSS-Image提供了一种将部分人工PS工作前置到模型输入阶段的高效解决方案。