

缘起:复旦开源 5B 文生图模型 MOSS-Image
MOSS-Image 是复旦大学 OpenMOSS 团队于 2026 年 10 月开源的文生图模型。其核心架构包含一个 50 亿参数的扩散 Transformer,搭配 Qwen3.5-9B 作为文本编码器,以及 FLUX.2 VAE 作为解码器。
该模型两大核心卖点直击当前文生图痛点:布局控制(支持通过 JSON 边界框指定元素位置)和强文字渲染能力(确保图中文字清晰准确)。本次评测旨在验证这两项能力,并将本地 ComfyUI 从半年前的版本升级至最新主线。
环境与起点
| 项目 | 情况 |
|---|---|
| 显卡 | NVIDIA RTX 3060,12 GB 显存 |
| Python | 3.11.6(conda),PyTorch 2.9.1+cu130 |
| ComfyUI | v0.38.0,落后主线 115 个提交 |
| 已有自定义节点 | 114 个 |
升级:从 0.38 到 0.42
在工作区无本地改动的情况下,执行以下命令直接升级:
git fetch origin master --unshallow
git reset --hard origin/master # v0.38.0 -> v0.42.0
升级后发现关键事实:0.42.0 的 HEAD 提交已原生支持 MOSS-Image(Commit: Support MOSS-image color-depth control #17206)。
证据链完整:comfy/supported_models.py 中已注册 MOSSImage 类;comfy/model_detection.py 可通过特定权重键自动识别 MOSS 模型;comfy/text_encoders/moss_image.py 提供原生分词器;CLIPLoader 下拉菜单新增 moss_image 选项;comfy_extras/nodes_moss_image.py 提供布局与色彩/深度控制节点。
因此判定:第三方插件 comfyui-moss-Image 不再必要,建议改用原生链路。原生实现内置 {"shift": 5.0},而插件默认 shift 为 1.0 且需手动挂载 ModelSamplingSD3,两套配置共存易导致采样参数冲突。已将插件移至 custom_nodes_disabled/。
依赖包仅需对齐以下五个:
| 包 | 升级前 | 升级后 |
|---|---|---|
| comfy-aimdo | 0.5.5 | 0.5.6 |
| comfy-kitchen | 0.2.36 | 0.2.39 |
| comfyui-frontend-package | 1.52.7 | 1.55.18 |
| comfyui-embedded-docs | 0.5.12 | 0.5.14 |
模型文件来源
采用 Comfy-Org 提供的量化版,共三个文件,总计约 15.4 GB:
| 组件 | 文件 | 大小 |
|---|---|---|
| DiT | moss_image_sft_int8_convrot.safetensors |
5.04 GiB |
| 文本编码器 | qwen3.5_9b_int8_convrot.safetensors |
9.08 GiB |
| VAE | flux2-vae_small.safetensors |
0.23 GiB |
启动故障排查
升级后启动 ComfyUI,服务虽显示就绪(v0.42.0),但十几秒后端点开始超时,/object_info 无法返回内容。这是典型的事件循环被同步调用阻塞。
鉴于排查 114 个自定义节点成本过高,采用纯净模式启动:
main.py --listen 127.0.0.1 --port 8189 --disable-all-custom-nodes
纯净实例 12 秒就绪,moss_image 选项及相关节点全部在线。这证实:MOSS-Image 的核心功能完全依赖原生实现,无需任何第三方节点。
采样参数设置
| 参数 | 值 |
|---|---|
| 采样器 | euler |
| 调度器 | sgm_uniform |
| 步数 | 50 |
| CFG | 3.0 |
| Shift | 5.0(原生内置) |
| 跳层引导 | single_layers = 22 |
| 分辨率 | 16 的倍数 |
原生 MOSSImage 的 memory_usage_factor 为 14.6。在 12 GB 显存下,运行 1024×1280 分辨率时显存占用约 11.5 GB,处于临界状态;1536×1024 分辨率虽未溢出内存(OOM),但余量仅数百 MB。
评测方法:三维交叉验证
为确保评测客观性,采用三种可复现手段:
一、客观指标。 使用 Laplacian 方差衡量清晰度,Hasler-Süsstrunk 公式计算色彩丰富度,并统计量化色数、平均亮度、对比度、高光/暗部截断比例、平均饱和度及灰阶层次。
二、视觉描述。 利用 Florence-2-large 在 CPU 端生成详细描述,与原始提示词逐条比对,检查关键要素缺失情况。
三、OCR 验证。 专门针对 MOSS-Image 招牌的文字渲染能力,通过 OCR 任务检查图中文字准确性。
十场景实测数据与分析
| # | 题材 | 分辨率 | 耗时 | 清晰度 | 色彩 | 色数 | 平均亮度 | 饱和度 |
|---|---|---|---|---|---|---|---|---|
| 01 | 写实人像 | 1024×1280 | 117.6s | 7.1 | 28.7 | 247 | 0.54 | 0.23 |
| 02 | 自然风景 | 1536×864 | 108.5s | 72.2 | 59.9 | 514 | 0.41 | 0.38 |
| 03 | 文字海报 | 1024×1408 | 123.6s | 151.9 | 85.0 | 504 | 0.65 | 0.38 |
| 04 | 二次元 | 1024×1408 | 123.7s | 38.3 | 61.2 | 417 | 0.21 | 0.48 |
| 05 | 产品摄影 | 1024×1024 | 87.3s | 48.4 | 12.9 | 217 | 0.21 | 0.14 |
| 06 | 美食特写 | 1024×1024 | 87.5s | 120.6 | 64.7 | 784 | 0.44 | 0.55 |
| 07 | 建筑室内 | 1536×1024 | 138.7s | 119.4 | 37.9 | 403 | 0.50 | 0.35 |
| 08 | 科幻赛博 | 1536×864 | 114.6s | 103.6 | 78.2 | 1579 | 0.21 | 0.69 |
| 09 | 中国水墨 | 864×1536 | 114.6s | 145.0 | 4.7 | 67 | 0.75 | 0.04 |
| 10 | 信息图 | 1024×1408 | 126.6s | 97.0 | 13.8 | 112 | 0.95 | 0.03 |
十张图平均耗时 114 秒,总计约 19 分钟。
数据分析显示:水墨图色彩丰富度极低(4.7)、色数少(67),证实成功压制成单色调;赛博朋克图色数高达 1579,霓虹堆叠效果显著;信息图高亮低饱和,符合白底扁平设计风格;产品图暗部截断率高,契合暗调布光需求。
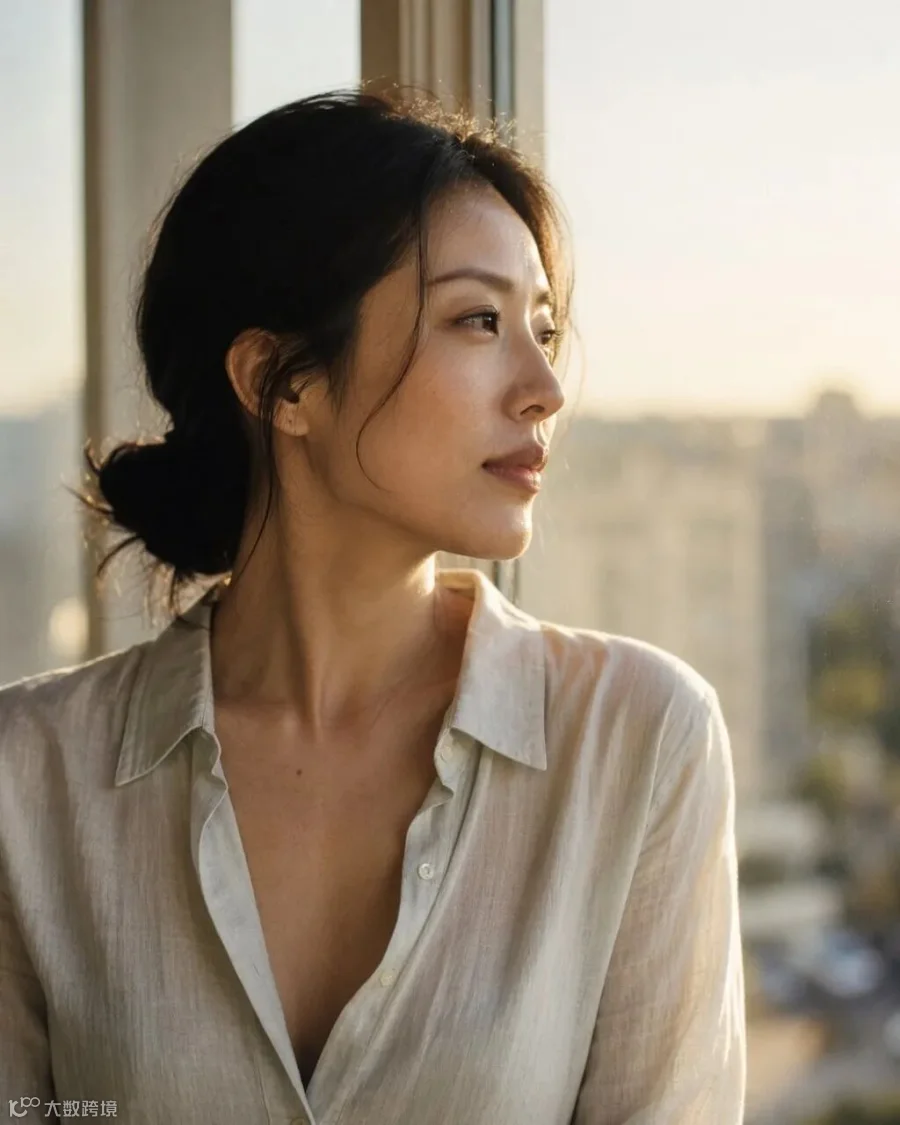
01 写实人像
写实人像
Florence-2 描述吻合度高:窗前年轻女性,浅米色上衣,松散发髻,背景城市虚化,光线柔和。清晰度 7.1 较低并非缺陷,而是浅景深带来的真实背景虚化效果。12 GB 显存下皮肤质感细节够用,但未达毛孔级精细度。
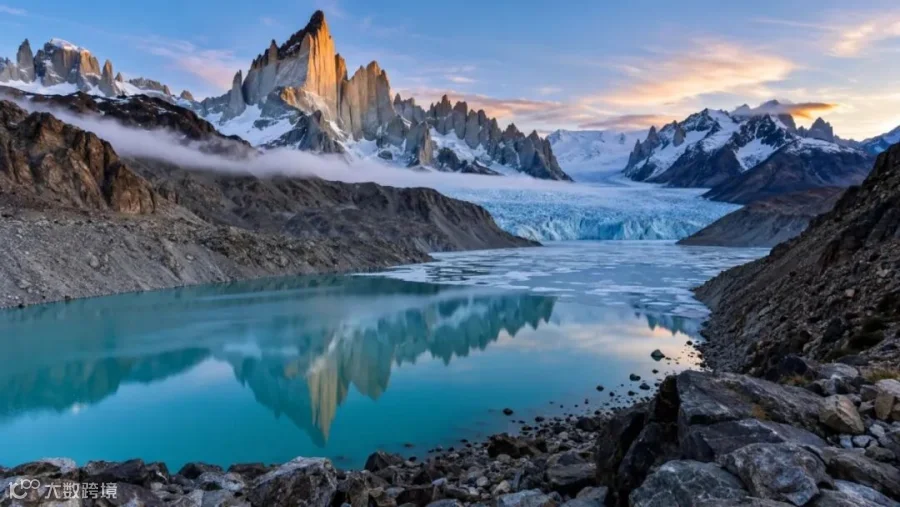
02 自然风景
自然风景
雪山、湖泊、橙粉天空及冰川倒影均准确呈现。清晰度 72.2 符合风光片全焦段预期,暗部截断率低至 1.26%,水面阴影处理得当,未出现死黑。此为全场最稳定输出。
03 文字海报:招牌能力验证

文字海报
OCR 结果:完美识别 "KYOTO" 和 "AUTUMN 2026",无一字差错。
这是本次评测的核心亮点。提示词要求的大号窄体大写标题及下方小字均精准渲染。清晰度 151.9 居全场第二,红漆鸟居、橙色枫叶的丝网印质感及瑞士风格排版均得到良好还原。对于文生图模型而言,准确拼写单词和年份标志着技术分水岭。
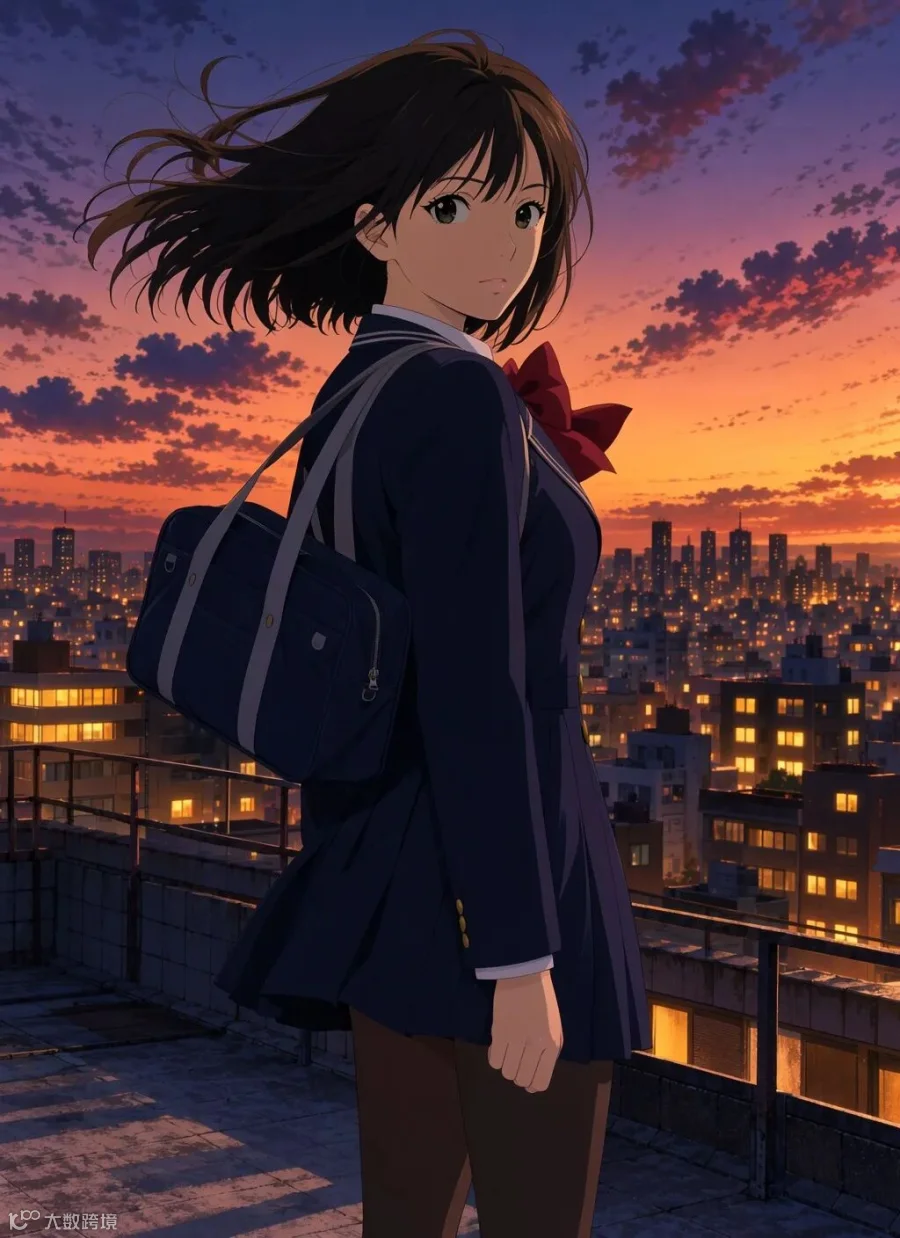
04 二次元
二次元
屋顶少女、藏青校服、红色领结等元素准确。赛璐璐描线与背景绘制具备日式动画水准。饱和度 0.48 偏高符合风格习惯,平均亮度 0.21 营造出合格的黄昏氛围。
05 产品摄影

产品摄影
黑色陶瓷滤杯的哑光质感与边缘轮廓光处理专业。暗部截断率 8.97% 为全场最高,配合低饱和度,正确呈现了暗调产品图风格。微小瑕疵在于水流动作细节略显含糊。
06 美食特写

美食特写
色数 784 居全场第二,食材层次丰富。饱和度 0.55 全场最高,有效激发食欲。"红油浮面"细节准确,俯拍构图干净利落。
07 建筑室内
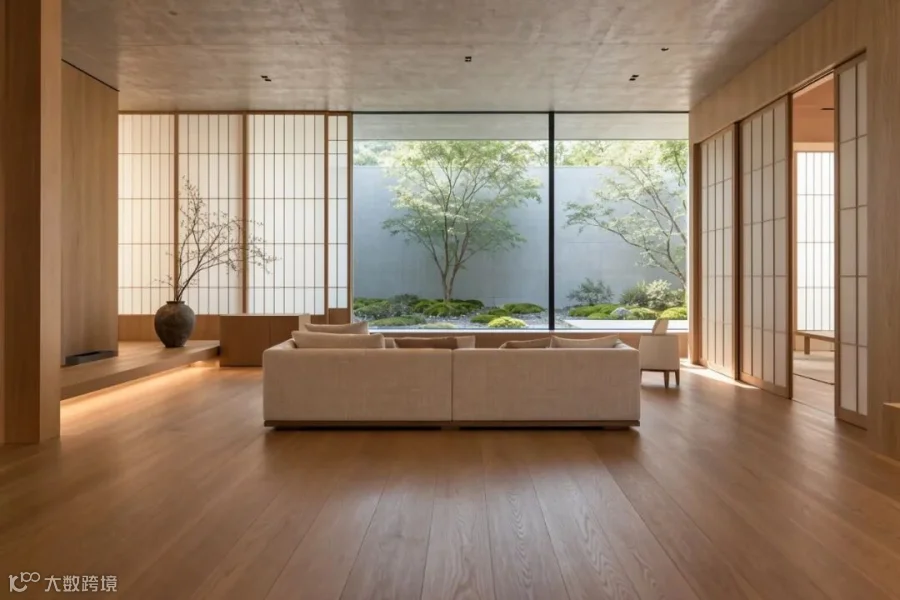
建筑室内
一点透视与几何分割准确,24mm 移轴空间感成立,清晰度 119.4 保证线条锐利。存在偏差:提示词为混凝土天花板与障子屏风,但描述中墙面被识别为木质,存在轻微材质语义漂移。
08 科幻赛博

科幻赛博
色数 1579 与饱和度 0.69 均居全场第一,霓虹与体积雾效果充沛。暗部截断率 9.22% 扎实。存在偏差:提示词为半透明雨衣,描述中人物却撑着伞,道具替换是当前扩散模型的常见通病。
09 中国水墨:风格化局限

中国水墨
构图元素(雾气、孤树、悬崖、留白)完全正确,但 Florence-2 将其识别为"黑白照片"而非"水墨画"。
原因在于画面缺乏水墨特有的笔墨语言(枯湿浓淡、宣纸纤维感),本质上是一张去色风景照。极低的色彩丰富度(4.7)和色数(67)证明其确为单色,但"单色"不等于"水墨"。这暴露了模型在深层风格化表达上的不足。
10 信息图:大字稳,小字崩
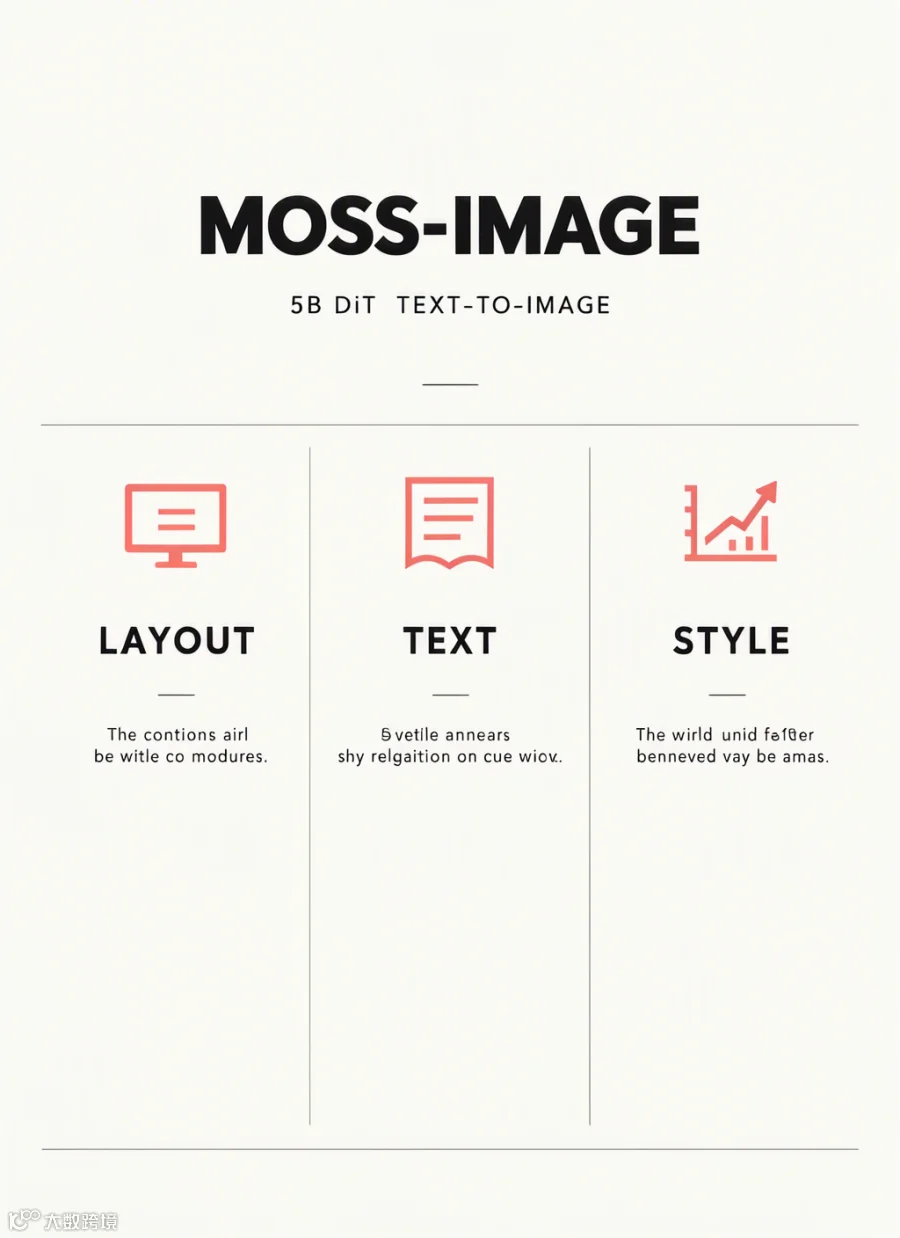
信息图
OCR 结果显示:大标题 "MOSS-IMAGE"、副标题及栏目标签 "LAYOUT/TEXT/STYLE" 全部正确。
但正文小字被识别为乱码。这揭示了当前文生图文字渲染的真实水位:大字号、短单词表现稳定;小字号、多行正文仍属于"画字"而非"写字"。尽管字形边缘清晰(清晰度 97.0),但语义层面并未正确生成。现阶段复杂排版仍需后期处理。
实测结论
优势:
1. 文字渲染领先: 大号标题级文字可一次成型,无需反复抽卡,在开源 5B 级别模型中属第一梯队。
2. 提示词遵循度高: 80% 测试图的关键要素、构图、光影及色彩倾向均准确落地。
3. 风格跨度宽: 同一套参数即可覆盖写实、动漫、水墨、扁平设计及暗调产品等多种风格,底座泛化能力强。
4. 硬件门槛适中: Int8 量化后,12 GB 显存可流畅运行 1536×1024 分辨率,单张耗时 87–139 秒,适合家用卡批量出图。
短板:
1. 小字号多行文字不可靠: 信息图正文生成失败,属硬性限制。
2. "笔墨语言"型风格偏弱: 能还原构图但缺乏笔触细节,易被误认为普通黑白照片。
3. 细节道具漂移: 如雨衣变伞、混凝土变木墙,语义级精确控制仍需借助布局或 ControlNet。
4. 显存开销大: memory_usage_factor 高达 14.6,12 GB 显存几无余量,难以并行其他任务。
总结:MOSS-Image 显著提升了"图里能写字"的能力,但距"图里能排版"仍有差距。 其布局控制能力有待后续深入评测。
资源下载与版本说明
资源获取
本文涉及的模型权重、工作流及评测素材已打包:
链接:https://pan.quark.cn/s/3d71d212cf40 提取码:r3zz
目录包含三个模型文件,共计 15.4 GB。
版本与建议
模型权重: 推荐下载 Comfy-Org 官方量化版。国内用户建议通过 ModelScope 下载,速度远快于 HuggingFace。
ComfyUI 版本: 必须使用 v0.42.0 或更高版本。此版本线原生支持 MOSS-Image,避免了旧版本依赖第三方插件及手动调整 shift 参数导致的兼容性问题。
工作流: 全程使用原生节点,零第三方依赖。参照前文参数表即可复现结果。