导读大小模型协同,难点不只在选谁答题,还在何时交接。火思动力(PyroMind Dynamics)的 PyroDash 让 4B 小模型先生成,再用控制符把已有草稿至多一次交给冻结大模型续写。它通过三阶段训练,将输入、输出分别计价的规则纳入强化学习奖励。在论文的数学基准与价格模型下,省钱档降本 96.4%,准确率低于纯大模型 3.13 个百分点;提分档则以更高的大模型参与度换来 6.36 个百分点的提升。两组结果揭示了这套分工的收益,也划出了适用边界。
本文 4364 字,阅读约 11 分钟
为什么要把路由决策放进生成过程
小模型先写,控制符触发一次单向交接
三阶段训练:从认识控制符,到学会怎样交接
降本 96.4% 与提分 6.36 个百分点,各自付出了什么
从数学推理到编程 Agent,还要核对哪些边界
为什么要把路由决策放进生成过程
把大小模型搭在一起省钱,工程上很容易想到让大模型当包工头、小模型当打工人:主控大模型先读题、拆任务,再把简单的局部工作分给小模型。
这能分摊工作,却有一笔固定开销:大模型已经读过完整输入。商用 API 通常分别收取输入和输出 Token(模型处理文本的基本单元)的费用;输入侧主要对应预填充(Prefill),输出侧对应逐步解码(Decoding)。即使任务本可由小模型独立完成,只要先经过大模型规划,就已产生一次大模型调用成本。
另一条路线是请求级路由。例如 RouteLLM 在生成前,判断整道题该交给小模型还是大模型。FrugalGPT 则采用级联:先调用较便宜的模型,评估答案后再决定是否升级。两者决策时机不同,但处理的单位都是一次请求或一份答案。
对于多步推理,困难可能到中途才暴露:前面只是读题、换元、列式,后面才进入复杂推导。请求前的路由无法利用尚未生成的中间步骤;答案级级联虽能事后升级,也没有直接提供在某个 Token 位置接续同一段推理的机制。
把决策移进生成过程,可以利用这些中间信息,但也会带来协调成本。CITER 用外部路由器逐 Token 选模型;RelayLLM、GlimpRouter 等方法允许大模型多次介入。对每次调用都需重新提交上下文的无状态 API,反复切换可能增加输入计费;实际金额还受缓存规则影响。
投机解码优化的则是生成速度:小模型先起草,大模型批量验证草稿,大模型仍参与整个生成过程。它与“简单题只由小模型完成,必要时才调用大模型”的目标不同。
沿着决策时机和大模型参与方式,可以看出几条路线的区别:
Agent 路由不只是选模型:还要分清治理和 GPU 调度
火思动力于 2026 年 7 月公开的 PyroDash,把路由变成小模型自己生成的一个动作:默认先写;需要帮助时,发出控制符并交出已有草稿。
小模型先写,控制符触发一次单向交接
PyroDash 由三个部件组成:可训练的小模型 M_s、参数保持冻结的大模型 M_l,以及执行交接的协同引擎(Collaborate Engine,CE)。论文实验分别使用 Qwen3.5-4B 和 GLM-5.2-FP8。这里的“冻结”指训练过程中不更新大模型参数,续写仍然需要计算。
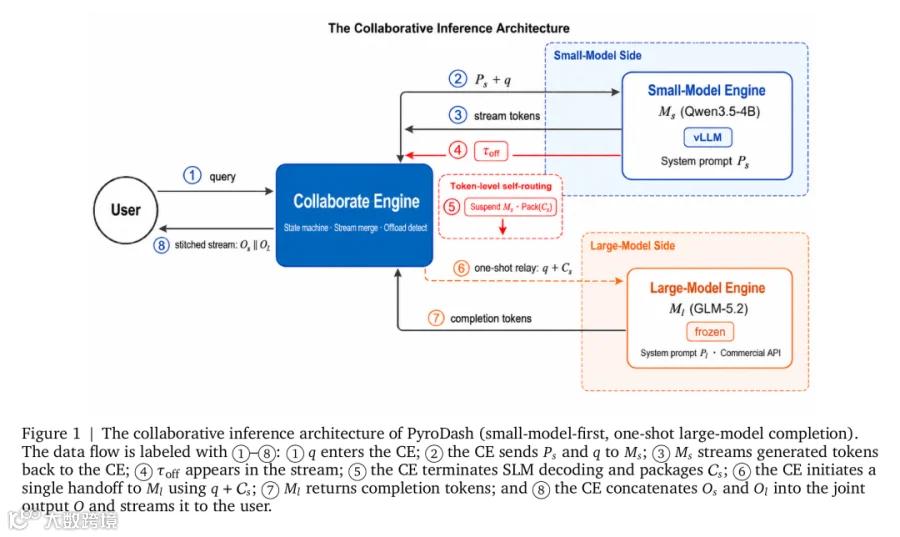 PyroDash 协同推理架构:小模型流式生成,控制符触发上下文打包与单向交接 | 来源:PyroDash 论文 v1,Figure 1
顺着图中的数据流,一次请求只走两条路径之一:
1.
小模型独立完成:原始问题 q 连同协同提示 P_s 交给小模型。若生成结束前没有出现交接控制符,CE 直接返回小模型输出,不调用大模型。
2.
中途交接给大模型:小模型生成 <|llm_offload|>(论文记作 τ_off),CE 检测到这个停止序列后终止小模型解码,剥离控制符,把已有草稿 C_s、原始问题 q 与续写提示 P_l 一起交给大模型。大模型续写到最终答案,CE 将两段输出拼接返回,控制权不再交回小模型。
决策由小模型作出,CE 负责执行。所谓 Token 级自路由,是小模型可以在生成某个 Token 时触发交接,并非大小模型必须逐 Token 轮换。
这套协议只传文本,不要求访问大模型内部的输出概率,也不要求重训大模型,因此适合探索“本地小模型 + 云端 API”的组合。不过,接口能接通与效果能迁移是两回事:换后端时仍需检查续写提示、上下文格式和训练策略是否匹配。论文实验也没有直接验证手机或 Mac 上的端云部署体验。
交接的价值,在于大模型可以利用小模型已经完成的工作。官方项目页展示了一条对数方程组求解轨迹:
 官方案例 AIME-2024 #744 的交接轨迹:蓝色小模型完成换元后发出紫色控制符,橙色大模型接续求解 | 来源:PyroDash 官方项目主页
小模型先设 a = log_2(x)、b = log_2(y)、c = log_2(z),把对数关系化为三元一次方程组,并写出目标式 |4a + 3b + 2c|。交接后,大模型沿着这份草稿求解,得到最终答案 m + n = 33。
论文还给出柠檬树盈利案例:小模型先算出年净收入 7 × $1.50 - $3.00 = $7.50,大模型再通过 7.50n > 90 区分第 12 年回本与第 13 年开始盈利。简单的花朵计数题则由小模型独立算完。这些轨迹说明两条路径如何运行,但不能单靠几个成功案例证明每次交接都发生在最佳位置。
三阶段训练:从认识控制符,到学会怎样交接
架构跑通后,核心难点在于:小模型词表里原本没有 <|llm_offload|>,怎样让它既学会这个动作,又学会权衡继续作答与调用大模型?
PyroDash 只训练小模型,大模型参数全程保持冻结。三阶段训练依次解决动作表示、行为示范和策略优化。
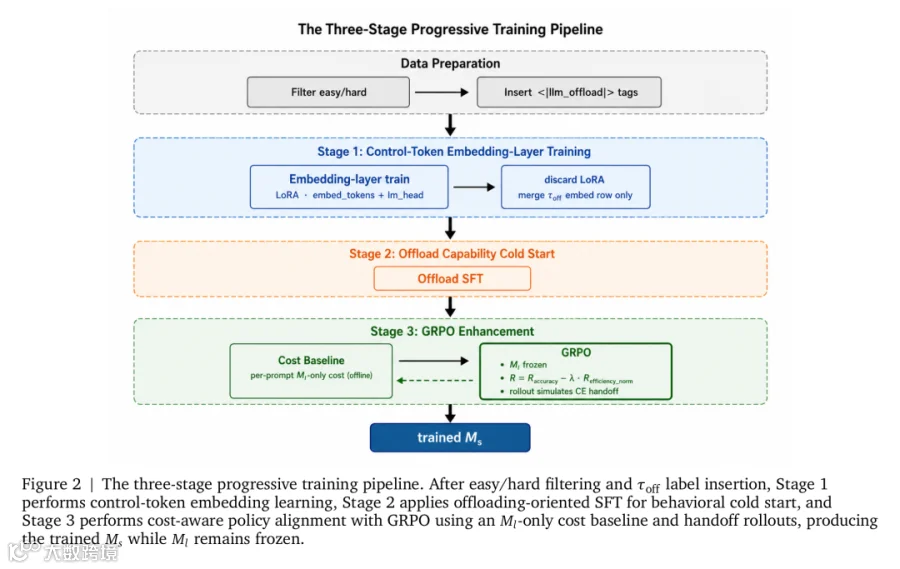 PyroDash 三阶段渐进式训练流程:从相对难度数据构造,到控制符词嵌入学习、冷启动 SFT,再到基于成本基线的 GRPO 强化对齐 | 来源:PyroDash 论文 v1,Figure 2
训练数据来自团队构建的 EasyHard-24k(24,061 条样本),按“模型相对难度”划分:直接用基础版 Qwen3.5-4B 跑每道题,答对的进 easy 子集;答错的 hard 题不直接用小模型的错误轨迹微调,而是由大模型重构出正确简洁的思维链(CoT),并在其中动态插入 1 到 4 个候选 <|llm_offload|>。这些是训练用的合成交接位置,后续还要通过奖励调整;推理时仍在首次触发后停止小模型。数据随后扩展为不含协同提示且无控制符的语料 A(保住独立解题能力),以及含协同提示 P_s 的语料 B(其中 easy 样本仍不含控制符,防止模型养成“有提示就甩锅”的习惯)。
基于这份数据,三阶段训练依次推进:
1. 第一阶段:学会表示控制符。用句号、换行符、结束符等自然断点的向量均值加噪声,初始化新控制符的输入、输出嵌入。在语料 B 上训练嵌入层、输出头和临时 LoRA 适配器;LoRA 是只训练少量附加参数的微调方法。训练后丢弃临时适配器,只保留新控制符对应的参数行,尽量保住基座能力。
2. 第二阶段:用示范建立初始行为。冻结词嵌入,用 LoRA 在语料 A+B 上做监督微调(SFT),让模型同时学习独立作答与开启协同提示后的条件性交接。
3. 第三阶段:按最终答案和成本调整策略。在 DAPO-Math 上使用群组相对策略优化(GRPO):对同一道题采样 8 条轨迹,有的独立完成,有的在不同位置交接;发生交接时,训练环境实际调用冻结大模型续写。系统根据最终答案是否正确、整条轨迹的成本,为这 8 次尝试打分,再比较组内相对表现。
关键在于第三阶段怎样算账。论文先让纯大模型回答同一道题,得到基线成本 Cost_base;再计算协同轨迹的成本 Cost_act。归一化开销与总奖励分别为:
R_eff = Cost_act / Cost_base
R_total = R_acc - λ · R_eff
其中 R_acc 是根据标准答案核验得到的 0/1 正确性奖励,λ 是训练时采用的成本惩罚权重。GRPO 不需要额外的价值评估网络,但这里的答案得分仍由核验程序给出,并非模型自己判断谁答得好。
对于发生交接的轨迹,论文式(5)使用如下紧凑成本表达:
Cost_act = (C_s + C_pre) · T_s + C_dec · T_l,dec
T_s 是交接前的小模型输出量,T_l,dec 是交接后的大模型输出量;C_s 是小模型统一 Token 单价,C_pre、C_dec 分别是大模型输入、输出单价。它突出了一笔容易漏算的钱:交接前的草稿既消耗小模型计算,又会作为大模型输入再次计费。
这不是适用于所有路径的完整账单公式。小模型独立完成时没有大模型输入费;发生交接时,原始问题和提示词也属于输入。论文将上式作为训练奖励的紧凑记账形式,评测则按小模型输入、小模型输出、大模型输入、大模型输出四项分别统计和折价。因此,“训练纳入 API 计费结构”与“实测商用 API 账单”需要分清。
同一道题的 8 条轨迹按总奖励计算组内优势,训练会提高较高奖励动作的概率、压低较低奖励动作的概率,梯度只更新小模型。更高成本会降低奖励,但是否获得负优势仍取决于组内比较,并不是开销一超过纯大模型就必然受罚。
由此,小模型学习的不只是发出控制符,还包括是否交接、交接前写多少,以及怎样让联合输出既正确又划算。
降本 96.4% 与提分 6.36 个百分点,各自付出了什么
论文最醒目的两组结果是降本 96.4%,以及准确率超过纯大模型 6.36 个百分点。它们来自不同成本权重下训练出的策略,不能合并为一个档位的成绩。λ 也不是部署后随手一拧就能改变同一模型行为的推理参数。
评估覆盖 GSM8K、Minerva、OlympiadBench、AIME25、AIME24 五项数学基准。AIME 使用每题 32 次采样的平均准确率(avg@32),其余使用贪心解码的单次准确率(pass@1),下表“平均准确率”为五项基准结果的均值。
费用均为论文按 Token 用量估算的测试集总成本,不是单题价格或实际付款账单。论文使用的每百万 Token 输入/输出单价分别为:Qwen3.5-4B 0.05/0.08 美元,GLM-5.2-FP8 0.90/2.86 美元。这是实验价格口径,不代表当前任一服务商的报价。
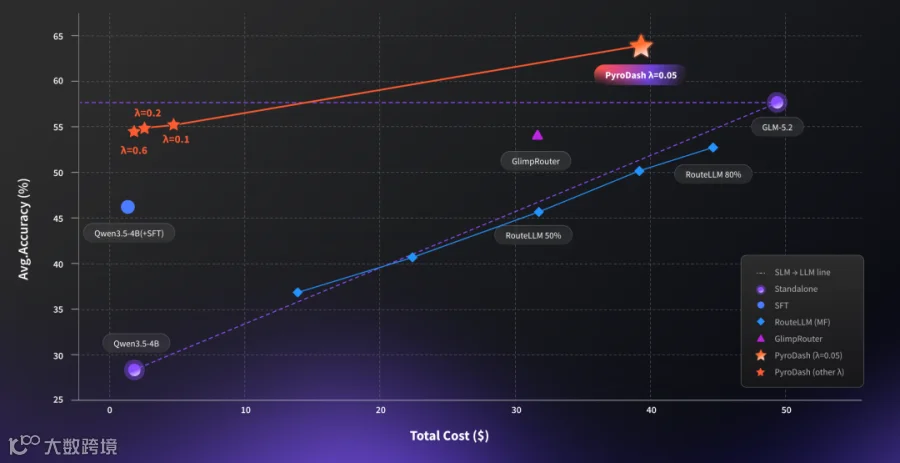 五项数学推理基准上的总成本(美元)与平均准确率(%)成本—准确率分布:橙色星号展示了 PyroDash 在 λ=0.6、0.2、0.1 到 0.05 下的表现,与 RouteLLM、GlimpRouter 及独立模型对照 | 来源:PyroMind Dynamics 官方 GitHub 仓库(对应论文 Figure 3)
把论文表 1、表 2 的主要结果压缩到同一组指标中:
“大模型输出占比”只统计解码 Token,不包含输入,所以 1.90% 不能直接读作大模型费用占比。RouteLLM 数值采用论文表 2 的配置。
省钱档 λ=0.6 的重点是少调用:至多一次交接的约束下,平均每题调用 0.012 次,对应约 98.8% 的请求由小模型独立完成。大模型输出从 1708 万降到 23 万 Token,总成本从 49.36 降至 1.78 美元,降本 96.4%,同时平均准确率下降 3.13 个百分点。它的准确率仍高于两条路由基线,但不能据此说与纯大模型完全等效。
提分档 λ=0.05 几乎反过来:约 97.5% 的请求发生交接,大模型承担 95.34% 的输出 Token。联合准确率达到 64.04%,比纯大模型高 6.36 个百分点,同时成本降低 20.4%。AIME24 上,准确率从 46.56% 提升到 63.75%。这个档位主要展示了协作的质量收益,绝大部分生成工作仍由大模型完成。
官方轨迹显示,前置换元、列式可以为大模型提供有用上下文;但这些案例还不足以把整体提升全部归因于“化简降低了大模型出错率”。SFT 小模型独立作答的 46.25%,与完整协同策略的 64.04%,也包含推理时是否调用大模型的差别,不能把全部差值都算成 GRPO 对小模型自身能力的提升。
居中的 λ=0.1 以 4.71 美元取得 55.29% 的准确率,说明训练可以得到不同折中点。工程上应先明确业务可接受的正确率,再比较相应策略的成本,而不是只挑最低账单。
从数学推理到编程 Agent,还要核对哪些边界
7 月公开数学基准模型(官方开源了 Lambda-0.6 与 Lambda-0.05 权重)后,PyroMind 在 2026 年 9 月 1 日于官方 GitHub 仓库发布了面向软件工程的 Agentic-Preview 更新:
•控制符升级为 0–9 思考档位选择:从 <|llm_offload|> 升级为 <|llm_offload|>N<|/llm_offload|>(N 为 0 到 9 的整数),小模型在交接时可动态指定大模型的思考深度档位(Thinking Level)。
•引入 OPD 蒸馏并初验编程基准:Stage 2 升级为 SFT + OPD(On-Policy Distillation,即让小模型在自己采样生成的轨迹上向大模型对齐输出分布),在 ScaleSWE 与 TMax 数据集上训练,Qwen3.5-4B 可分别搭配 DeepSeek-V4-Flash 或 GLM-5.2(下图展示了相关模型与 λ = 0.3、λ = 0.1 策略的对照);在 SWE-Bench Verified 基准上初步实现约 20% 成本节省,官方文字称准确率下降约 5%,但没有在该说明中明确这是相对降幅还是百分点;这一预览口径不与数学基准混用。
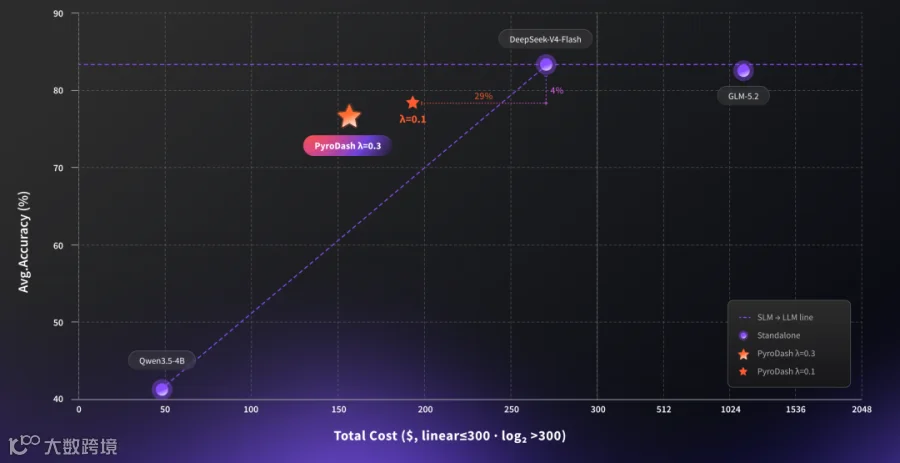 2026 年 9 月 Agentic-Preview 编程基准成本与准确率成本—准确率分布:横轴在 300 美元前采用线性刻度、之后采用对数刻度,展示两种 λ 策略与独立模型的结果 | 来源:PyroMind Dynamics 官方 GitHub 仓库
这些是仓库披露的预览进展,完整细节尚待补充。结合论文第 6 节的限制与部署条件,落地前还需核对四件事:
1. 单轮单次交接 vs 多轮 Agent 循环:7 月论文验证的是单轮至多一次单向交接;在多步工具调用的 Agent 循环中,多轮往返的上下文缓存(Prompt Caching)命中率与交接 Prefill 成本如何折算,仍需新的完整实测,9 月预览不能直接补齐这些结论。
2.
折算费用与实际部署开销:论文实验是在服务端 GPU 集群(4 张 H100 跑 Qwen3.5-4B,8 张 B200 跑 GLM-5.2-FP8,vLLM 部署)上按公开标价折算美元的。若实际采用“端侧设备跑 4B + 公网调云端 API”,需要实测小模型生成、跨网传输和云端首字等待的总延迟,并核算设备、服务和缓存费用,不能把论文的 Token 折价直接当作端云总成本。
3.
触发位置的微观归因尚未完全验证:论文统计了整体准确率与账单,但尚未逐题检验小模型发出 <|llm_offload|> 的具体 Token 位置是否严格对应其推理即将出错的临界点。论文也未单独比较归一化成本惩罚与直接 Token 成本惩罚,不能把归一化本身说成已被消融证明的增益来源。
4. 模型搭档与价格比绑定:训练数据与奖励基线针对特定大小模型的能力差及价格比定制。如果业务中更换后端闭源大模型或前端小模型尺寸,适合的交接策略可能随之改变,需要重新评估乃至训练交接策略,不能只改一个运行时参数就沿用原成绩。
对预算有限的团队,PyroDash 提供了一个具体的设计思路:让小模型的中间工作参与最终答案,并把交接带来的输入费一起纳入训练目标。它的工程价值在于用不同训练策略选择可接受的准确率与成本组合;至于能否搬进自己的业务,还要用真实请求、真实价格和真实部署条件重新算账。
参考资料
•PyroDash 论文(Cost-Efficient Token-Level Small-Large Language Model Collaborative Inference,arXiv:2607.20327v1): https://arxiv.org/abs/2607.20327
•PyroMind Dynamics 官方 GitHub 仓库与 Agentic-Preview 更新说明: https://github.com/Pyromind-Dynamics/PyroDash
•PyroDash 官方项目主页: https://Pyromind-Dynamics.github.io/PyroDash
•FrugalGPT 原始论文(请求级 API 级联): https://arxiv.org/abs/2305.05176
•EasyHard-24k 数据集(Hugging Face): https://huggingface.co/datasets/pyromind/easyhard-24k
蘑菇头表情图片来源:蚊子动漫
文章仅做学术分享,如有侵权请联系删除,非常感谢!