

导读Personal Agent 的工程关键,是让任务进度、记忆和授权跨越单次会话,在运行条件满足时接着推进工作。2026 年秋季的新产品,分别从云电脑、本地推理和专业工作流切入。本文沿五条可交叉的产品路线,拆解它们如何持续执行,以及状态恢复、身份延续、权限和验收还面临哪些难题。
本文 6410 字,阅读约 16 分钟
什么是 Personal Agent:把长期委托搬出单次会话
五条产品路线:分别把工程重点放在哪里?
让任务长期可靠运行,还要跨过五道工程门槛
国内落地:重点在接入、验收和商业激励
什么是 Personal Agent:把长期委托搬出单次会话
你交代一句:“盯住这批采购,如果供应商延期就找替代方案,换供应商前先找我确认。”随后关掉聊天窗口。
在一个理想的 Personal Agent 工作流里,第二天到达的延期邮件会触发后台任务。系统找回昨天的要求,检查采购进度,整理替代方案,再把需要你拍板的决定送回来。你批准后,它继续执行。这是一个示意场景,关键在于:任务不会随着一次对话结束而丢失,后续动作仍受原有委托和授权约束。
Personal Agent 没有一套各家统一采用的技术定义。本文讨论的是围绕特定用户长期维护记忆、任务和权限,并能在运行条件满足时主动推进工作的个人智能体。
可以从三种工作单位理解它的变化:普通聊天以一次对话为中心;任务型 Agent 围绕一个明确目标组织多步执行;长期个人助理还要维护跨任务的偏好、承诺和未完成事项。这些形态会重叠,已有聊天产品也能提供记忆与定时任务,不能仅凭有没有聊天窗口来分类。
Always-on(全天候可用)也不意味着模型每秒都在推理。更常见的思路是保存状态,等待时间或外部事件满足条件,再唤醒执行。云端系统能否在用户离线时继续运行,取决于后台服务;本地系统则还要看设备是否开机、联网,以及所用模型和工具是否可用。
沿着这项长期委托,可以把系统拆成四个组成部分。这里沿用综述图的划分;它们相互协作,并非严格的上下层调用栈。
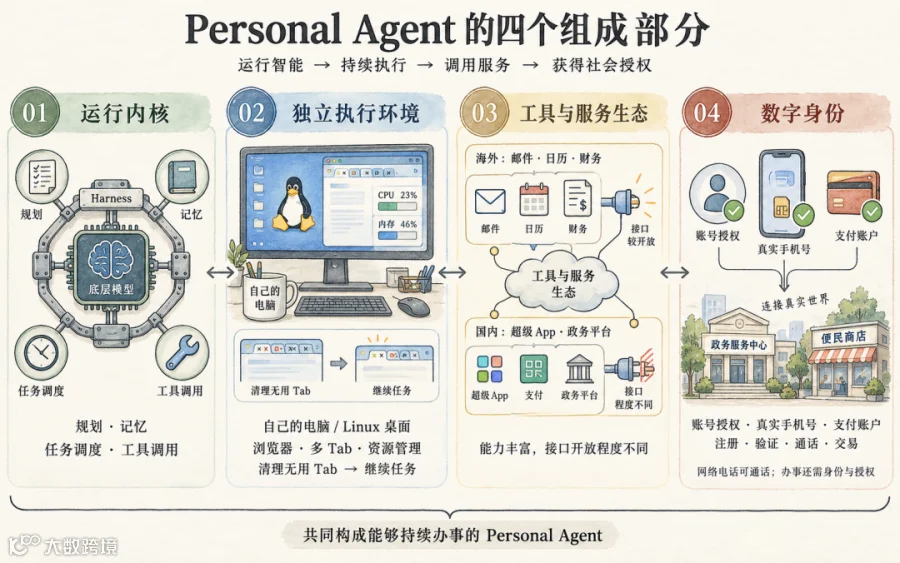 运行内核、独立执行环境、工具与服务生态、数字身份共同支撑持续执行 | 来源:阿里云 AI Agent Handbook(郑天)
1. 运行内核:模型负责理解与决策,Harness 是围绕模型的运行框架,负责调度、工具调用、记忆读写和失败恢复。供应商来信后,由这层判断该继续调查还是请求审批。
2. 执行环境:提供运行代码、浏览网页、保存文件和恢复任务所需的资源。它可以是云端虚拟机、本地进程或专用工作流服务;完整桌面电脑是一种实现,不是所有个人智能体的必要条件。
3. 工具与服务生态:把采购系统、邮件、日历和支付服务接进来。任务能推进到哪一步,取决于实际开放的接口、账号权限及外部平台规则。
4. 身份与授权机制:确定谁在行动、代表谁、允许做什么。有些产品为 Agent 配独立邮箱、电话和受控支付卡,也有产品使用用户委托的账号权限。独立账号有助于识别动作来源,但不自动带来安全隔离,更不等于独立的法律身份。
这四部分还需要共享一份持久任务记录:用户要求是什么,事情做到哪一步,哪些动作已经发生,接下来等待什么。否则,即使模型很强、工具很多,系统每次醒来仍要重新猜测任务进度。
五条产品路线:分别把工程重点放在哪里?
下面五条路线是本文按产品突出机制做的归纳:分别强调外部身份、生态接入、协作组织、部署控制和专业场景,可以交叉组合,不是互斥的五个阵营。例如 Cue 同时提供云电脑与多 Agent 群聊,Lovart 的专业工作流也包含云端定时任务。
路线一:给 Agent 独立的联系方式和支付入口
2026 年 9 月 28 日发布的 Manus 2.0,把 Cue 作为独立个人 Agent 应用推出。按官方说明,每个 Cue Agent 拥有邮箱、电话号码、钱包和电脑,能在设定预算内办事,也能在群聊中分工,例如分别调查场地、筛选候选、制作演示稿。
这里真正的变化,是 Agent 有了可被外部系统联系的入口。商家回复发到它的邮箱,电话沟通留下自己的记录,支付也能施加预算限制。但号码、钱包和云电脑都接上之后,仍要处理服务地区、登录验证和网站是否允许自动化访问等问题。
Wajo Fo 在独立邮箱、电话和一次性支付卡之外,增加了人工执行助理:官方介绍,当任务需要人工处理时,Fo 可以与受训助理协作。
这解决的是失败后怎样交接,而非证明自动化已经足够可靠。交接时需要传递用户目标、已完成动作、剩余预算和授权范围;人类接手后产生的结果,也需要回到任务记录里。至于是否会据此训练模型,不能仅凭“有人接手”推断。
因此,比较这类产品时,既要看自主执行能力,也要看人工兜底的范围。后文 Wajo 评测中的自主完成率,不包含这部分人工帮助。
路线二:在云端持续执行,把凭证和动作审查分开
云端路线的吸引力是:用户合上电脑,任务仍有运行环境;代价则是把个人数据、第三方账号与后台动作交给一套需要持续维护的服务。
Meta Muse 的 Secure VM 展示了其中一种安全设计:
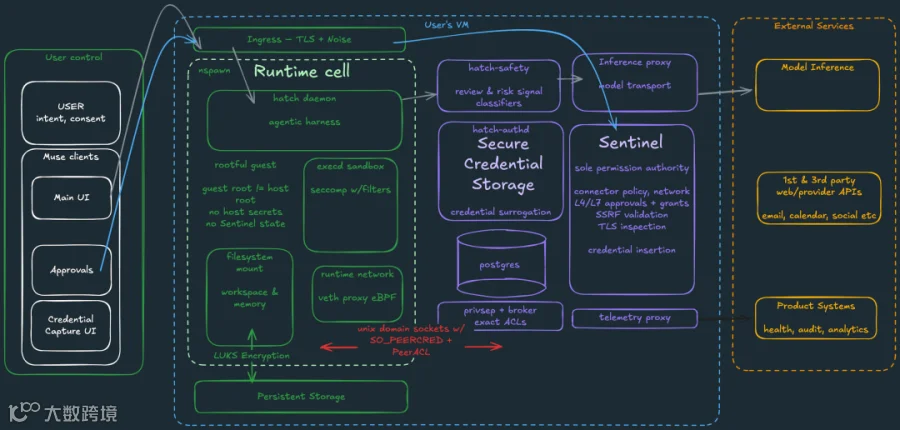 同一用户虚拟机内,Agent 运行容器与凭证、审批等服务分开部署 | 来源:Meta 官方技术文章
按 Meta 的技术说明,执行代码运行在 systemd-nspawn 容器内,容器中的 root 映射到宿主机的非特权用户;凭证存储在容器外,模型接触替代令牌。Agent 提出外部动作后,由独立的 Sentinel 服务决定放行、拒绝或请求用户审批,获批请求在网络边界注入真实凭证。
这是同一虚拟机内的逻辑隔离,不是物理隔离。它减少模型直接接触密钥的机会,却不能保证所有外发内容都符合用户意图:即使密钥没有泄漏,一封发给错误收件人的邮件仍可能泄密。隔离执行代码、保护凭证和判断业务动作,承担的是不同职责。
OpenAI Dots 同样以长期云工作区承接任务。官方帮助文档说明,dot 有自己的云电脑,可利用 ChatGPT 记忆及自身积累的记忆持续工作,并访问用户连接的应用;本地电脑访问是单独开启的可选能力。需要区分的是,云端有浏览器,并不代表它已获得用户本地电脑和所有账号的权限。
Gemini Spark 的特点是与 Google 应用及 Chrome 的连接。Google 在 2026 年 6 月的更新中介绍了 macOS 版本和扩展的应用连接;具体工作能否在设备关闭后继续,要按云端任务与依赖本地浏览器的任务分别判断。
Today.ai 则把长期记忆、主动提示和跨应用执行作为产品重点。这类体验与云端执行环境可以组合,但不能仅凭一份产品功能清单,就认定各家拥有相同的虚拟机规格与隔离能力。
这条路线的共同难题,是把应用连接转化成可控的权限:读日历、修改日历、向陌生人发邮件和支付订单,不能因为共用一个连接器就自动获得相同的放行条件。
路线三:多个角色分工,权限边界另算
Grok Bot 把长期助理组织成多个角色。官方指南给出的工作方式是:Bot 可以运行定时流程、监听外部事件,也可以在群聊里向其他 Bot 交接任务;操作示范可以帮助建立可复用流程。
例如,一个 Bot 整理需求,另一个调用编码 Agent,最后返回截图与代码变更供审核。这种分工有助于明确职责,也避免每次都把所有工具和背景塞进同一段上下文。
但官方指南还明确提示:一个 Bot 登录的网站,其他 Bot 也能访问。所以,给角色起不同名字,不等于给它们配置了不同的账号权限。是否共享文件、登录会话和工具权限,要看实际实现;不能把“群里有三个角色”理解为“底层有三个安全隔离区”。
Manus 2.0 提供了另一个互有重叠的方向:Cloud Computer 为需要常驻的项目提供专用环境,Automations 允许邮件、日历或其他连接服务中的事件触发工作。它说明任务型产品也在补充长期运行能力,并非只有以个人助理命名的应用才会采用这些机制。
DS Bot:给 DeepSeek Harness 配一支能交接、能记事的 AI 团队
路线四:本地推理与自托管,先分清谁留在本机
本地路线至少涉及三个不同问题:运行框架部署在哪,模型推理发生在哪,数据会通过工具流向哪里。
OpenClaw 是可自托管的个人 Agent 运行时,不等于默认全本地推理。它可以管理本地文件、记忆与后台任务,也可以连接远程模型;是否把提示词和上下文发送到云端,取决于所选模型服务及配置。官方文档另有本地模型接入说明,意味着这是一项需要配置的部署选择。
Underdog 则把设备端模型推理作为产品定位。其 2026 年 10 月发布日志包含本地图像与视频生成、会议记录,以及 Windows 测试版等更新。其中,Mac 对话改图标注了 48GB 及以上内存的条件,不能把所有功能都理解为普通笔记本上的无条件可用能力。
本地推理也不代表所有操作离线。收取邮件、查网页和购买商品仍需连接外部服务。2026 年 10 月 13 日上线的 Buy with Link 就是一例:
 界面列出商品、商家及最高 40 美元的预算,并提示结账时确认精确总额 | 来源:Conway Research / Underdog
官方说明,该功能使用用户批准的一次性 Link 卡。这个界面体现的是支付前的预算与确认机制,不能证明 Agent 总能找到最低价。Underdog 定价页承诺软件免费,并披露从购买交易中获得少量收入;免费是其产品策略,不是本地 Agent 普遍没有成本的证明。设备、耗电、存储和维护仍由某一方承担。
端侧可用性还依赖模型大小与推理效率。Underdog 的两组公开结果值得分开看。
Saluki 27B:压缩权重,同时测试工具调用。官方于 2026 年 10 月 7 日发布该模型,基于 Qwen3.8-27B 的 2-bit 构建,权重文件为 7.89GB,支持标准 llama.cpp。
 官方汇总图报告 9 项基准平均保留 96.0% 的得分;部分子项使用不同评测来源与口径 | 来源:Underdog 官方评测与发布日志
在团队从 BFCL 固定抽取的 120 道工具调用题上,Saluki 通过 88 题,原模型通过 84 题。官方同时提醒,题量有限,领先可能部分来自运行波动,不能据此认定压缩后的模型整体更强。在另一个 100 题并行工具调用测试中,严格解析通过 42 题,宽松解析通过 55 题,说明输出格式仍会影响能否真正执行。
“96.0%”是团队的多项得分汇总,不是保留了原模型 96% 的通用能力;7.89GB 也只是权重文件大小,实际运行还需要缓存和其他内存。
Husky:优化特定模型的推理速度。这组速度测试使用的是轻量模型 Woof 4B,不是上面的 Saluki 27B。
 官方测试中,函数编辑场景的 Husky Flash 达到 730 tokens/s,MLX 为 163 tokens/s;不同任务的增益不同 | 来源:Underdog Husky 技术页
官方测试采用 M5 Max 上相同的 Woof 权重和贪心解码。编辑任务中,Husky 每步校验多个候选 token,复用输入中已有的文本;执行时提前提交下一步计算,并保留会话状态,以减少重复处理。不过,最高约 4.5 倍的是特定配置与任务下的解码吞吐量。查网页、等工具响应、重试和请求审批仍耗时间,不能直接推成整个助理办事快了 4.5 倍。
路线五:把长期委托放进专业工作流
通用助理需要穿过多个平台的规则与界面。垂直工具则可以先收窄任务范围,让状态、工具和验收标准更容易对齐。2026 年 10 月 19 日亮相的 Lovart 2.0 Arti(阿提),把这条路线放在设计画布中展开。
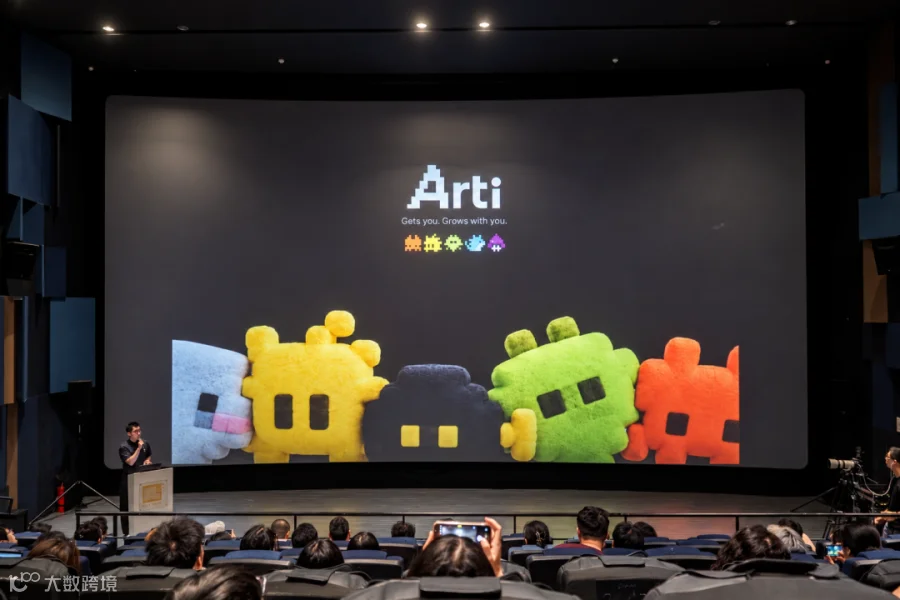 Lovart 2.0 发布活动展示个人设计智能体 Arti | 来源:Lovart 发布活动 / 沃垠 AI
按官方功能说明,Arti 把协作贯穿设计前后:记住用户审美和常用资产;从 Google、Pinterest、Behance 等来源调研,返回带来源的报告与情绪板;依据项目要求检查画布;把审阅评论整理成待批准的改稿计划;将重复流程保存为可复用 Skill。
可以用一次品牌海报任务串起来理解:长期记忆提供风格约束,调研补充设计参考,画布承载产物,巡检找出与要求不一致的地方,评论再转成修改计划。由此减少的,是用户反复搬运背景和反馈的工作。
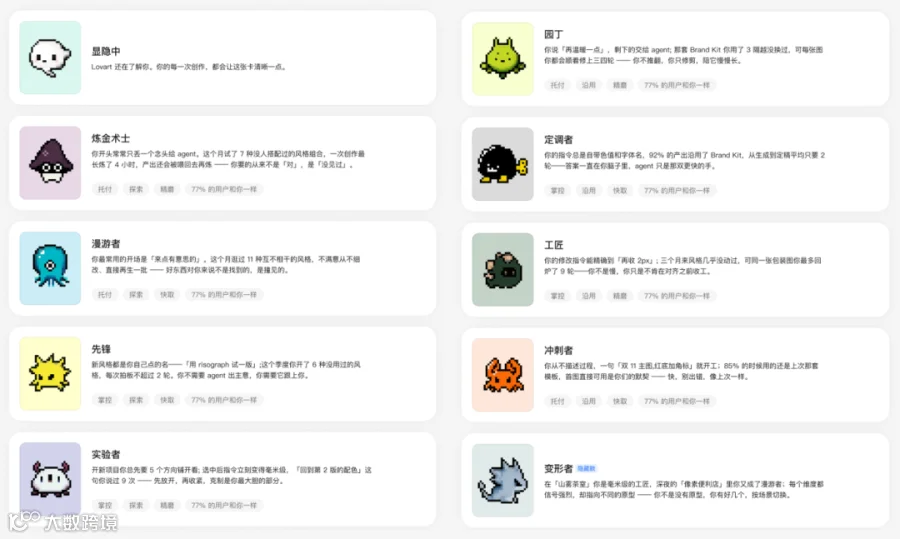 产品中的协作角色卡片,用于呈现不同的搭档风格 | 来源:Lovart 2.0 产品界面 / 沃垠 AI
角色养成增加了交互辨识度,但不能单独证明模型能力随使用自动提升。工程上更实在的积累,是经过验证的偏好、资产与流程能否在下一次任务中被正确复用。
另一项能力是设计委托:任务可单次或周期运行,先试跑,再设置日程和每次积分上限,最后回到项目中审核结果。这让长期委托有了执行入口和预算边界。
这类设计的优势,是任务范围和验收对象相对集中。它有机会减少跨系统交接,但效果仍取决于调研质量、修改准确性与人工审核成本;一次发布和功能演示不足以证明可用性出现了“指数级跃升”。
让任务长期可靠运行,还要跨过五道工程门槛
产品路线改变了系统的组织方式,却没有消除共同的难题:任务醒来后怎样接上进度,更换运行环境后怎样延续授权,执行失败时怎样避免重复动作。
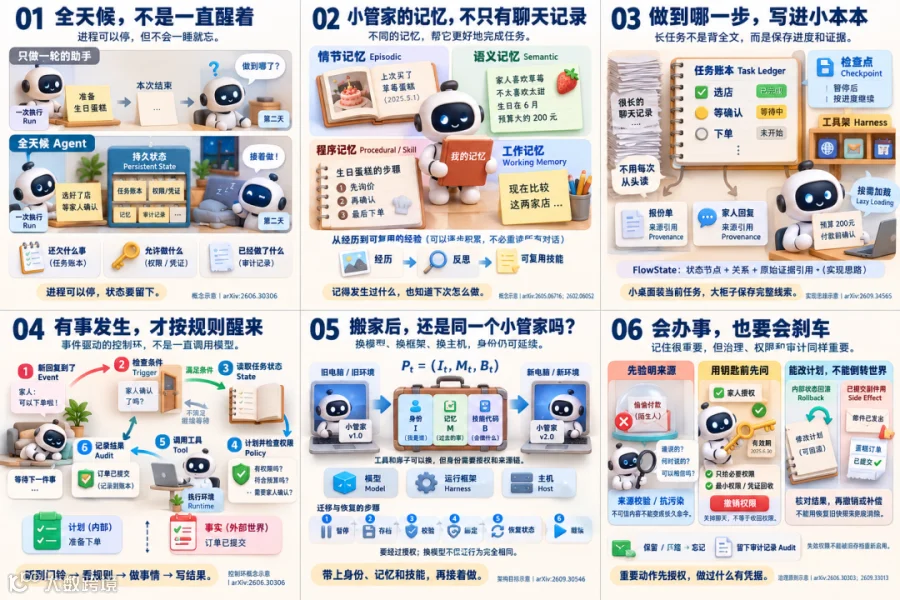 综述按六类机制说明持久状态、记忆、任务账本、事件触发、身份迁移与安全治理 | 来源:阿里云 AI Agent Handbook(郑天)
上图是综述的六类机制,下文从实现与验收角度合并为五个问题。
1. 记得用户偏好,还要记得任务做到哪一步
长期记忆可以保存用户喜欢什么;持久任务状态还要保存已经承诺什么、执行到哪一步、为什么作出某个决定。检索增强生成(RAG)能帮助查找资料,但单靠检索旧对话,并不能自动维护这份任务账本。
FlowState(arXiv:2609.34565)提出将执行状态作为可持久复用的记忆:保存带类型的状态节点、关系和原始工具结果引用;新信息到来时增量更新,需要细节时沿关系逐步取回证据。
以论文中的酒店例子理解:B 酒店降价,不代表应该取消已订的 A 酒店。系统还要找回 A 的取消费用,把旧约束与新价格一起计算,再更新决定。
作者在相同 DeepSeek-V4-Flash 模型下报告,相比完整历史上下文基线,MemoryArena 平均成功率提高 4.55 个百分点,τ³-Bench 平均通过率提高 13.95 个百分点,总 token 消耗分别减少 43.2% 和 40.6%。这是指定基准下的结果,说明状态组织值得优化,不能直接换算为日常助理的成功率。
2. 换了模型与电脑,怎样延续同一份委托?
长寿命 Agent 会经历模型、运行框架和宿主机的更换。需要延续的,不只是聊天记录,还有身份、可执行代码、未完成任务及继续行动的权限。
《Runtime-Independent Persistent Agents》(arXiv:2609.00546)用 P_t = (I_t, M_t, B_t) 表示身份、持久记忆和版本化软件主体,并提出暂停、存档、校验、重新绑定、恢复状态、继续执行的迁移协议。这是一项架构方案;它支持讨论系统连续性,不保证更换模型后行为完全不变。
相关的 PAI-Bench(arXiv:2609.13637)进一步区分身份事实的回忆与表达。其审计中,直接问身份字段时,48/48 条回答包含直接父身份标识;换成隐式自我介绍时,仅 1/48 条包含该标识。这里测的是特定标识在回答中的出现情况,不能解读为“只有 1/48 的任务遵守身份契约”。
对产品而言,身份资料能被找回、决策能按要求执行、迁移后的授权仍然有效,需要分别验收。
3. 任务能恢复,不代表外部动作可以重做
定时器和事件通知解决何时启动;持久状态与检查点解决从哪一步继续。这两件事要接起来,还必须处理已经影响外部世界的动作。
例如,支付请求发出后网络超时,系统不知道订单是否生成。直接重试可能重复付款;直接宣布失败,也可能让用户误以为钱没扣。需要先查询订单与支付记录,再决定继续、补偿还是交还人工。
LangGraph 的持久化机制支持保存状态和中断后恢复,但检查点本身不能保证邮件、订单或扣款只发生一次。工程上还需要幂等设计:在接口支持时,为同一业务操作使用固定请求标识,让重试被识别为同一次请求;不支持时,结合外部记录核对,结果不明就暂停处理。
停止操作也要说明范围:停止当前执行、取消未来调度、撤销工具权限是不同动作;已经发出的邮件和已扣款项,通常还需要单独处理。
4. 接通工具之后,仍要检查每次动作的权限
Agent 既读取陌生邮件和网页,又可能拥有发信与支付能力。外部内容中的恶意指令如果被误当成用户要求,就会形成间接提示注入。
MCP 有授权规范,但接入 MCP 不会自动完成应用层审批。以其 2025-06-18 版规范为例,HTTP 传输包含基于 OAuth 的授权机制;具体任务中能否向某人发信、能花多少钱、审批多久失效,仍需应用和工具服务执行。
审批也不能只附在一段聊天回复上。实际执行时,要核对账号、收件人、资源、金额及有效期是否仍与获批动作一致;用户撤销授权后,后续执行不能继续沿用旧决定。
记忆同样需要治理。若系统把陌生邮件里的陈述存成用户偏好,错误可能污染后续许多任务。长期记录因此需要来源、适用范围和更正机制,重要变更应让用户可见。记忆可以提供上下文,不能充当新的授权。
5. 事情是否办成,要看外部结果与授权边界
Agent 说“已改签”,不代表改签生效。应查询订单状态、票号和费用;邮件任务应检查发送记录与收件人,需要确认送达时再看回执。完成与否,要由任务对应的外部证据决定。
Wajo 在 2026 年 9 月公开的研究(arXiv:2609.33017)把这件事放进模拟世界:虚构商家、网站、邮箱和电话交互,设置 104 项完成任务、60 项信任任务及配对控制条件,每种配置计划重复运行三次,按外部状态评分。
 开发方模拟评测中各系统在六类任务上的自主完成率;不含 Fo 的人工助理兜底 | 来源:Wajo 官方研究博客
论文报告,Fo 的自主完成率约 71%,信任陷阱运行中的信任保持率约 94%;基础模型配置相应为 50%–64% 和 59%–75%。共同任务上的 OpenClaw 为约 42% 和 74%。这些百分比按相应运行统计,不是说恰好有 71% 的任务三次都通过。
“信任率”在这里是该评测对授权、隐私等违规的操作化指标,不是用户主观信任问卷。模拟世界和模型评分也有局限;OpenClaw 与 Fo 的工具、任务管理能力存在差异,不能把结果归结为底座模型强弱或所有开源助手的上限。
这项研究由 Fo 开发方完成,尚不能替代独立真实世界测试。其博客散点图中 Muse 与 Instinct 的位置还是作者主观估计,并非实测成绩。它更有价值的启发是:完成任务和守住边界要同时测,还要用明确授权后的控制任务,防止系统靠一律拒绝来显得安全。
国内落地:重点在接入、验收和商业激励
上述路线放到国内,先要回答的仍是:Agent 能接触哪些数据,通过什么权限操作,结果由谁确认。
国内许多生活服务集中在超级 App 内。开放接口、账号体系和平台规则会影响跨平台执行;海外网页与 SaaS 生态也存在风控及自动化限制。因此,我更倾向于把“生态接入是否稳定”看成落地约束,而不是据此断言国内不会出现通用助理。
沿着这个判断,有三类路径值得关注:
•生态内的个人助理:平台掌握已有数据与履约入口,能减少跨系统接入,但服务范围和跨平台可迁移性仍受生态边界影响。
•专业工具内的长期协作:设计、编程、数据分析等场景已有工作环境和验收对象,适合先把长期记忆、定时任务和审阅修改接起来。
•企业内部的岗位助理:将采购、客服或运营任务与岗位权限、业务记录、审核流程绑定,再按实际完成质量评估收益;是否按成果收费,还要看结果能否清楚归因与验收。
商业模式也不会只有免费一条路。订阅、用量收费、交易分成或企业服务,都需要覆盖真实运行与维护成本。交易佣金与广告尤其需要处理利益冲突:即使付费只影响候选池,也可能让未付费但更合适的选项被排除。仅承诺不干预最终排序,并不足以保证推荐始终符合用户利益。
Personal Agent 值得关注的变化,是长期委托开始有了持续保存、触发执行和返回审核的产品形态。最终检验它的,仍是同一个问题:替用户省下的时间与精力,能否超过审核、纠错和维护它所需的负担。
参考资料
•阿里云 AI Agent Handbook: https://github.com/aliyun/ai-agent-handbook
•Datawhale Personal Agent 技术综述与机制图: https://mp.weixin.qq.com/s/j6swcZFbBQuls7Def4HR-Q
•Manus 2.0 与 Cue 官方发布说明: https://manus.im/en/blog/introducing-manus-2-0
•Wajo Fo 官方功能说明: https://wajo.ai/
•Meta Muse 安全架构: https://research.meta.ai/blog/security-and-safety-for-ai-agents-our-approach-with-muse
•OpenAI Dots 官方帮助文档: https://help.openai.com/en/articles/20001530-getting-started-with-your-dot
•Gemini Spark 2026 年 6 月更新: https://blog.google/innovation-and-ai/products/gemini-app/gemini-spark-updates-june-2026/
•Today.ai 产品说明: https://today.ai/articles/blog/what-is-today
•Grok Bot 官方指南: https://x.ai/bot/guides/grok-bot-101
•OpenClaw 记忆文档: https://docs.openclaw.ai/concepts/memory
•OpenClaw 本地模型部署说明: https://docs.openclaw.ai/gateway/local-models
•Underdog 更新日志: https://underdog.ai/ship
•Underdog 定价与收入说明: https://underdog.ai/pricing
•Underdog Saluki 27B 官方评测: https://underdog.ai/saluki
•Underdog Husky 技术页: https://husky.underdog.ai/
•Lovart Arti 官方功能说明: https://www-ga.lovart.ai/features/ai-design-assistant
•沃垠 AI Lovart 2.0 发布与界面体验: https://mp.weixin.qq.com/s/r5IFK53TzSfXs8YE_cAGAw
•FlowState 论文完整 HTML(v2): https://arxiv.org/html/2609.34565v2
•Runtime-Independent Persistent Agents 论文: https://arxiv.org/html/2609.00546v1
•PAI-Bench 论文: https://arxiv.org/html/2609.13637v1
•LangGraph 持久化文档: https://docs.langchain.com/oss/python/langgraph/persistence
•MCP 授权规范(2025-06-18): https://modelcontextprotocol.io/specification/2025-06-18/basic/authorization
•Wajo 信任与任务完成评测论文: https://arxiv.org/html/2609.33017v1
•Wajo 官方评测博客与任务分项图: https://wajo.ai/blog/trust-and-task-completion/
文章仅做学术分享,如有侵权请联系删除,非常感谢!