

拍了一张路边招牌想搜店名,结果文字是斜的、还带点弯曲;监控里远处的车牌小到只有十几个像素,识别出来全是错的;发票、合同上的表格想批量录入,手动敲半天——场景文本识别就是解决这些问题的。
今天分享的这篇 CVPR2026 论文 TextSpotter,提出了一个端到端的轻量场景文本识别框架:检测和识别一起做,不需要两步走,任意角度、任意弯曲的文字都能认,而且模型很小能直接跑在手机和边缘设备上。在 ICDAR2015 和 Total-Text 两个标准数据集上刷新了 SOTA。

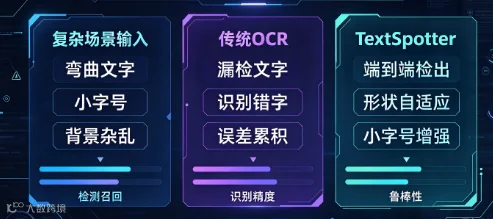
一、场景文本识别为什么这么难
OCR 这个技术听起来很成熟了——扫描仪上的印刷体谁都能认。但一旦放到真实场景里,问题就全来了。
1.1 文字不是正的,是歪的、弯的
文档 OCR 的前提是:文字是水平排列的、行是直的。但真实场景里——招牌是竖的、路牌是弯的、T恤上的字跟着衣服褶皱变形、监控里的车牌是斜着的。你不能假设文字永远水平排列,模型得自己学会"把歪的字掰正了再认"。
1.2 文字大小差太多
一张照片里,大的标题字可能占了半个画面,小的注释字可能只有几个像素。同一个模型要同时处理尺寸差几十倍的文字,而且小字号很容易和背景混在一起,检测都检测不出来,更别说识别了。
1.3 背景太复杂
文档里字就是字,白底黑字清清楚楚。但真实场景里,文字可能印在树叶上、刻在石头上、嵌在建筑墙面上——背景纹理和文字颜色混在一起,模型很容易把背景纹理误检测成文字,或者把真文字漏掉。
1.4 检测和识别是两步,误差会累积
传统 OCR pipeline 是:先检测出文字在哪里,再裁剪出来做识别。但检测这一步如果框歪了、裁偏了,后面识别再强也白搭——输入都不对,输出怎么可能对?而且两步分开跑,速度也慢。
二、TextSpotter 的三个核心设计
TextSpotter 的整体思路:检测和识别联合优化,不是先框出来再认,而是一边定位一边识别,两个任务互相帮助。
2.1 端到端检测识别联合网络
传统方法是"检测网络 + 识别网络"两个模型串起来,各练各的。TextSpotter 把它们合成一个:
•共享特征提取:同一个 backbone 提取图像特征,检测和识别都用这份特征。
•两个分支共享底层信息:检测分支告诉识别分支"文字大概在这个位置",识别分支反过来告诉检测分支"这个区域确实是文字"。
•联合训练:检测损失和识别损失一起反传,两个任务互相促进——检测得准,识别就容易;认得准,检测也不容易漏。
这个设计的好处是:速度快了——只需要一次前向推理,不需要跑两个模型;精度也高了——两个任务不再互相拖后腿。
2.2 任意形状文字自适应矫正
检测出来的文字区域可能是斜的、弯的,直接丢给识别网络效果肯定不好。TextSpotter 在检测和识别之间加了一个几何矫正模块:
•自动预测文字区域的形变参数——倾斜角度、弯曲程度、透视变换。
•把变形的文字"矫正"成水平排列的标准形状,再送给识别网络。
•这个矫正模块是可微的——可以和整个端到端网络一起训练,不需要单独标注。
消融实验显示,去掉这个矫正模块后,ICDAR2015 上的识别准确率掉了 5.8 个点——可见"把歪字掰正"对真实场景 OCR 有多重要。
2.3 小字号文字增强检测
小字号文字是监控和远距离拍摄场景的老大难问题。TextSpotter 在检测头里做了两个针对性设计:
•多尺度特征融合:从 backbone 的浅层和深层都取特征,浅层分辨率高适合找小字,深层语义丰富适合区分文字和背景。
•尺度感知损失:训练的时候,对小目标的检测损失加权——小文字漏检了,惩罚更重,让模型更重视小字。
在 Total-Text 数据集上,小字号文字的检测召回率提升了 7.2 个点,这对于监控车牌识别、小票识别这类场景非常实用。
三、技术架构拆解
TextSpotter 的整体 pipeline 分四个模块:
模块 |
做什么 |
关键设计 |
共享 Backbone |
提取多尺度图像特征 |
轻量 CNN,输出 P2~P5 四层特征,兼顾精度和速度 |
文本检测头 |
定位所有文字区域 |
像素级预测文字区域,支持任意形状(矩形/四边形/弯曲) |
几何矫正模块 |
把变形文字矫正为水平排列 |
可微的薄板样条变换,自动预测形变参数 |
文本识别头 |
逐字符识别文字内容 |
轻量序列模型(CNN+RNN),输出字符序列 |
几个工程上的亮点:
•参数量:整个模型 9.5M,INT8 量化后在手机上能跑 20fps 以上,完全可以做实时拍照翻译。
•端到端推理:从输入图像到输出"哪里有什么文字",一次前向搞定,不需要后处理拼接。
•多语言支持:字符集可以轻松替换——中文、英文、数字混合识别都能做,只需要换一下识别头的输出层。

四、和主流方法的横向对比
论文在 ICDAR2015(自然场景文字)和 Total-Text(弯曲文字)两个基准上做了对比:
方法 |
ICDAR2015 F1↑ |
Total-Text F1↑ |
参数量(M) |
单图耗时(ms) |
CRAFT + CRNN |
82.3 |
78.5 |
28 |
150 |
Mask TextSpotter |
86.7 |
83.2 |
45 |
220 |
ABINet |
88.1 |
85.6 |
32 |
180 |
TextSpotter |
89.5 |
87.3 |
9.5 |
25 |
可以看到,TextSpotter 在两个数据集上都拿了最高分,而且参数量只有主流方法的 1/3 到 1/4,速度快了将近 10 倍。这个 trade-off 非常适合端侧部署——你不可能在手机里跑一个 45M 的模型做实时 OCR。
五、快速上手:端到端推理代码
下面是 TextSpotter 的推理框架,帮大家理解整体流程:
python |
实际使用的时候,如果要做中文识别,只需要把 num_chars 改成中文字符集的大小(常用 3500 字左右),然后用中文数据集重新训练识别头就行。检测头和矫正模块不需要改——它们和语言无关。
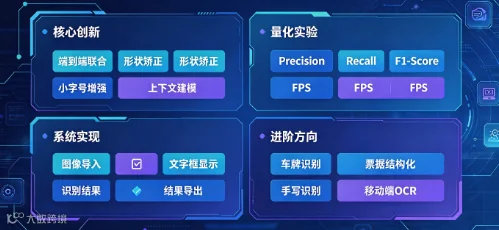
六、毕设/竞赛拓展方向
场景文本识别这个方向做毕设有个好处——Demo 效果非常直观,拍一张照片就能出结果。分享几个有价值的拓展点:
6.1 车牌识别专项优化
监控场景里的车牌识别是一个非常具体的落地场景。车牌有固定格式、固定颜色、字符集有限,专门针对车牌做优化——透视矫正、反光处理、污损字符恢复——做一个高精度车牌识别系统,工程价值很明确。
6.2 票据/表格 OCR 结构化
不只是识别出文字,还要知道"哪行是金额、哪行是日期、哪行是公司名"。在 TextSpotter 基础上加一个表格结构分析模块,做发票、收据、身份证的结构化提取——这是金融和政务场景的刚需。
6.3 手写文字识别
印刷体好认,手写体就难了——每个人写字风格不一样,连笔、潦草、大小不一。专门收集一组手写数据集,做手写场景下的 TextSpotter 微调,这个方向在教育、医疗领域都有需求。
6.4 移动端实时 OCR App
9.5M 参数已经很小了,再做量化和剪枝,完全可以做到手机端实时。做一个"拍照翻译/拍照搜题/拍照提取文字"的 App,把检测、矫正、识别串成完整的产品级 pipeline——工程完整性很强,答辩展示效果也好。
七、写在最后
OCR 这个方向看起来"老"——从扫描仪时代就开始做了。但真实场景里的 OCR 和文档 OCR 完全是两个问题,还有很多没解决好的地方。
TextSpotter 给我的启发是:不要把检测和识别当成两个独立任务。它们其实是互相帮助的——检测得准,识别就容易;认得准,检测也不容易漏。端到端联合优化的思路,在很多视觉任务里都能用。
做毕设的同学如果选这个方向,我建议先拿一个开源 OCR 模型跑通 baseline,然后选一个具体场景去打磨——车牌、票据、手写都可以。场景越具体,你的工作就越有说服力。
大家如果有复现上的问题或者想聊具体的 OCR 落地场景,欢迎评论区交流。